
Sequoiadb该如何选择合适的SQL引擎
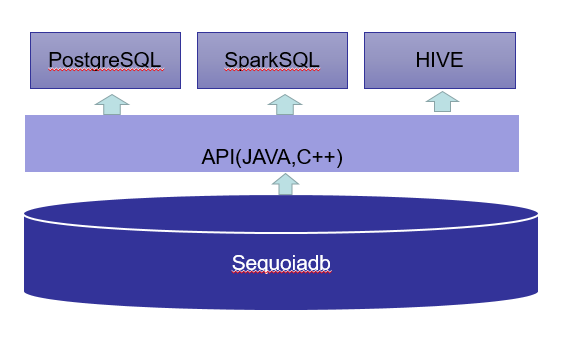
Sequoiadb作为一个文档型NoSQL数据既可以存储结构化数据也可以存储非结构化数据,对于非结构化数据只能使用原生的API进行查询,对结构化数据我们可以选择使用原生的API和开源SQL引擎,目前PostgresSQL,Hive,SparkSQL都可以作为Sequoiadb的SQL引擎,应用中该如何选择?

Sequoiadb该如何选择合适的SQL引擎的更多相关文章
- Mysql选择合适的存储引擎
Myisam:默认的mysql插件式存储引擎.如果应用是以读操作和插入操作为主,只有很少的更新和删除操作,并且对事务的完整性.并发性要求不是很高,那么选择这个存储引擎是非常合适的.Myisam是在we ...
- MySQL如何选择合适的引擎以及引擎的转换。
我们怎么选择合适的引擎?这里简单归纳一句话:"除非需要用到某些InnoDB不具备的特性,并且没有其他办法可以替代,否则都应该优先选择InnoDB引擎." 除非万不得已,否则不建议混 ...
- Android研究之为基于 x86 的 Android* 游戏选择合适的引擎具体解释
摘要 游戏开发者知道 Android 中蕴藏着巨大的机遇. 在 Google Play 商店的前 100 款应用中,约一半是游戏应用(在利润最高的前 100 款应用中.它们所占的比例超过 90% ...
- 为基于 x86 的 Android* 游戏选择合适的引擎
摘要 游戏开发者知道 Android 中蕴藏着巨大的机遇. 在 Google Play 商店的前 100 款应用中,约一半是游戏应用(在利润最高的前 100 款应用中.它们所占的比例超过 90%). ...
- 谈谈数据库中MyISAM与InnoDB区别 针对业务类型选择合适的表
MyISAM:这个是默认类型,它是基于传统的ISAM类型, ISAM是Indexed Sequential Access Method (有索引的顺序访问方法) 的缩写,它是存储记录和文件的标准方法. ...
- 六大主流开源SQL引擎
导读 本文涵盖了6个开源领导者:Hive.Impala.Spark SQL.Drill.HAWQ 以及Presto,还加上Calcite.Kylin.Phoenix.Tajo 和Trafodion.以 ...
- 六大主流开源SQL引擎总结
本文涵盖了6个开源领导者:Hive.Impala.Spark SQL.Drill.HAWQ 以及Presto,还加上Calcite.Kylin.Phoenix.Tajo 和Trafodion.以及2个 ...
- 重磅开源 KSQL:用于 Apache Kafka 的流数据 SQL 引擎 2017.8.29
Kafka 的作者 Neha Narkhede 在 Confluent 上发表了一篇博文,介绍了Kafka 新引入的KSQL 引擎——一个基于流的SQL.推出KSQL 是为了降低流式处理的门槛,为处理 ...
- 6大主流开源SQL引擎总结,遥遥领先的是谁?
根据 O’Reilly 2016年数据科学薪资调查显示,SQL 是数据科学领域使用最广泛的语言.大部分项目都需要一些SQL 操作,甚至有一些只需要SQL.本文就带你来了解这些主流的开源SQL引擎!背景 ...
随机推荐
- I.MX6 make menuconfig进入x86模式
/************************************************************************ * I.MX6 make menuconfig进入x ...
- Unity物体上下反复漂浮效果
using UnityEngine;using System.Collections;// 主界面的开始按钮使用该脚本,控制上下来回浮动public class Floating : MonoBeha ...
- Python collections系列之双向队列
双向队列(deque) 一个线程安全的双向队列 1.创建一个双向队列 import collections d = collections.deque() d.append(') d.appendle ...
- WPF开发中Designer和码农之间的合作
想要用WPF做出一流的软件界面, 必须要Designer和码农通力合作.理想的情况是平时并行开发,Designer用Expression套件(包括Design和Blend)来设计界面,码农开发Mode ...
- Makefile生成
安装:sudo yum install automake使用: 1 运行autoscan生成两个文件:autoscan.log和configure.scan.将configure.scan重命名为co ...
- 关于移动端的一些tip
移动端的一些tip 开发相关 关于viewport <meta name="viewport" content="name=value,name=value&quo ...
- String是基本的数据类型吗?
String不是基本的数据类型,是final修饰的java类,java中的基本类型一共有8个,它们分别为: 1 字符类型:byte,char 2 基本整型:short,int,long 3 浮点型:f ...
- Rails的静态资源管理(二)—— 如何使用 Asset Pipeline
官方文档:http://guides.ruby-china.org/asset_pipeline.html http://guides.rubyonrails.org/asset_pipeline.h ...
- Java 的三个注释
单行注释 // 这是名为 a 的类 class a{ } 多行注释 /* 这是多行注释 可以注释多行 */ class a{ } 文档注释 /** 这是文档注释 可以注释多行 */ class a{ ...
- QT5提示can not find -lGL的解决方法
这是由于 Qt5.0 默认将OpenGL加入了工程,但是在机器上没有安装OpenGL,所以jonas只需要在机器上安装OpenGL即可 . 安装建立基本编译环境 首先不可或缺的,就是编译器与基本的 ...