
Fasttext原理
fastText 模型输入一个词的序列(一段文本或者一句话),输出这个词序列属于不同类别的概率。
序列中的词和词组组成特征向量,特征向量通过线性变换映射到中间层,中间层再映射到标签。
fastText 在预测标签时使用了非线性激活函数,但在中间层不使用非线性激活函数。
fastText 模型架构和 Word2Vec 中的 CBOW 模型很类似。不同之处在于,fastText 预测标签,而 CBOW 模型预测中间词。
fasttext结构
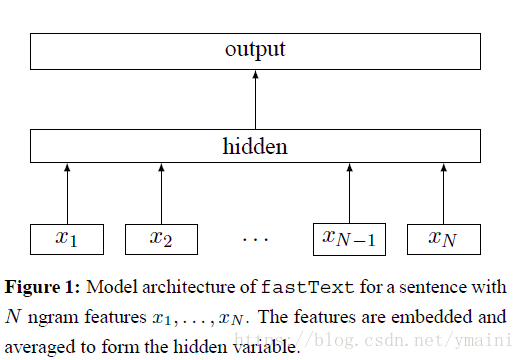
xi
- $X_i$: 一个句子的特征,初始值为随机生成(也可以采用预训练的词向量)
- hidden:$X_i$的平均值 x
- output: 样本标签
目标函数

N:样本个数
$y_n$:第n个样本对应的类别
f:损失函数softmaxt
$x_n$:第n个样本的归一化特征
A:权重矩阵(构建词,embedding)
B:权重举证(隐层到输出层)
词向量初始化
一个句子的embedding为[$iw_1,iw_2,....iw_n,ow_1,ow_2,...ow_s$]
$iw_i$:语料中出现的词,排在数组的前面
$ow_i$:n-gram或n-char特征
初始化为随机数, 如果提供预训练的词向量,对应的词采用预训练的词向量
hierarchical Softmax

当语料类别较多时,使用hierarchical Softmax(hs)减轻计算量
hs利用Huffman 树实现,词(生成词向量)或label(分类问题)作为叶子节点
根据词或label的count构建Huffman 树,则叶子到root一定存在一条路径
利用逻辑回归二分类计算loss
n-gram和n-char
asttext方法不同与word2vec方法,引入了两类特征并进行embedding。其中n-gram颗粒度是词与词之间,n-char是单个词之间。两类特征的存储均通过计算hash值的方法实现。
n-gram
示例: who am I? n-gram设置为2
n-gram特征有,who, who am, am, am I, I
n-char
示例: where, n=3, 设置起止符<, >
n-char特征有,<wh, whe, her, ere, er>
FastText词向量与word2vec对比
FastText= word2vec中 cbow + h-softmax的灵活使用
模型的输出层:word2vec的输出层,对应的是每一个term,计算某term的概率最大;而fasttext的输出层对应的是
分类的label。不过不管输出层对应的是什么内容,起对应的vector都不会被保留和使用;
模型的输入层:word2vec的输入层,是 context window 内的term;而fasttext 对应的整个sentence的内容,包括term,也包括 n-gram的内容;
两者本质的不同,体现在 h-softmax的使用。
Word2vec的目的是得到词向量,该词向量 最终是在输入层得到,输出层对应的 h-softmax 也会生成一系列的向量,但最终都被抛弃,不会使用。
fasttext则充分利用了h-softmax的分类功能,遍历分类树的所有叶节点,找到概率最大的label(一个或者N个)。
Fasttext原理的更多相关文章
- 转:fastText原理及实践(达观数据王江)
http://www.52nlp.cn/fasttext 1条回复 本文首先会介绍一些预备知识,比如softmax.ngram等,然后简单介绍word2vec原理,之后来讲解fastText的原理,并 ...
- FastText算法原理解析
1. 前言 自然语言处理(NLP)是机器学习,人工智能中的一个重要领域.文本表达是 NLP中的基础技术,文本分类则是 NLP 的重要应用.fasttext是facebook开源的一个词向量与文本分类工 ...
- 超快的 FastText
Word2Vec 作者.脸书科学家 Mikolov 文本分类新作 fastText:方法简单,号称并不需要深度学习那样几小时或者几天的训练时间,在普通 CPU 上最快几十秒就可以训练模型,得到不错的结 ...
- [转] fastText
mark- from : https://www.jiqizhixin.com/articles/2018-06-05-3 fastText的起源 fastText是FAIR(Facebook AIR ...
- 模型介绍之FastText
模型介绍一: 1. FastText原理及实践 前言----来源&特点 fastText是Facebook于2016年开源的一个词向量计算和文本分类工具,在学术上并没有太大创新.但是它的优点也 ...
- FastText算法
转载自: https://www.cnblogs.com/huangyc/p/9768872.html 0. 目录 1. 前言 2. FastText原理 2.1 模型架构 2.2 层次SoftMax ...
- NLP系列文章:子词嵌入(fastText)的理解!(附代码)
1. 什么是fastText 英语单词通常有其内部结构和形成⽅式.例如,我们可以从"dog""dogs"和"dogcatcher"的字⾯上推 ...
- 层次softmax函数(hierarchical softmax)
一.h-softmax 在面对label众多的分类问题时,fastText设计了一种hierarchical softmax函数.使其具有以下优势: (1)适合大型数据+高效的训练速度:能够训练模型“ ...
- Task6.神经网络基础
BP: 正向计算loss,反向传播梯度. 计算梯度时,从输出端开始,前一层的梯度等于activation' *(与之相连的后一层的神经元梯度乘上权重的和). import torch from tor ...
随机推荐
- 树中的路径和 Sum of Distances in Tree
2019-03-28 15:25:43 问题描述: 问题求解: 写过的最好的Hard题之一. 初看本题,很经典的路径和嘛,dfs一遍肯定可以得到某个节点到其他所有节点的距离和.这种算法的时间复杂度是O ...
- 解密:Amazon亚马逊产品Listing关键词刷单排名原理
第一:基本概念 在阅读正文之前,请先理解下面的几个基本概念. 核心词[高频词.热词.大词.主词]:长度大约1~2个单词构成,指每天搜索量比较多的词,每个行业对高频词的划分不一样,这个主要看自己 ...
- python-获取URL中的json数据
数据源为某系统提供的URL,打开是json文件,python代码获取如下: URL替换成自己的即可. import urllib.request def get_record(url): resp = ...
- 洛谷P1140 基因匹配 //DP真正意义上的一血
题目背景 大家都知道,基因可以看作一个碱基对序列.它包含了44种核苷酸,简记作A,C,G,TA,C,G,T.生物学家正致力于寻找人类基因的功能,以利用于诊断疾病和发明药物. 在一个人类基因工作组的任务 ...
- windows下Xshell远程访问虚拟机
下载Xshell 5软件在windows下安装 安装好后Xshell 5启动软件 下一步,检查虚拟机,配置是否正确 下一步,设置网络,保障虚拟机系统能够连接网络 下一步,进入虚拟机系统,检查虚拟机网络 ...
- 牛客网暑期ACM多校训练营(第七场)Bit Compression
链接:https://www.nowcoder.com/acm/contest/145/C 来源:牛客网 题目描述 A binary string s of length N = 2n is give ...
- 360开启wifi无网络访问处理办法
一.背景说明 台式机默认没有无线网卡的,想开个wifi,在电脑上插上了个usb无线网卡然后开启“360免费WiFi”.但显示“无网络访问”,连上之后确实也不能访问外部网站. 二.处理办法 依次打开“控 ...
- python数据结构与算法之算法和算法分析
1.问题.问题实例.算法的概念区分. 一个例子说明一下: 问题:判断一个正整数N是否为素数 #问题是需要解决的一个需求 问题实例:判断1314是否为素数? #问题实例是该问题的一个具体例子 算法: ...
- padding属性很有用
html代码中的text-align有时失效,特别是用bootstrap时,用padding-left:xx%,能够很好定位,而且只能够电脑和手机浏览器显示的统一.
- java 面试题2
Java 模拟面试题 1.面向对象的特点 继承,封装,多态 2.对象和类的区别是什么? 对象是对客观事物的抽象,类是对对象的抽象.类是一种抽象的数据类型,它们的关系是,对象是类的实例,类是对象的模板. ...