
『高性能模型』卷积复杂度以及Inception系列
转载自知乎:卷积神经网络的复杂度分析
之前的Inception学习博客:
『TensorFlow』读书笔记_Inception_V3_上
『TensorFlow』读书笔记_Inception_V3_下
一、时间复杂度
即模型的运算次数,可用FLOPs衡量,也就是浮点运算次数(FLoating-point OPerations)。
单个卷积层的时间复杂度
Time~O(M2·K2·Cin·Cout)
M:输出特征图边长
K:卷积核尺寸
C:通道数目
输出边长M计算公式为:
M = (X - K + 2*Padding)//Stride + 1
- 注1:为了简化表达式中的变量个数,这里统一假设输入和卷积核的形状都是正方形
- 注2:严格来讲每层应该还包含 1 个
参数,这里为了简洁就省略了
- 注3:TensorFlow中SAME形式输出为(X/Stride)上取整,因为TF中默认总共填充K/2,注意不需要进行2*Padding
下图展示了单个Cout的上单个点的计算示意,需要重复计算:Cout·每张输出特征图上像素数次。

卷积神经网络整体复杂度
Time~O(∑l=1 M2·K2·Cl-1·Cl)
l表示层编号,实质就是对各个层求和。
卷积层实现可以很好的看清实现机理:out层、out长宽、in层循环,循环体内k2级别运算:
def conv2d(img, kernel):

    height, width, in_channels = img.shape

    kernel_height, kernel_width, in_channels, out_channels = kernel.shape

    out_height = height - kernel_height + 1

    out_width = width - kernel_width + 1

    feature_maps = np.zeros(shape=(out_height, out_width, out_channels))

    for oc in range(out_channels):              # Iterate out_channels (# of kernels)

        for h in range(out_height):             # Iterate out_height

            for w in range(out_width):          # Iterate out_width

                for ic in range(in_channels):   # Iterate in_channels

                    patch = img[h: h + kernel_height, w: w + kernel_width, ic]

                    feature_maps[h, w, oc] += np.sum(patch * kernel[:, :, ic, oc])

    return feature_maps
二、空间复杂度
空间复杂度(访存量),严格来讲包括两部分:总参数量 + 各层输出特征图。
- 参数量:模型所有带参数的层的权重参数总量(即模型体积,下式第一个求和表达式)
- 特征:模型在实时运行过程中每层所计算出的输出特征图大小(下式第二个求和表达式)
Space~O(∑K2·Cl-1·Cl + ∑M2·Cl)
M:输出特征图边长
K:卷积核尺寸
C:通道数目
三、复杂度对模型的影响
时间复杂度决定了模型的训练/预测时间。如果复杂度过高,则会导致模型训练和预测耗费大量时间,既无法快速的验证想法和改善模型,也无法做到快速的预测。
空间复杂度决定了模型的参数数量。由于维度诅咒的限制,模型的参数越多,训练模型所需的数据量就越大,而现实生活中的数据集通常不会太大,这会导致模型的训练更容易过拟合。
当我们需要裁剪模型时,由于卷积核的空间尺寸通常已经很小(3x3),而网络的深度又与模型的表征能力紧密相关,不宜过多削减,因此模型裁剪通常最先下手的地方就是通道数。
四、Inception系列优化思路
1、Inception_v1:1*1卷积降维同时优化时间复杂度和空间复杂度

InceptionV1 借鉴了 Network in Network 的思想,在一个 Inception Module 中构造了四个并行的不同尺寸的卷积/池化模块(上图左),有效的提升了网络的宽度。但是这么做也造成了网络的时间和空间复杂度的激增。对策就是添加 1 x 1 卷积(上图右红色模块)将输入通道数先降到一个较低的值,再进行真正的卷积。
在3*3卷积分支上加入64个1*1卷积前后的时间复杂度对比如下式:
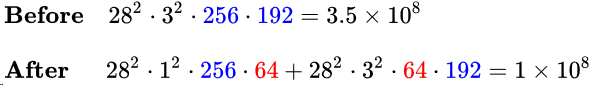
同理,在5*5卷积分支上加入64个1*1卷积前后的时间复杂度对比如下式:
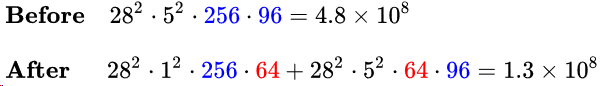
整个层的参数量变化如下:
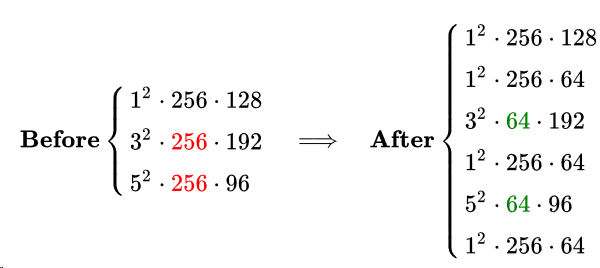
2、Inception_v1:使用GAP(全局平局均池化)代替全连接
全连接层复杂度分析:X*X的输入Flatten为X2的输入,输出神经元个数可以视为1*1*Cout,则:
Time~O(12·X2·Cin·Cout)
Space~O(X2·Cin·Cout + X2·Cin) ~ O(X2·Cin·Cout)
空间复杂度第一部分为权重参数,第二部分为当前输入大小。顺便一提我之前的一个误区:全连接层相对卷积层其运算瓶颈不在时间复杂度,而在空间复杂度,我之前的印象里把两者混为一谈了。
使用GAP后,首先将Cin·X2的输入转化为Cin,然后1*1卷积为Cout:
Time~O(Cin·Cout)
Space~O(Cin·Cout + Cin)~ O(Cin·Cout)
Space来说可能有点问题:Cin·X2的原输入应该还是要存储的,不过由于不涉及到卷积运算,姑且不细究。
但是注意:GAP会影响收敛速度,不过并不会影响最终的精度。
3、Inception_v2:两个3*3卷积联级替代5*5卷积
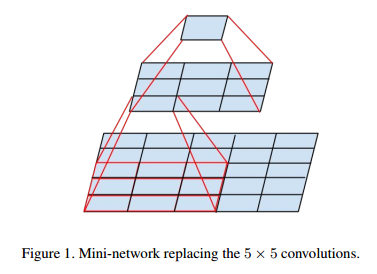
两个3*3卷积联级的感受野与单个5*5卷积相当,计算公式可见『计算机视觉』感受野和anchor,替换后时间复杂度却可降低:
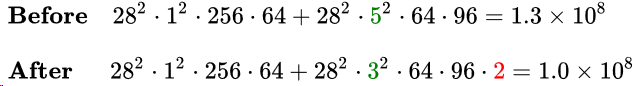
4、Inception_v3:使用N*1和1*N卷积联级代替N*N卷积
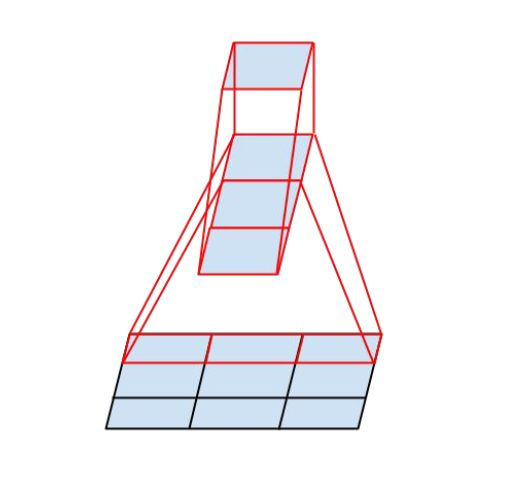
InceptionV3 中提出了卷积的 Factorization,在确保感受野不变的前提下进一步简化,复杂度的改善同理可得,不再赘述。
5、Xnception:使用Depth wise Separable Convolution

Xception 中每个输入通道只会被对应的一个卷积核扫描,降低了模型的冗余度。对于深度可分离卷积Depthwise Separable 是一个 Depthwise conv 加一个 Pointwise conv,其中 Depthwise 是M2·K2·Cin,Pointwise 是M2·Cin·Cout,即:
Time~O(M2·K2·Cin + M2·Cin·Cout)
『高性能模型』卷积复杂度以及Inception系列的更多相关文章
- 『高性能模型』HetConv: HeterogeneousKernel-BasedConvolutionsforDeepCNNs
论文地址:HetConv 一.现有网络加速技术 1.卷积加速技术 作者对已有的新型卷积划分如下:标准卷积.Depthwise 卷积.Pointwise 卷积.群卷积(相关介绍见『高性能模型』深度可分离 ...
- 『高性能模型』轻量级网络ShuffleNet_v1及v2
项目实现:GitHub 参考博客:CNN模型之ShuffleNet v1论文:ShuffleNet: An Extremely Efficient Convolutional Neural Netwo ...
- 『高性能模型』轻量级网络MobileNet_v2
论文地址:MobileNetV2: Inverted Residuals and Linear Bottlenecks 前文链接:『高性能模型』深度可分离卷积和MobileNet_v1 一.Mobil ...
- 『高性能模型』Roofline Model与深度学习模型的性能分析
转载自知乎:Roofline Model与深度学习模型的性能分析 在真实世界中,任何模型(例如 VGG / MobileNet 等)都必须依赖于具体的计算平台(例如CPU / GPU / ASIC 等 ...
- 『高性能模型』深度可分离卷积和MobileNet_v1
论文原址:MobileNets v1 TensorFlow实现:mobilenet_v1.py TensorFlow预训练模型:mobilenet_v1.md 一.深度可分离卷积 标准的卷积过程可以看 ...
- 『TensorFlow Internals』笔记_源码结构
零.资料集合 知乎专栏:Bob学步 知乎提问:如何高效的学习 TensorFlow 代码?. 大佬刘光聪(Github,简书) 开源书:TensorFlow Internals,强烈推荐(本博客参考书 ...
- 2017-2018-2 1723 『Java程序设计』课程 结对编程练习-四则运算-准备阶段
2017-2018-2 1723 『Java程序设计』课程 结对编程练习-四则运算-准备阶段 在一个人孤身奋斗了将近半个学期以后,终于迎来的我们的第一次团队协作共同编码,也就是,我们的第一个结对编程练 ...
- 『深度应用』NLP机器翻译深度学习实战课程·壹(RNN base)
深度学习用的有一年多了,最近开始NLP自然处理方面的研发.刚好趁着这个机会写一系列NLP机器翻译深度学习实战课程. 本系列课程将从原理讲解与数据处理深入到如何动手实践与应用部署,将包括以下内容:(更新 ...
- 似魔鬼的 『 document.write 』
在平时的工作中,楼主很少用 document.write 方法,一直觉得 document.write 是个危险的方法.楼主不用,并不代表别人不用,最近给维护的项目添了一点代码,更加深了我对 &quo ...
随机推荐
- Linux资源分析工具杂谈(长文慎入)
Linux资源分析工具杂谈 开篇之前请大家先思考一个问题: 磁盘的平均I/O响应时间是1 ms,这个指标是好,还是差? 众所周知,计算机科学是客观的,也就是说对于一个给定的问题,我们总是 ...
- 使用Spring的@Async创建异步方法
使用Spring的@Async创建异步方法 在开发系统的过程中,通常会考虑到系统的性能问题,提升系统性能的一个重要思想就是“串行”改“并行”.说起“并行”自然离不开“异步”,今天我们就来聊聊如何使用S ...
- GIL
GIL(Global Interpreter Look):全局解释器锁,为了避免线程竞争资源造成数据错乱. 其实每个py程序都必须有解释器参加,解释器就是一堆代码,就等于多线程要竞争同一个解释器的代码 ...
- vm中的nat模式不能连接到主机,以及不能上网
主机能够ping通vm中的ip,但是vm不能ping通主机ip vm不能ping通主机:主要是虚拟机中的gateway的设置和vm的网络编辑器中的网关id不一致造成的 vm不能上外网:dns没有配置正 ...
- Git仓库完全迁移,包括所有的分支和标签,当然也包括日志
一.删除原有远程仓库地址 git remote rm origin 添加新的仓库地址 cd existing_repo git remote add origin <URL> git pu ...
- charls 抓包
一.HTTPS原理: HTTPS(Hyper Text Transfer Protocol Secure),是一种基于SSL/TLS的HTTP,所有的HTTP数据都是在SSL/TLS协议封装之上进行传 ...
- ceph rbd双挂载导致ext4文件系统inode链接数据污染
转载自:https://my.oschina.net/xueyi28/blog/1596003 ###故障现象 /data/rbd1/dir1/a/file1 /data/rbd1/dir2/a/fi ...
- C++隐藏任务栏图标
在VC编程中,有时候我们需要将我们的程序在任务栏上的显示隐藏起来,我试过几种方法,下面我介绍一下我知道的三种方法. 第一种方法是设置窗口WS_EX_TOOLWINDOW扩展样式,通过在OnInitDi ...
- Windows 下安装 Memcached
Windows 下安装 Memcached 官网上并未提供 Memcached 的 Windows 平台安装包,我们可以使用以下链接来下载,你需要根据自己的系统平台及需要的版本号点击对应的链接下载即可 ...
- 【Alpha】Scrum Meeting 8
目录 前言 任务分配 燃尽图 会议照片 签入记录 困难 前言 第8次会议在4月12日21:00进行微信会议. 交流确认了任务进度,对下一阶段任务进行分配.时长15min. 任务分配 姓名 当前阶段任务 ...