
中国大学MOOC课程信息之数据分析可视化一
版权声明:本文为博主原创文章,转载 请注明出处:https://blog.csdn.net/sc2079/article/details/82263391
9月2日更:中国大学MOOC课程信息之数据分析可视化二
写在前面
上一篇我的博客:中国大学MOOC课程信息爬取与数据存储于8月24日爬取并存储了中国大学MOOC的各个学科的课程信息。如下:
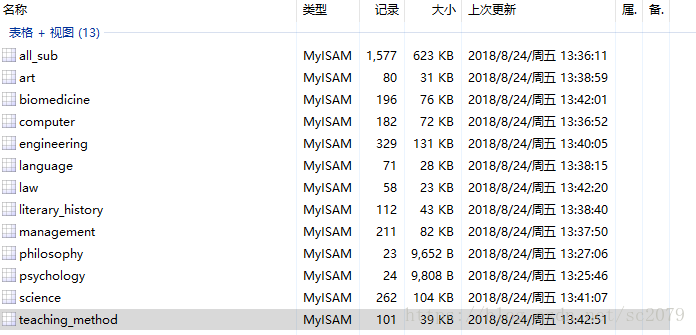
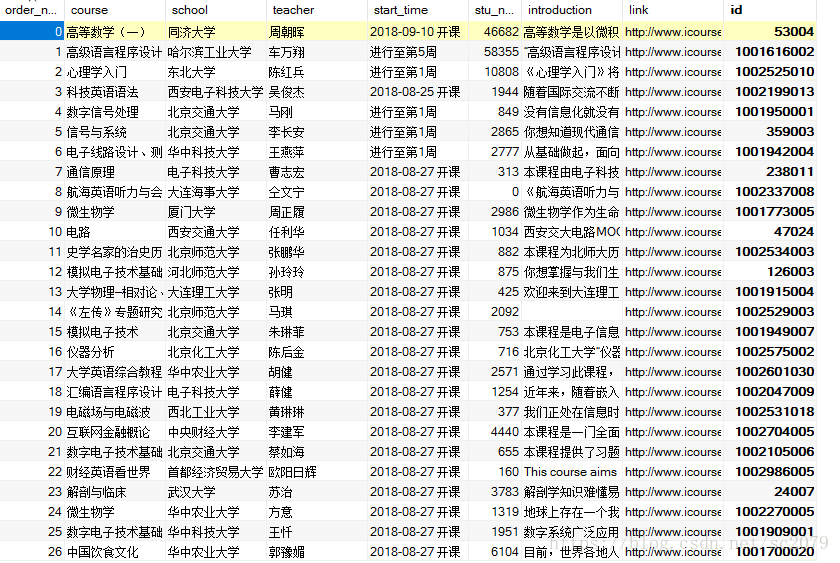
今天我就来简单做一哈MOOC课程信息的数据分析及可视化。
PS:初入茅庐,参考了网上很多大佬的文章,特别感谢!
环境配置与安装
运行环境:Python3.6 Spyder
依赖模块:scipy、matplotlib、pymysql、 jieba、re、collections、wordcloud 、pandas、seaborn、numpy、PIL、pyecharts等
注:部分模块的安装比较麻烦,可以网上查询相关方法。
开始工作
1、从Mysql 中获取数据
比较简单,我就直接贴代码了。
def get_mysql():

    kc_info=[]

    db = pymysql.connect(host='localhost',user='root',passwd='root',db='mooc_courses_info',charset='utf8')

    cur = db.cursor()

    sql = '''SHOW TABLES'''

    cur.execute(sql)

    tables= cur.fetchall()

    for subject in tables:

        cur.execute("select * from %s"% subject)

        results=cur.fetchall()

        kc_info.append(results)

    return tables,kc_info

tables,kc_info=get_mysql()
2、课程名做词云
我现将全部的课程名提取出来并连接在一起。
courses_text=''

for kc in kc_info[0]:

    course_text=kc[1]

    courses_text=courses_text+' '+course_text
再用jieba分词,Counter计数,导出前100个高频词汇
courses_jieba = list(jieba.cut(courses_text))

# 使用 counter 做词频统计,选取出现频率前 100 的词汇

c = Counter(courses_jieba)

common_c = c.most_common(100)

print(common_c)
结果是这样的:
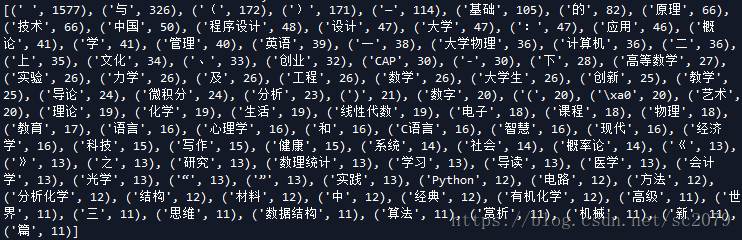
显然,“与”、“一”、“上”、标题符号等都不是我们所期待的,必须将其去掉。关于这一点,网上的方法是要利用停用词表去掉这些字词符号,参考这篇:python结巴分词、jieba加载停用词表。由于我所处理的精度以及量不算太多,我直接采用re去除。
courses_text= re.sub("[\“\”\《\》\(\)\,\——\:\、\-\(\)一二三上下与的及之和中 ]", "",courses_text )处理后的结果是这样的:
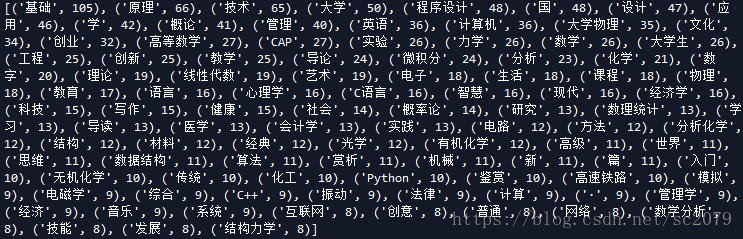
看着还算可以吧。
接下来,就要做词云啦。参考我以前做过的词云,稍微修改一哈就可以啦。特别心酸的是:字体的正确选择,花了我好长时间。
def word_cloud(common_c):

    # 读入词云模板

    bg_pic = imread('D:\\python_data\\词云模板\\29.jpg')  #一张枫叶图片

    # 配置词云参数

    wc = WordCloud(

            # 设置字体

            font_path ='C:\\windows\\Fonts\\STSONG.TTF',

			  # 设置背景色

            background_color='white',

            # 允许最大词汇

            max_words=200,

            # 词云形状

            mask=bg_pic,

            # 最大号字体

            max_font_size=50,

            random_state=100,

            )

    # 生成词云

    wc.generate_from_frequencies(dict(common_c))

    # 生成图片并显示

    plt.figure()

    plt.imshow(wc)

    plt.axis('off')

    plt.show()

    # 保存图片

    wc.to_file('D:\\python_data\\词云图片\\2.jpg')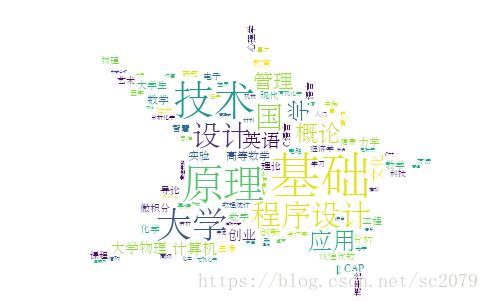
3.大学开课数统计
创建一个数组,记录开课数前20个的大学,并用柱形图表示出来。
def bar_plot(datas):

    plt.rcParams['font.sans-serif'] = ['SimHei']  # 中文字体设置-黑体

    plt.rcParams['axes.unicode_minus'] = False  # 解决保存图像是负号'-'显示为方块的问题

    sns.set(font='SimHei')  # 解决Seaborn中文显示问题

    datas=pd.DataFrame(datas[0:20],columns=['大学','开课数'])

    sns.barplot(x=datas['大学'],y=datas['开课数'],palette="muted")

    plt.xticks(rotation=90)

    plt.show()

#大学开课数统计

uni_courses_num={}

for kc in kc_info[0]:

    uni_courses_num[kc[2]] = uni_courses_num.get(kc[2],0) + 1

items = list(uni_courses_num.items())

items.sort(key=lambda x:x[1], reverse=True)

bar_plot(items)
得到的结果如下:
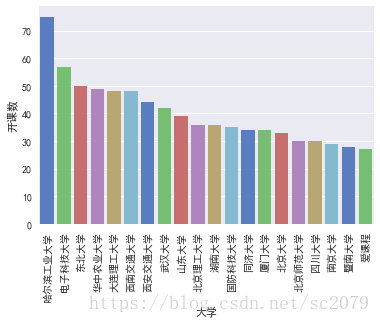
可以看出,哈工以巨大优势问鼎,电科、东北大学紧追其后。开心的是,母校也榜上有名!母校加油!
4.课程热度分析
这里我是在全部课程里统计课程热度的,如果有兴趣的话,你也可以选取你感兴趣的学科进行热度统计。
def bar_plot2(datas):

    f, ax=plt.subplots(figsize=(8,12))

    datas=pd.DataFrame(datas[0:20],columns=['课程名称','热度'])

    #orient='h'表示是水平展示的,alpha表示颜色的深浅程度

    sns.barplot(y=datas['课程名称'], x=datas['热度'],orient='h', alpha=0.8, color='red')

    #sns.barplot(y=datas['课程名称'], x=datas['热度'],palette="muted")

    #设置X轴的各列下标字体是水平的

    plt.xticks(rotation='horizontal')

    #设置Y轴下标的字体大小

    plt.yticks(fontsize=10)

    plt.show()

#课程热度统计

courses_hot=[]

for kc in kc_info[0]:

    courses_hot.append((kc[1],kc[5]))

courses_hot.sort(key=lambda x:x[1], reverse=True)

bar_plot2(courses_hot)
运行结果如下:
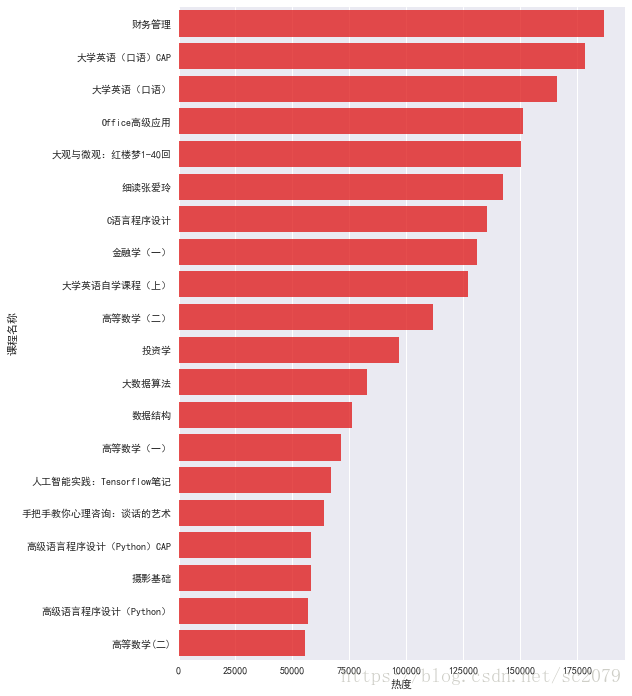
可以看出,财务管理最受欢迎,达到18万之多。另外,高数、编程类、英语口语类、财务类受欢迎度远超其他学科门类。
5、学科开课数统计
先统计各个学科的课程数量,为了绘图更简洁美观,有些课程少的我打包放进了“其它”。
num=5

subject_courses=[]

for i in range(1,len(tables)):

    subject_courses.append((tables[i][0],len(kc_info[i])))

subject_courses.sort(key=lambda x:x[1], reverse=True)

left_courses=0

for i in range(num):

    print(subject_courses[-i-1][1])

    left_courses+=subject_courses[-i-1][1]

deal_subject_courses=subject_courses[0:len(subject_courses)-num]

deal_subject_courses.append(('others',left_courses))
参考了网上一些代码,做了一些修改,如下:
def pie_plot(datas):

    # # 饼状图

    labels,sizes=[],[]

    for i in range(len(datas)):

        labels.append(datas[i][0])

        sizes.append(datas[i][1])

    # plot.figure(figsize=(8,8))

    colors = ['red', 'yellow', 'blue', 'green','blueviolet','gold','pink','purple','tomato','white']

    colors=colors[0:len(sizes)]

    explode = (0.2, 0, 0, 0,0,0,0,0,0,0,0)

    explode=explode[0:len(sizes)]

    patches, l_text, p_text = plt.pie(sizes, explode=explode, labels=labels, colors=colors,

                                       labeldistance=1.1, autopct='%2.1f%%', shadow=False,

                                       startangle=-180, pctdistance=0.6)

    # labeldistance,文本的位置离远点有多远,1.1指1.1倍半径的位置

    # autopct,圆里面的文本格式,%3.1f%%表示小数有三位,整数有一位的浮点数

    # shadow,饼是否有阴影

    # startangle,起始角度,0,表示从0开始逆时针转,为第一块。一般选择从90度开始比较好看

    # pctdistance,百分比的text离圆心的距离

    # patches, l_texts, p_texts,为了得到饼图的返回值,p_texts饼图内部文本的,l_texts饼图外label的文本

    # 改变文本的大小

    # 方法是把每一个text遍历。调用set_size方法设置它的属性

    for t in l_text:

        t.set_size = 30

    for t in p_text:

        t.set_size = 20

    # 设置x,y轴刻度一致,这样饼图才能是圆的

    plt.axis('equal')

    plt.legend(loc='upper left', bbox_to_anchor=(-0.1, 1))

    # loc: 表示legend的位置,包括'upper right','upper left','lower right','lower left'等

    # bbox_to_anchor: 表示legend距离图形之间的距离,当出现图形与legend重叠时,可使用bbox_to_anchor进行调整legend的位置

    # 由两个参数决定,第一个参数为legend距离左边的距离,第二个参数为距离下面的距离

    plt.grid()

    plt.show()
运行结果如下:
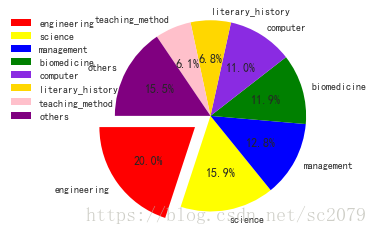
可以看出,理工类课程开课最多,管理类、生命科学类其次,文学历史、教育教学等相对较少。
另外,我还用了pyecharts生成动态图表
如:
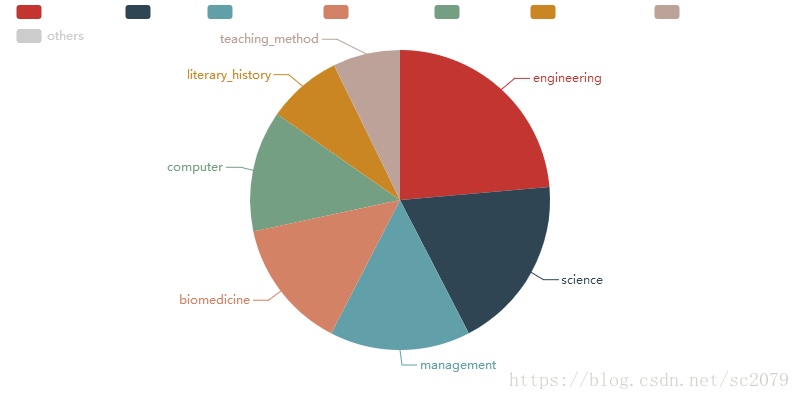
比较疑惑的是,最上边图例为什么没有注释(去掉这个学科便出现了)。如果有知道原因或解决方法的,欢迎留言或私戳,不甚感谢!
结语
其实还有很多可以做的,比如统计每个省份开课数(通过大学定位)、统计每月开课数等。有空再补吧!
中国大学MOOC课程信息之数据分析可视化一的更多相关文章
- 中国大学MOOC课程信息之数据分析可视化二
版权声明:本文为博主原创文章,转载 请注明出处:https://blog.csdn.net/sc2079/article/details/82318571 - 写在前面 本篇博客继续对中国大学MOOC ...
- 中国大学MOOC课程信息爬取与数据存储
版权声明:本文为博主原创文章,转载 请注明出处: https://blog.csdn.net/sc2079/article/details/82016583 10月18日更:MOOC课程信息D3.js ...
- MOOC课程信息D3.js动态可视化
版权声明:本文为博主原创文章,转载 请注明出处:https://blog.csdn.net/sc2079/article/details/83153693 - 写在前面 好久没更新博客了,主要还是最近 ...
- 如何爬取icourse163 中国慕课上课程信息(上),
中国大学MOOC网上有着特别完善的课程信息,我觉得这是一份可以让我们充分利用的资源 那么,接下来的问题就是我们该如何爬取这里的资源 选择其中的计算机课程进行尝试 import requests fro ...
- 大学MOOC课程视频下载、流文件合并、批量重命名、b站视频下载及学习课程视频推荐
计算机行业技术更新快,编程语言种类多,在当今大数据和人工智能的时代,为了能在相关领域有所成就,就必须掌握好python.R等语言,较好的数学基础和深入的行业背景知识.计算机从业人员务必践行" ...
- 【python】下载中国大学MOOC的视频
[python]下载中国大学MOOC的视频 脚本目标: 输入课程id和cookie下载整个课程的视频文件,方便复习时候看 网站的反爬机制分析: 分析数据包的目的:找到获取m3u8文件的路径 1. 从第 ...
- 中国大学MOOC中的后台文件传输
早期版本的中国大学MOOC一旦被挂起后,应用在完成当前下载任务后无法继续添加新任务,当然也无法将缓存状态写入数据库.这个问题能否顺利解决直接关系到用户体验. 顺便吐槽下,凡是使用了后台文件传输还提示你 ...
- 中国大学mooc直播回放看这里哦http://www.icourse163.org/forum/1001974001/topic-1003372881.htm?sortType=1&pageIndex=1
中国大学mooc直播回放看这里哦http://www.icourse163.org/forum/1001974001/topic-1003372881.htm?sortType=1&pageI ...
- 中国大学MOOC 邮箱验证的问题
在使用 中国大学 MOOC 过程中,在PC端修改个人资料时,其中有项“常用邮箱”,于是写了QQ邮箱,结果发现一直无法验证,连邮件都无法收到. 经过多番尝试,重新使用邮箱注册的方式注册账号,然后注册成功 ...
随机推荐
- 【c# 学习笔记】c#中的语句
1.条件语句: if语句: bool condition = true; if (condition) { } else if (condition) { } else { } switch语句: b ...
- in-place数据交换
实现in-place的数据交换 声明:引用请注明出处http://blog.csdn.net/lg1259156776/ 经典的排序问题 问题描述 一个数组中包含两个已经排好序的子数组,设计一个in- ...
- Codis-dashboard的配置和启停
Codis-dashboard是集群的管理工具 生成配置文件,即将现有的配置文件输出到指定目录位置: ./codis-dashboard --default-config | tee conf/das ...
- 【转】JS大总结(带实例)
JS大总结(带实例) JavaScript事务查询综合click() 对象.click() 使对象被点击.closed 对象.closed 对象窗口是否已封闭true/falseclearTimeou ...
- bootstrap基础学习【导航条、分页导航】(五)
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- 洛谷 题解 UVA10048 【噪音恐惧症 Audiophobia】
[题意] 输入一个\(C\)个点\(S\)条边 \((C<=100)\) \((S<=1000)\)的无向带权图,边权表示该路径上的噪声值.当噪声太大时,耳膜可能会收到损伤,所以当你从某点 ...
- 《Tsinghua os mooc》第15~16讲 处理机调度
第十五讲 处理机调度 进程调度时机 非抢占系统中,当前进程主动放弃CPU时发生调度,分为两种情况: 进程从运行状态切换到等待状态 进程被终结了 可抢占系统中,中断请求被服务例程响应完成时发生调度,也分 ...
- hdoj3746(kmp算法的nex数组求最小循环节)
题目链接:https://vjudge.net/problem/HDU-3746 题意:给定一个字符串,问最少在两端添加多少元素使得整个字符串是呈周期性的. 思路: 应用到kmp中nex数组的性质,数 ...
- [转帖]可能是东半球最好的 Curl 学习指南,强烈建议收藏!
可能是东半球最好的 Curl 学习指南,强烈建议收藏! http://www.itpub.net/2019/09/30/3302/ 记得转帖过.. 简介 curl 是常用的命令行工具,用来请求 Web ...
- Lucas定理的运用及组合数奇偶性的判断
组合数奇偶性的判断 对于C(n,k),若n&k == k 则c(n,k)为奇数,否则为偶数. 最直观的方法就是计算一下,然后看它的奇偶性:但是这个时间以及数据范围上都不允许: 另外一种方法就是 ...