
在Ubuntu上安装Spark
1.下载spark2.4.3 使用用户的hadoop的版本,解压并放到/usr/local下并改名为spark目录

2.设置spark目录为本用户所有

3.设置环境变量
(1)#~/.bashrc
export SPARK_HOME=/usr/local/spark
source ~/.bashrc

(2)cp /usr/local/spark/conf/spark-env.sh.template /usr/local/spark/conf/spark-env.sh

(3)进入 /usr/local/spark/conf/spark-env.sh
export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoop classpath)
export HADOOP_CONF_DIR=/usr/local/hadoop/etc/hadoop
SPARK_LOCAL_IP="127.0.0.1"

4.单机模式
/usr/local/spark/bin/spark-shell

5.增加内容到最外层标签内,文件是/usr/local/hadoop/etc/hadoop/yarn-site.xml

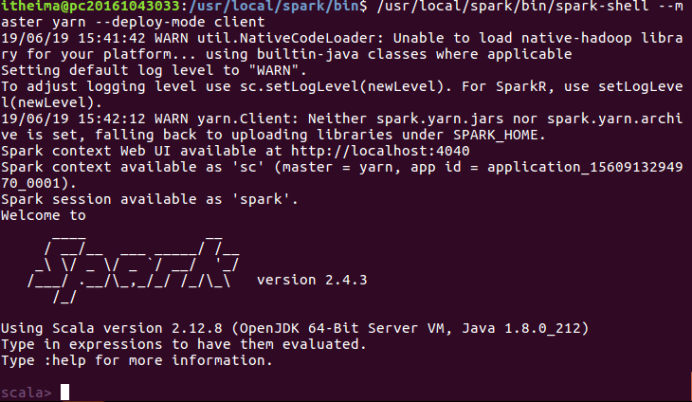
执行(yarn模式)
/usr/local/spark/bin/spark-shell --master yarn --deploy-mode client
在Ubuntu上安装Spark的更多相关文章
- [异常解决] ubuntu上安装JLink驱动遇到的坑及给后来者的建议
一.前言 最近将整个电脑格式化,改成了linux操作系统 希望这样能让自己在一个新的世界探索技术.提升自己吧- win上的工具用多了,就不想变化了- 继上一篇<ubuntu上安装虚拟机遇到的问题 ...
- Ubuntu上安装Robomongo及添加到启动器
到目前为止,Robomongo仍是MongoDB最好的客户端管理工具,如需在Ubuntu上安装Robomongo,可直接从官网下载.tar.gz压缩包进行解压,然后直接运行bin目录下的robomon ...
- 在 Ubuntu 上安装 Android Studio
在 Ubuntu 上安装 Android Studio http://www.linuxidc.com/Linux/2013-05/84812.htm 打开terminal,输入以下命令 sudo a ...
- Ubuntu上安装Karma失败对策
在Ubuntu上安装Karma遇到超时 timeout 错误.Google了一下,国外的码农给了一个快捷的解决方案,实测可行,贴在这里: sudo apt-get install npm nodejs ...
- 在Ubuntu上安装LAMP服务器
1.安装Ubuntu上安装LAMP apt-get install lamp-server^ 2.安装过程中设置MySql密码 3.测试 创建index.php var/www/html/index. ...
- [译]How to Setup Sync Gateway on Ubuntu如何在ubuntu上安装sync-gateway
参考文章https://hidekiitakura.com/2015/03/21/how-to-setup-sync-gateway-on-ubuntudigitalocean/ 在此对作者表示感谢 ...
- 在Ubuntu上安装JDK、Ant、Jmeter和Jenkins
一.前期准备 1. 在win7下载VMware.Ubuntu(用迅雷下比较快) 2. 安装完VMware后新建虚拟机,选择iso: 3. 具体配置参考如下,至此Ubantu安装完成 二.在Ubuntu ...
- Ubuntu上安装MongoDB(译)
add by zhj:直接从第四步开始就可以了,而且安装好MongoDB后会自动启动的,不必自己去执行启动命令 原文:https://docs.mongodb.com/manual/tutorial/ ...
- Ubuntu上安装ns2-2.34
Ubuntu上安装ns2-2.34 步骤1 下载ns-allinone-2.34 $ tar zxf ns-allinone-2.34.tar.gz 步骤2 sudo apt-get install ...
随机推荐
- 【CUDA 基础】0.0 腾讯云CUDA环境搭建
title: [CUDA 基础]0.0 腾讯云CUDA环境搭建 categories: CUDA Freshman tags: CUDA 环境搭建 toc: true date: 2018-02-13 ...
- carographer流程
node_main.cc 93 Run启动 58 Node初始化 64 node.StartTrajectoryWithDefault ...
- Jmeter函数 参数
1.time时间函数 ${__time(,)} 1450056496991 //无格式化参数,返回当前毫秒时间 ${__time(/1000,)} //返回当前时间为秒 ${__time(yyyyMM ...
- PHP反序列化总结
之前遇到过很多次php反序列化相关的内容,总结一下. (反)序列化给我们传递对象提供了一种简单的方法.serialize()将一个对象转换成一个字符串,unserialize()将字符串还原为一个对象 ...
- laravel insert 、save、update、create区别(总结二)
1.insert:插入数据时,需要维护 created_at 和 updated_at字段, 2.save:无论插入或者更新,会自动维护,无需手动操作 //插入: public function st ...
- Docker关键概念阐述
要了解Docker需要对其体系结构中的几个关键概念有所了解,主要包括image.container.service.swarm.stack等. 在介绍这几个概念时,会使用到一个测试环境,这个测试环境是 ...
- spark streaming 4: DStreamGraph JobScheduler
DStreamGraph有点像简洁版的DAG scheduler,负责根据某个时间间隔生成一序列JobSet,以及按照依赖关系序列化.这个类的inputStream和outputStream是最重要的 ...
- koa 基础(二十五)数据库 与 art-template 模板 联动 --- 新增数据
1.视图层 根目录/views/index.html <!DOCTYPE html> <html lang="en"> <head> <m ...
- 执行docker run命令时报错Get https://registry-1.docker.io/v2/: net/http: request canceled while waiting for connection (Client.Timeout exceeded while awaiting headers)
一.解决办法: 修改host 二.步骤如下 2.1 安装dig工具 sudo apt-get install dnsutils -y (ubuntu下的安装方法) 2.2 找到registry-1. ...
- python 学习笔记(三)根据字典中值的大小对字典中的项排序
字典的元素是成键值对出现的,直接对字典使用sorted() 排序,它是根据字典的键的ASCII编码顺序进行排序,要想让字典根据值的大小来排序,可以有两种方法来实现: 一.利用zip函数将字典数据转化为 ...