
基于nodejs将mongodb的数据实时同步到elasticsearch
一、前言
因公司需要选用elasticsearch做全文检索,持久化存储选用的是mongodb,但是希望mongodb里面的数据发生改变可以实时同步到elasticsearch上,一开始主要使用elasticsearch v1.7.2的版本,mongo-river可以搞定这个问题。随着elasticsearch的升级,发现elasticsearch已经放弃了mongo-river,咋整......Google之后发现一神器mongo-connector,国外大神用python写的工具而且MongoDB官网也极力推荐使用。But,我们需要把文档中的附件信息也同步到elasticsearch上,mongo-connector对附件同步支持的不是很好。能不能有个nodejs版本的数据同步?GitHub上发现一个大神写的node-elasticsearch-sync很好用,但是功能太简单了,不支持复杂的数据筛选,也不支持附件同步。活人不能被尿憋死,参考node-elasticsearch-sync自己写了一个同步工具node-mongodb-es-connector。
二、准备工作
2.1 安装mongodb
安装mongodb可以去官网下载:
PS:关于如何搭建mongodb replica集群:
https://www.cnblogs.com/ljhdo/p/4503317.html
2.2 安装elasticsearch
安装elasticsearch可以去官网下载:
https://www.elastic.co/cn/downloads
PS:关于elasticsearch-head、kibana、logstash等相关安装请自己google吧
2.3 安装nodejs
安装nodejs可以去官网下载:
PS:别忘记安装npm,如何安装请自己google吧
以上是使用node-mongodb-es-connector的前提
2.4 node-mongodb-es-connector下载地址
github: https://github.com/zhr85210078/node-mongodb-es-connector
npm: https://www.npmjs.com/package/es-mongodb-sync?activeTab=readme
三、文件结构
├── crawlerDataConfig    项目构建配置(这里添加你要同步数据的配置)

│       ├── mycarts.json  一个index一个配置文件(唯一需要自己增加或者修改的配置文件,这个文件只是提供了一个例子,不用可以删除)

│       └── ……

├── lib

│   ├── pool

│   │   ├──  elasticsearchPool.js  elasticsearch连接池

│   │   ├──  mongoDBPool.js      mongodb连接池

│   ├── promise

│   │   ├──  elasticsearchPromise.js elasticsearch方法类(增删改查)

│   │   ├──  mongoPromise.js      mongodb方法类(增删改查)

│   ├── util

│   │   ├──  fsWatcher.js        配置文件监控类(主要监控crawlerDataConfig目录里面的配置文件)

│   │   ├──  logger.js          日志类

│   │   ├──  oplogFactory.js      mongo-oplog触发事件之后的执行方法(增删改)

│   │   ├──  tail.js           监听mongodb数据是否发生变化

│   │   ├──  util.js                  工具类

│   ├── main.js                        主方法(主要是第一次启动立刻同步mongodb里面的数据到elasticsearch)

├── logs

│       ├── logger-2018-03-23.log     同步数据打印日志

│       └── ……

├── test

│   ├── img

│   │    ├── elasticsearch.jpg      图片不解释

│   │    ├── mongoDB.jpg        图片不解释

│   │    └── structure.jpg        图片不解释

│   └── test.js              测试类(啥也没写)

├── app.js       启动文件

├── index.js      接口文件(只提供配置文件的增删改)

├── package-lock.json

├── package.json

├── ReadMe.md      英文文档(markdown)

├── README.zh-CN.md  中文文档(markdown)

└── LICENSE
mycarts.json文件(这个文件只是提供了一个例子)
{

    "mongodb": {

        "m_database": "myTest",

        "m_collectionname": "carts",

        "m_filterfilds": {

            "version" : "2.0"

        },

        "m_returnfilds": {

            "cName": 1,

            "cPrice": 1,

            "cImgSrc": 1

        },

        "m_connection": {

            "m_servers": [

                "localhost:29031",

                "localhost:29032",

                "localhost:29033"

            ],

            "m_authentication": {

                "username": "UserAdmin",

                "password": "pass1234",

                "authsource": "admin",

                "replicaset": "my_replica",

		"ssl":false

            }

        },

        "m_documentsinbatch": 5000,

	"m_delaytime": 1000

    },

    "elasticsearch": {

        "e_index": "mycarts",

        "e_type": "carts",

        "e_connection": {

            "e_server": "http://localhost:9200",

            "e_httpauth": {

                "username": "EsAdmin",

                "password": "pass1234"

            }

        },

        "e_pipeline": "mypipeline",

	"e_iscontainattachment": true

    }

}
- m_database - MongoDB里需要监听的数据库.
- m_collectionname - MongoDB里需要监听的collection.
- m_filterfilds - MongoDB里的查询条件,目前支持一些简单的查询条件.(默认值为
null) - m_returnfilds - MongoDB需要返回的字段.(默认值为
null) - m_connection
- m_servers - MongoDB服务器的地址.(replica结构,数组格式)
- m_authentication - 如果需要MongoDB的登录验证使用下面配置(默认值为
null).- username - MongoDB连接的用户名.
- password - MongoDB连接的密码.
- authsource - MongoDB用户认证,默认为
admin. - replicaset - MongoDB的repliac结构的名字.
- ssl - MongoDB的ssl.(默认值为false)
- m_documentsinbatch - 一次性从mongodb往Elasticsearch里传入数据的条数. (你可以设置比较大的值,默认为1000.).
- m_delaytime- 每次进elasticsearch数据的间隔时间(默认值为1000ms).
- e_index - ElasticSearch里的index.
- e_type - ElasticSearch里的type,这里的type主要为了使用bulk.
- e_connection
- e_server - ElasticSearch的连接字符串.
- e_httpauth - 如果ElasticSearch需要登录验证使用下面配置(默认值为
null).- username - ElasticSearch连接的用户名.
- password - ElasticSearch连接的密码.
- e_pipeline - ElasticSearch 中pipeline的名称.(没有pipeline就填null)
- e_iscontainattachment - pipeline是否包含附件规则(默认值为false).
四、如何使用
用户可以事先在/crawlerDataConfig目录下编辑好自己的配置文件,文件必须以json格式存放.
在文件根目录下,打开cmd命令窗口,输入以下信息:
node app.js
项目启动后,修改配置文件 (如:mycarts.json),数据也会实时同步。或者修改mongodb中的某一条数据,也会实时同步到elasticsearch中。
PS:如何把mongodb的主文档和附件信息都同步到elasticsearch中?
利用elasticsearch的pipeline来实现。
首先需要创建一个pipeline到elasticsearch中:
PUT _ingest/pipeline/mypipeline

{

  "description" : "Extract attachment information from arrays",

  "processors" : [

    {

      "foreach": {

        "field": "attachments",

        "processor": {

          "attachment": {

            "target_field": "_ingest._value.attachment",

            "field": "_ingest._value.data"

          }

        }

      }

    }

  ]

}
然后在配置文件中(如:mycarts.json)修改节点数据即可
"e_pipeline": "mypipeline"
五、结果展示
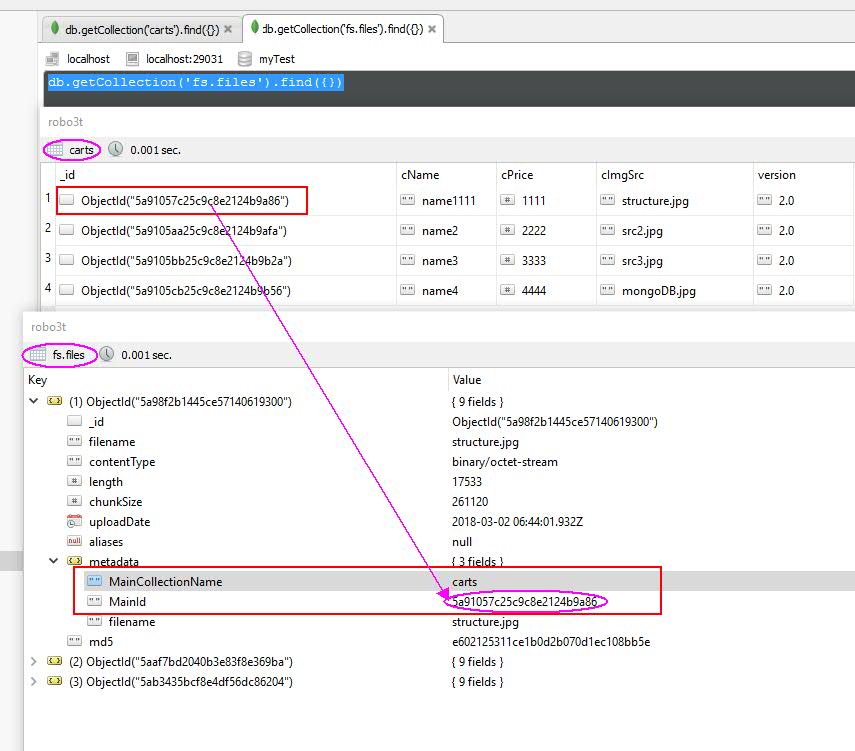
mongodb里面的数据
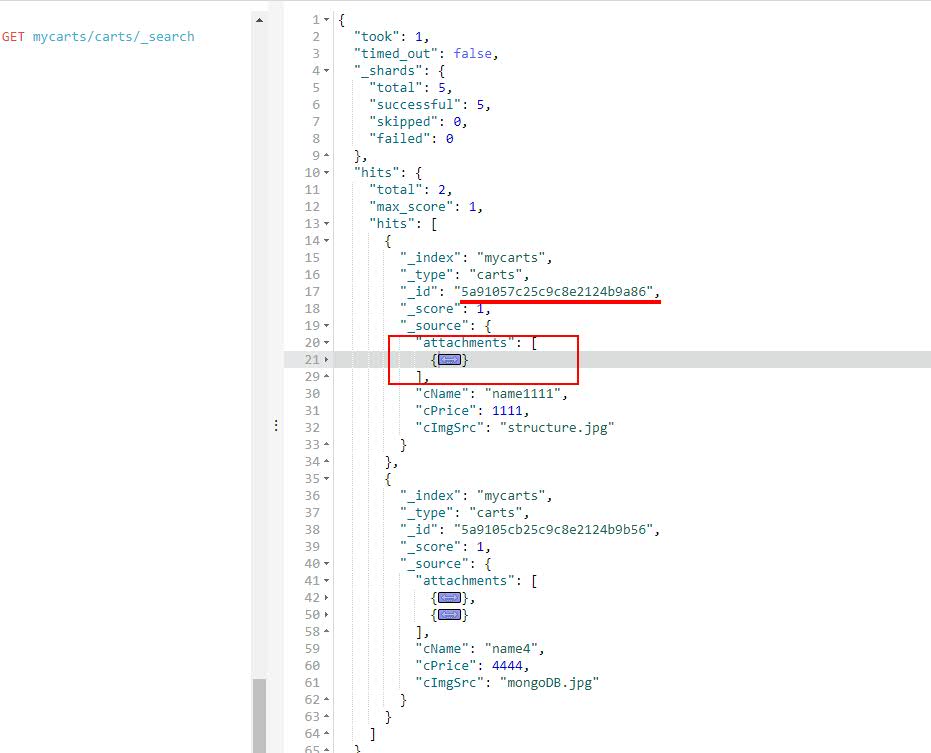
elasticsearch里面的数据
基于nodejs将mongodb的数据实时同步到elasticsearch的更多相关文章
- mysql数据实时同步到Elasticsearch
业务需要把mysql的数据实时同步到ES,实现低延迟的检索到ES中的数据或者进行其它数据分析处理.本文给出以同步mysql binlog的方式实时同步数据到ES的思路, 实践并验证该方式的可行性,以供 ...
- 基于netcore实现mongodb和ElasticSearch之间的数据实时同步的工具(Mongo2Es)
基于netcore实现mongodb和ElasticSearch之间的数据实时同步的工具 支持一对一,一对多,多对一和多对多的数据传输方式. 一对一 - 一个mongodb的collection对应一 ...
- sersync基于rsync+inotify实现数据实时同步
一.环境描述 需求:服务器A与服务器B为主备服务模式,需要保持文件一致性,现采用sersync基于rsync+inotify实现数据实时同步 主服务器A:192.168.1.23 从服务器B:192. ...
- sersync实现数据实时同步
1.1 第一个里程碑:安装sersync软件 1.1.1 将软件上传到服务器当中并解压 1.上传软件到服务器上 rz -E 为了便于管理上传位置统一设置为 /server/tools 中 2.解压软件 ...
- Linux下Rsync+sersync实现数据实时同步
inotify 的同步备份机制有着缺点,于是看了sersync同步,弥补了rsync的缺点.以下转自:http://www.osyunwei.com/archives/7447.html 前言: 一. ...
- Mysql数据实时同步
企业运维的数据库最常见的是 mysql;但是 mysql 有个缺陷:当数据量达到千万条的时候,mysql 的相关操作会变的非常迟缓; 如果这个时候有需求需要实时展示数据;对于 mysql 来说是一种灾 ...
- CentOS 6.5 rsync+inotify实现数据实时同步备份
CentOS 6.5 rsync+inotify实现数据实时同步备份 rsync remote sync 远程同步,同步是把数据从缓冲区同步到磁盘上去的.数据在内存缓存区完成之后还没有写入到磁盘 ...
- Rsync+sersync实现数据实时同步
前言: 一.为什么要用Rsync+sersync架构? 1.sersync是基于Inotify开发的,类似于Inotify-tools的工具 2.sersync可以记录下被监听目录中发生变化的(包括增 ...
- Linux下Rsync+Inotify-tools实现数据实时同步
Linux下Rsync+Inotify-tools实现数据实时同步 注意:下面的三个案例都是rsync 每次都是全量的同步(这就坑爹了),而且 file列表是循环形式触发rsync ,等于有10个文件 ...
随机推荐
- 安装Docker step by step
1. 系统要求 centos7以上 使用cat /etc/redhat-release查看系统版本,我的Centos 7.6 centos-extra 仓库 enable,默认是打开的 2.安装d ...
- 南宁AI项目
1.能了解并对项目整体进度情况有清晰的认识,什么时间点需要完成什么工作项. 2.认识了解项目干系人,能和客户独立沟通交流,理解现场业务,不要一问三不知,什么情况都不了. 3.能推动项目进展和问题及时处 ...
- React/数据流
“Props” 当 React 元素为用户自定义组件时,它会将 JSX 所接收的属性(attributes)转换为单个对象传递给组件,这个对象被称之为 “props”. props的只读性 组件无论是 ...
- 补充:Python安装
需要安装Python2.7.Numpy和Matplotlib.由于Python不支持向下兼容,因此在Python3.×下你一定能正常运行Python2.×的代码.上述模块最简单的安装方法就是用软件包安 ...
- windows的一些常用指令
持续更新中..... 1.清除系统内 DNS 的缓冲 : nslookup baidu.com 2.修改hosts文件 : 位置 运行 -> C:/windows/system32/ ...
- 谷歌浏览器调试手机app内置网页
当自己的H5项目内置于手机app内时,遇到了样式问题或者想查看H5页面代码.数据交互以及缓存等情况来检查数据,此时可以使用谷歌浏览器的控制台远程调试手机,步骤如下: 一.手机开启允许usb调试 二.手 ...
- MySql Host is blocked because of many connection errors 问题的解决方法
错误日志: message from server: "Host '10.250.112.141' is blocked because of many connection errors; ...
- 第一章 Django之学习Django所需知识(3)
所需编程知识 本书读者需要理解基本的面向过程和面向对象编程:流程控制(if, while 和 for),数据结构(列表,哈希表/字典),变量,类和对象. Web 开发经验,正如你所想的,也是非常有帮助 ...
- c语言的函数指针和函数指针数组的简单demo
今天,简单记录一下,函数指针和函数指针数组的使用,废话不多说,直接贴上代码,里面有详细的注释,方便以后查阅. #include <cstdio> #include <Windows. ...
- 深入理解Kubernetes资源限制:CPU
写在前面 在上一篇关于Kubernetes资源限制的文章我们讨论了如何通过ResourceRequirements设置Pod中容器内存限制,以及容器运行时是如何利用Linux Cgroups实现这些限 ...