
phoenix到hbase的应用
一、phoenix的简介
hbase的java api或者其语法很难用,可以认为phoenix是一个中间件,提供了访问hbase的另外的语法。
二、配置phoenix和hbase
1.下载
phoenix的官网是:http://phoenix.apache.org/,用户可以到该网址找到对应hbase版本的phoenix来下载。
这里使用的是phoenix-4.6.0-HBase-0.98-bin.tar.gz这个包
2.解压并拷贝文件
tar -zxvf phoenix-4.6.0-HBase-0.98-bin.tar.gz -C /usr/local/
解压完成后可以看到如下的目录:
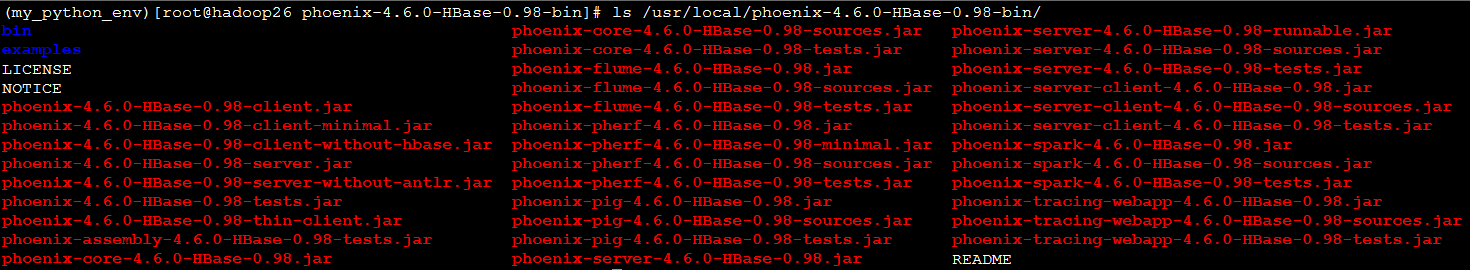
其中雷系tests.jar和sources.jar是没有用的,可以删除掉
rm -f *-tests.jar
rm -f *-sources.jar
然后拷贝这些jar文件到hbase的安装目录下
cp *.jar ../hbase-0.98.8-hadoop2/lib/
重启region server即可
./hbase-daemon.sh stop regionserver
./hbase-daemon.sh start regionserver
3.执行sqlline.py
进入到phoenix的bin目录,执行sqlline.py 命令的参数是zk的地址
三、使用phoenix
3.1在phoenix中创建表
create table student(id varchar(64) not null primary key,name varchar(64),age integer);
可以看到在hbase中也出现了一张表
["STUDENT", "SYSTEM.CATALOG", "SYSTEM.FUNCTION", "SYSTEM.SEQUENCE", "SYSTEM.STATS"]

在phoenix中创建的表,表名会自动变成大写。并且列族是0
3.2使用phoenix插入或者更新数据
upsert into STUDENT (id,name,age) values ('1','zhangsan',25);
upsert into STUDENT (id,name,age) values ('2','lisi',20);
3.3使用phoenix查询数据
select * from STUDENT where age > 20;
四、关于phoenix的小问题
1.如何创建小写的表名?
create table "student"("id" varchar(64) not null primary key,name varchar(64),age interger);
2.如何创建自定义列族的表?
create table "student2"("id" varchar(64) not null primary key ,"cf"."name" varchar(64),"cf"."age" integer);
phoenix到hbase的应用的更多相关文章
- [saiku] 使用 Apache Phoenix and HBase 结合 saiku 做大数据查询分析
saiku不仅可以对传统的RDBMS里面的数据做OLAP分析,还可以对Nosql数据库如Hbase做统计分析. 本文简单介绍下一个使用saiku去查询分析hbase数据的例子. 1.phoenix和h ...
- 浅谈Phoenix在HBase中的应用
一.前言 业务使用HBase已经有一段时间了,期间也反馈了很多问题,其中反馈最多的是HBase是否支持SQL查询和二级索引,由于HBase在这两块上目前暂不支持,导致业务在使用时无法更好的利用现有的经 ...
- 通过phoenix在hbase上创建二级索引,Secondary Indexing
环境描述: 操作系统版本:CentOS release 6.5 (Final) 内核版本:2.6.32-431.el6.x86_64 phoenix版本:phoenix-4.10.0 hbase版本: ...
- phoenix连接hbase数据库,创建二级索引报错:Error: org.apache.phoenix.exception.PhoenixIOException: Failed after attempts=36, exceptions: Tue Mar 06 10:32:02 CST 2018, null, java.net.SocketTimeoutException: callTimeou
v\:* {behavior:url(#default#VML);} o\:* {behavior:url(#default#VML);} w\:* {behavior:url(#default#VM ...
- Hadoop生态圈-phoenix(HBase)的索引配置
Hadoop生态圈-phoenix(HBase)的索引配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 创建索引是为了优化查询,我们可以在phoenix上配置索引方式. 一.修改 ...
- Phoenix 映射 HBase + Maven
声明 本文基于 Centos6.x + CDH5.x 什么是Phoenix Phoenix的团队用了一句话概括Phoenix:"We put the SQL back in NoSQL&qu ...
- Phoenix on HBase
(一)概要 Apache Phoenix是基于BSD许可开源的一个Java中间层,可以让开发者在Apache HBase上执行SQL查询.Apache Phoenix主要特性: 嵌入式的JDBC驱动, ...
- 关于phoenix构建hbase视图,更新hbase表后,视图表是否更新的验证
1:创建表 create 'MY_TABLE', 'CF1','CF2' 2:在hbase上插入一条数据 put ' ,'CF1:V1', 'uwo1' 3:在phoenix上创建视图 create ...
- 基于Phoenix对HBase建索引
参考: Phoenix与HBase集成进行数据分析 HBase查询速度慢原因排查 操作1,执行查询,如下: : jdbc:phoenix:node3::/hbase> SELECT * FROM ...
随机推荐
- SRM12 T2夏令营(分治优化DP+主席树 (已更新NKlogN)/ 线段树优化DP)
先写出朴素的DP方程f[i][j]=f[k][j-1]+h[k+1][i] {k<i}(h表示[k+1,j]有几个不同的数) 显然时间空间复杂度都无法承受 仔细想想可以发现对于一个点 i ...
- [学习笔记]Segment Tree Beats!九老师线段树
对于这样一类问题: 区间取min,区间求和. N<=100000 要求O(nlogn)级别的算法 直观体会一下,区间取min,还要维护区间和 增加的长度很不好求.... 然鹅, 从前有一个来自杭 ...
- selenium - 获取断言信息
断言:通过脚本提取相应元素的数值,将实际结果与预期结果进行比较.通常获取title,URL,text等信息进行断言. from selenium import webdriver from time ...
- Atlantis HDU - 1542 (线段树扫描线)
There are several ancient Greek texts that contain descriptions of the fabled island Atlantis. Some ...
- bzoj 1135 [POI2009]Lyz 线段树+hall定理
1135: [POI2009]Lyz Time Limit: 10 Sec Memory Limit: 162 MBSubmit: 573 Solved: 280[Submit][Status][ ...
- Leetcode 703. 数据流中的第K大元素
1.题目要求 设计一个找到数据流中第K大元素的类(class).注意是排序后的第K大元素,不是第K个不同的元素. 你的 KthLargest 类需要一个同时接收整数 k 和整数数组nums 的构造器, ...
- CentOS 下安装Mplayer播放器(转载)
一.准备工作 需要的安装包及下载地址:1.mplayer源代码包(MPlayer-1.0rc4.tar.bz2)下载:http://www.mplayerhq.hu/MPlayer/releases/ ...
- JS判断内容为空方法总结
HTML代码: 用户名:<input type="text" id="username"> <p style="color:red& ...
- Cppcheck代码分析下
1.流解析 解析函数中的可能的代码执行流, 函数实际执行中只会执行代码流中的一条流 分析: 分支语句 if-else ,switch-case 循环语句 while, do-while ...
- 元类编程-- __new__和__init__的区别
class User: def __new__(cls, *args, **kwargs): print (" in new ") return super().__new__(c ...