
在Spark shell中基于HDFS文件系统进行wordcount交互式分析
Spark是一个分布式内存计算框架,可部署在YARN或者MESOS管理的分布式系统中(Fully Distributed),也可以以Pseudo Distributed方式部署在单个机器上面,还可以以Standalone方式部署在单个机器上面。运行Spark的方式有interactive和submit方式。本文中所有的操作都是以interactive方式操作以Standalone方式部署的Spark。具体的部署方式,请参考Hadoop Ecosystem。
HDFS是一个分布式的文件管理系统,其随着Hadoop的安装而进行默认安装。部署方式有本地模式和集群模式,本文中使用的时本地模式。具体的部署方式,请参考Hadoop Ecosystem。
目标:
能够通过HDFS文件系统在Spark-shell中进行WordCount的操作。
前提:
存在一个文件,可通过下面的命令进行查看。
hadoop fs -ls /
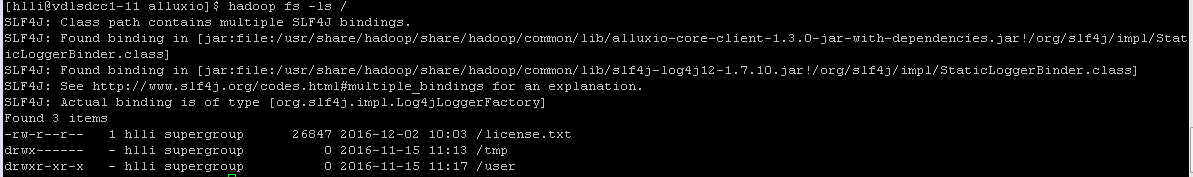
如果不存在,添加一个(LICENSE文件需要在本地目录中存在)。更多hadoop命令,请参考hadoop命令。
hadoop fs -put LICENSE /license.txt
通过Web Browser查看Hadoop是否已经运行。
http://localhost:50070

步骤:
Step 1:进入Spark-shell交互式命令行。
spark-shell
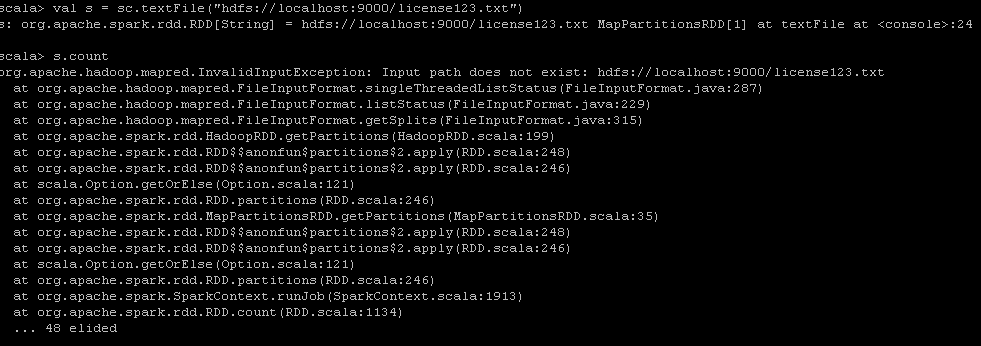
Step 2:读取license.txt文件,并check读取是否成功。如果不存在,则提示如下错误。
val s = sc.textFile("hdfs://localhost:9000/license.txt")
s.count
Step 3:设定输出的文件个数并执行统计逻辑
val numOutputFiles = 128
val counts = s.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey(_ + _, numOutputFiles)
Step 4:保存计算结果到HDFS中
counts.saveAsTextFile("hdfs://localhost:9000/license_hdfs.txt")
Step 5:在shell中查看结果
hadoop fs -cat /license_hdfs.txt/*
结论:
通过HDFS,我们可以在Spark-shell中轻松地进行交互式的分析(word count统计)。
参考资料:
http://hadoop.apache.org/docs/r1.0.4/cn/commands_manual.html
http://spark.apache.org/docs/latest/programming-guide.html
http://coe4bd.github.io/HadoopHowTo/sparkScala/sparkScala.html
http://coe4bd.github.io/HadoopHowTo/sparkJava/sparkJava.html
在Spark shell中基于HDFS文件系统进行wordcount交互式分析的更多相关文章
- 在Spark shell中基于Alluxio进行wordcount交互式分析
Spark是一个分布式内存计算框架,可部署在YARN或者MESOS管理的分布式系统中(Fully Distributed),也可以以Pseudo Distributed方式部署在单个机器上面,还可以以 ...
- 输入DStream之基础数据源以及基于HDFS的实时wordcount程序
输入DStream之基础数据源以及基于HDFS的实时wordcount程序 一.Java方式 二.Scala方式 基于HDFS文件的实时计算,其实就是,监控一个HDFS目录,只要其中有新文件出现,就实 ...
- 52、Spark Streaming之输入DStream之基础数据源以及基于HDFS的实时wordcount程序
一.概述 1.Socket:之前的wordcount例子,已经演示过了,StreamingContext.socketTextStream() 2.HDFS文件 基于HDFS文件的实时计算,其实就是, ...
- Spark MLlib LDA 基于GraphX实现原理及源代码分析
LDA背景 LDA(隐含狄利克雷分布)是一个主题聚类模型,是当前主题聚类领域最火.最有力的模型之中的一个,它能通过多轮迭代把特征向量集合按主题分类.眼下,广泛运用在文本主题聚类中. LDA的开源实现有 ...
- 在spark udf中读取hdfs上的文件
某些场景下,我们在写UDF实现业务逻辑时候,可能需要去读取某个文件. 我们可以将此文件上传个hdfs某个路径下,然后通过hdfs api读取该文件,但是需要注意: UDF中读取文件部分最好放在静态代码 ...
- cloudera manager安装spark后使用spark shell编写基于scala的world count
val file = sc.textFile("hdfs://zhcloudil-lcnode04:8020/user/cloudil/wc_spark.txt") val cou ...
- Spark Shell简单使用
基础 Spark的shell作为一个强大的交互式数据分析工具,提供了一个简单的方式学习API.它可以使用Scala(在Java虚拟机上运行现有的Java库的一个很好方式)或Python.在Spark目 ...
- Hadoop Shell命令(基于linux操作系统上传下载文件到hdfs文件系统基本命令学习)
Apache-->hadoop的官网文档命令学习:http://hadoop.apache.org/docs/r1.0.4/cn/hdfs_shell.html FS Shell 调用文件系统( ...
- Tachyon:Spark生态系统中的分布式内存文件系统
转自: http://www.csdn.net/article/2015-06-25/2825056 摘要:Tachyon把内存存储的功能从Spark中分离出来, 使Spark可以更专注计算的本身, ...
随机推荐
- DELPHI XE5 UP2 运行IOS 遇到 Wrapper init failed: (null)问题的解决办法
一.问题表现: 在MAC OSX(10.9.2)上安装了比较新的XCODE5.1 和COMMAND LINE TOOLS 在DELPHI XE5 UP2上放了一个按钮,输出到MAC OSX上,出现: ...
- Android ActionBar仿微信界面
ActionBar仿微信界面 1.学习了别人的两篇关于ActionBar博客,在结合别人的文章来仿造一下微信的界面: 思路如下:1).利用ActionBar生成界面的头部,在用ActionBar的Ac ...
- CString::MakeLower Crash
记录一下使用CString::MakeLower可能导致的crash的一个问题: 问题重现: int _tmain(int argc, _TCHAR* argv[]){ std::string sT ...
- C++的惨痛教训(未完待续)
题记:只有痛才能让人铭记!痛促进进步~ 1. strncpy,大家都知道要做安全检查,可是谁都有嫌麻烦的时候,尤其是自己很自信不会产生溢出的时候,可能不会坑了自己,却会坑了使用这段代码的人.所以,1. ...
- 去你妹的DDD 又在误人子弟!
这种模式只会让人绕弯路 什么聚合根, 什么仓储 ! 实现这些有个J8用? EF本身就是仓储模式 你说是为了切换不同数据库吧 统一事物?我TM 用Sqsugar一样能平滑切换和统一事物, 还不用改代码 ...
- C#常见编译报错
mCaster.PlayAnim(ANIMID.ASTD); No overload for method 'PlayAnim' takes '1' arguments PlayAnim()内有两个参 ...
- Vue Vuex state mutations
Vuex 解决不同组件的数据共享,与数据持久化 1.npm install vuex --save 2.新建store.js 并引入vue vuex ,Vue.use(Vuex) 3.state在vu ...
- mvc - view传值到js
http://www.cnblogs.com/akwwl/p/5238975.html
- springMVC+spring+mybatis多数据源配置
1.application.properties配置 <?xml version="1.0" encoding="UTF-8"?> <bean ...
- bitest(位集合)------c++程序设计原理与实践(进阶篇)
标准库模板类bitset是在<bitset>中定义的,它用于描述和处理二进制位集合.每个bitset的大小是固定的,在创建时指定: bitset<4> flags; bitse ...