
Java爬取先知论坛文章
Java爬取先知论坛文章
0x00 前言
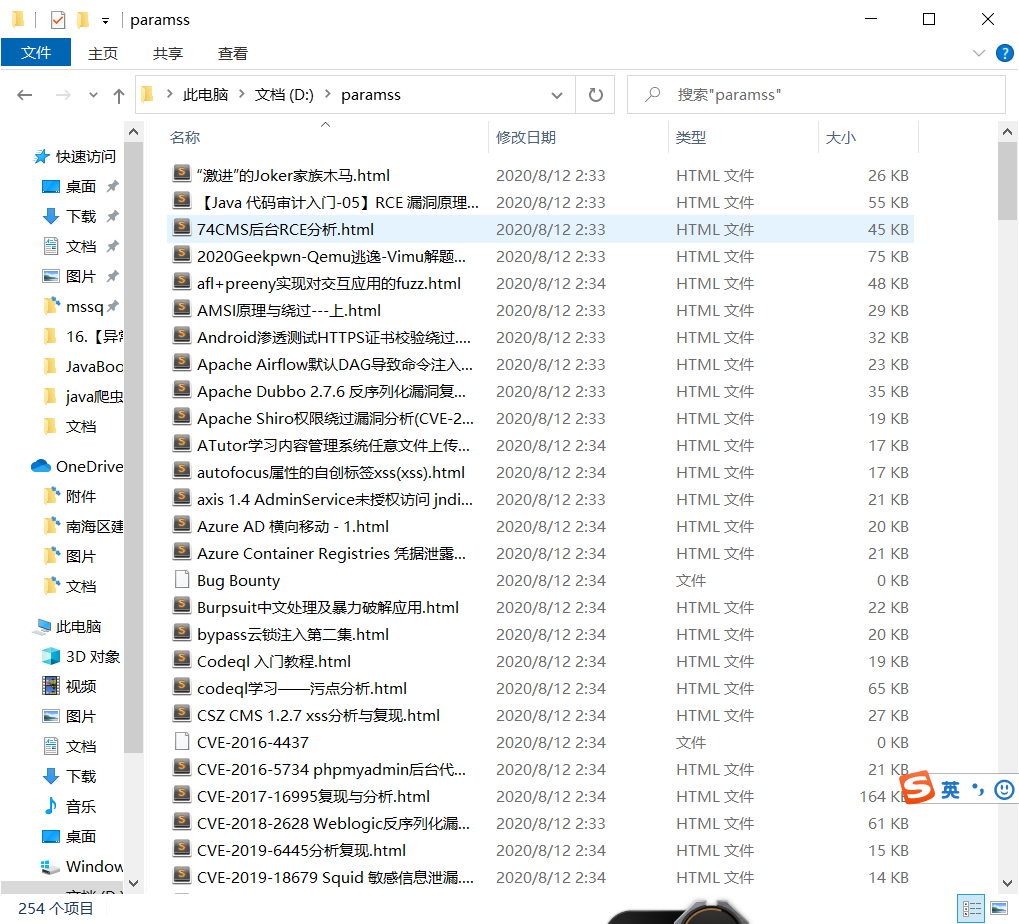
上篇文章写了部分爬虫代码,这里给出一个完整的爬取先知论坛文章代码。
0x01 代码实现
pom.xml加入依赖:
<dependencies>

        <!-- https://mvnrepository.com/artifact/org.apache.httpcomponents/httpclient -->

        <dependency>

            <groupId>org.apache.httpcomponents</groupId>

            <artifactId>httpclient</artifactId>

            <version>4.5.3</version>

        </dependency>

        <!-- https://mvnrepository.com/artifact/org.jsoup/jsoup -->

        <dependency>

            <groupId>org.jsoup</groupId>

            <artifactId>jsoup</artifactId>

            <version>1.11.3</version>

        </dependency>

        <!-- https://mvnrepository.com/artifact/commons-io/commons-io -->

        <dependency>

            <groupId>commons-io</groupId>

            <artifactId>commons-io</artifactId>

            <version>2.4</version>

        </dependency>

        <!-- https://mvnrepository.com/artifact/org.apache.commons/commons-lang3 -->

        <dependency>

            <groupId>org.apache.commons</groupId>

            <artifactId>commons-lang3</artifactId>

            <version>3.7</version>

        </dependency>

        <!-- https://mvnrepository.com/artifact/junit/junit -->

        <dependency>

            <groupId>junit</groupId>

            <artifactId>junit</artifactId>

            <version>4.12</version>

            <scope>test</scope>

        </dependency>

    </dependencies>
实现代码
实现类:
package xianzhi;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.select.Elements;

import java.io.BufferedOutputStream;

import java.io.File;

import java.io.FileOutputStream;

import java.io.IOException;

import java.net.URL;

import java.util.List;

import java.util.concurrent.locks.Lock;

import java.util.concurrent.locks.ReentrantLock;

public class Climbimpl implements Runnable {

    private String url ;

    private int pages;

    private String filename;

    Lock lock = new ReentrantLock();

    public Climbimpl(String url, int pages,String filename) {

        this.url = url;

        this.pages = pages;

        this.filename = filename;

    }

    public void run() {

        File file = new File(this.filename);

        boolean mkdir = file.mkdir();

        if (mkdir){

            System.out.println("目录已创建");

        }

        lock.lock();

//        String url = "https://xz.aliyun.com/";

        for (int i = 1; i < this.pages; i++) {

            try {

            String requesturl = this.url+"?page="+i;

            Document doc = null;

            doc = Jsoup.parse(new URL(requesturl), 10000);

            Elements element = doc.getElementsByClass("topic-title");

            List<String> href = element.eachAttr("href");

                for (String s : href) {

                    try{

                        Document requests = Jsoup.parse(new URL(this.url+s), 100000);

//                        String topic_content = requests.getElementById("topic_content").text();

                        String titile = requests.getElementsByClass("content-title").first().text();

                        System.out.println("已爬取"+titile+"->"+this.filename+titile+".html");

                        BufferedOutputStream bufferedOutputStream = new BufferedOutputStream(new FileOutputStream(this.filename+titile+".html"));

                        bufferedOutputStream.write(requests.toString().getBytes());

                        bufferedOutputStream.flush();

                        bufferedOutputStream.close();

                    }catch (Exception e){

                        System.out.println("爬取"+this.url+s+"报错"+"报错信息"+e);

                    }

                }

            } catch (IOException e) {

                e.printStackTrace();

            }

        }

        lock.unlock();

    }

}
main类:
package xianzhi;

public class TestClimb {

    public static void main(String[] args) {

        int Threadlist_num = 10; //线程数

        String url = "https://xz.aliyun.com/";  //设置url

        int pages = 10; //读取页数

        String path = "D:\\paramss\\";  //设置保存路径

        Climbimpl climbimpl = new Climbimpl(url,pages,path);

        for (int i = 0; i < Threadlist_num; i++) {

            new Thread(climbimpl).start();

        }

    }

}
0x03 结尾
该爬虫总体的代码都比较简单。
Java爬取先知论坛文章的更多相关文章
- Java爬取校内论坛新帖
Java爬取校内论坛新帖 为了保持消息灵通,博主没事会上上校内论坛看看新帖,作为爬虫爱好者,博主萌生了写个爬虫自动下载的想法. 嗯,这次就选Java. 第三方库准备 Jsoup Jsoup是一款比较好 ...
- 信息领域热词分析系统--java爬取CSDN中文章标题即链接
package zuoye1; import java.sql.Connection;import java.sql.PreparedStatement;import java.sql.SQLExce ...
- Java爬取网络博客文章
前言 近期本人在某云上购买了个人域名,本想着以后购买与服务器搭建自己的个人网站,由于需要筹备的太多,暂时先搁置了,想着先借用GitHub Pages搭建一个静态的站,搭建的过程其实也曲折,主要是域名地 ...
- MinerHtmlThread.java 爬取页面线程
MinerHtmlThread.java 爬取页面线程 package com.iteye.injavawetrust.miner; import org.apache.commons.logging ...
- MinerConfig.java 爬取配置类
MinerConfig.java 爬取配置类 package com.iteye.injavawetrust.miner; import java.util.List; /** * 爬取配置类 * @ ...
- Java爬取B站弹幕 —— Python云图Wordcloud生成弹幕词云
一 . Java爬取B站弹幕 弹幕的存储位置 如何通过B站视频AV号找到弹幕对应的xml文件号 首先爬取视频网页,将对应视频网页源码获得 就可以找到该视频的av号aid=8678034 还有弹幕序号, ...
- java爬取网页内容 简单例子(2)——附jsoup的select用法详解
[背景] 在上一篇博文java爬取网页内容 简单例子(1)——使用正则表达式 里面,介绍了如何使用正则表达式去解析网页的内容,虽然该正则表达式比较通用,但繁琐,代码量多,现实中想要想出一条简单的正则表 ...
- 【Python】爬取理想论坛单帖爬虫
代码: # 单帖爬虫,用于爬取理想论坛帖子得到发帖人,发帖时间和回帖时间,url例子见main函数 from bs4 import BeautifulSoup import requests impo ...
- java爬取并下载酷狗TOP500歌曲
是这样的,之前买车送的垃圾记录仪不能用了,这两天狠心买了好点的记录仪,带导航.音乐.蓝牙.4G等功能,寻思,既然有这些功能就利用起来,用4G听歌有点奢侈,就准备去酷狗下点歌听,居然都是需要办会员才能下 ...
随机推荐
- 深度学习趣谈:什么是迁移学习?(附带Tensorflow代码实现)
一.迁移学习的概念 什么是迁移学习呢?迁移学习可以由下面的这张图来表示: 这张图最左边表示了迁移学习也就是把已经训练好的模型和权重直接纳入到新的数据集当中进行训练,但是我们只改变之前模型的分类器(全连 ...
- less : 解决升级后报错的问题
vue2项目. 上版本. { "name": "xxx", "version": "1.0.0", "desc ...
- SpringBoot2 整合FreeMarker模板,完成页面静态化处理
本文源码:GitHub·点这里 || GitEE·点这里 一.页面静态化 1.动静态页面 静态页面 即静态网页,指已经装载好内容HTML页面,无需经过请求服务器数据和编译过程,直接加载到客户浏览器上显 ...
- 《闲扯Redis七》Redis字典结构的底层实现
一.前言 上节<闲扯Redis六>Redis五种数据类型之Hash型 中说到 Hash(哈希对象)的底层实现有: 1.ziplist 编码的哈希对象使用压缩列表作为底层实现 2.hasht ...
- 5G UE能力-UE capability information解析(ENDC)
本文主要以EN-DC(双连接),mmw(毫米波)的接入过程中的为例,其他以此类推,整理不易,望多推荐 第一次UE能力问询 第一次能力问询主要是基站向UE问询4G和3G能力 第一次UE能力上报 第一次U ...
- Lun4R-CyBRICSCTF wp
WEB Hunt (Web, Baby, 50 pts) 打断点,然后就一个一个被抓住了... 接着F12就出现了.(这个flag是白色的,藏在下面....)... RE Baby Rev 题目给了个 ...
- Android存储--SharedPreferences
简介 在Android中,主要有以下几种存储方式: SharedPreferences,在键值对中存储私有原始数据. 内部存储,在设备内存中存储私有数据. 官方示例: String FILENAME ...
- 如何在Linux下的C++文件使用GDB调试
首先在Linux下写好一个.Cpp的文件. #include<stdio.h> #include<stdlib.h> using namespace std; void sho ...
- Django学习路23_if else 语句,if elif else 语句 forloop.first第一个元素 .last最后一个元素,注释
if else 格式 {% if 条件 %} <标签>语句</标签> {%else%} <标签>语句</标签> {%endif} 标签都可以添加样式 { ...
- 7.29 NOI模拟赛 题答 npc问题 三染色 随机 贪心
LINK:03colors 这道题虽然绝大多数的人都获得了满分 可是我却没有. 老师讲题的时候讲到了做题答的几个技巧 这里总结一下. 数据强度大概为n=5000,m=60000的随机数据. 老师说:一 ...