
Kafka架构深入:Kafka 工作流程及文件存储机制
kafka工作流程:
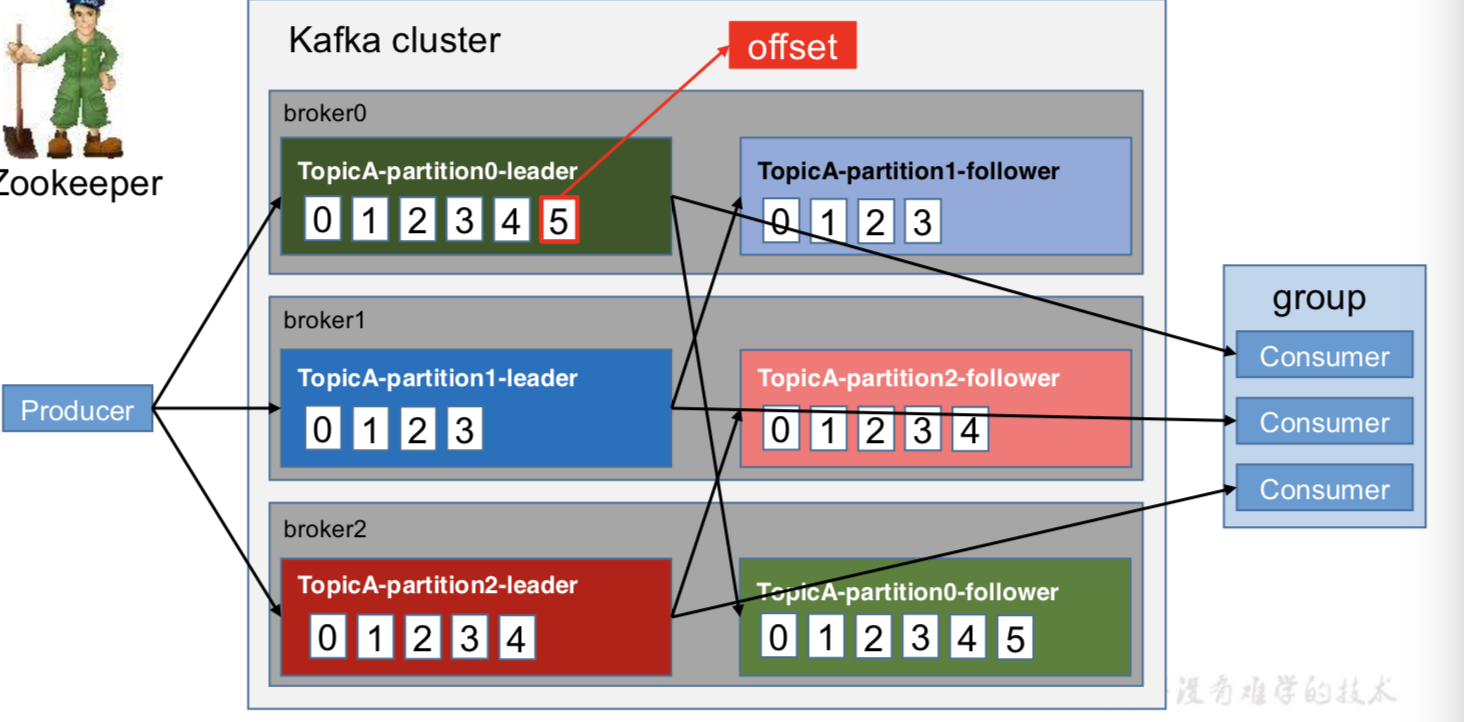
每个分区都有一个offset消费偏移量,kafka并不能保证全局有序性。
Kafka 中消息是以 topic 进行分类的,生产者生产消息,消费者消费消息,都是面向 topic 的。(文件topic_partition命名)
topic 是逻辑上的概念,而 partition 是物理上的概念,每个 partition 对应于一个 log 文 件,该 log 文件中存储的就是 producer 生产的数据。Producer 生产的数据会被不断追加到该 log 文件末端,且每条数据都有自己的 offset。消费者组中的每个消费者,都会实时记录自己 消费到了哪个 offset,以便出错恢复时,从上次的位置继续消费。
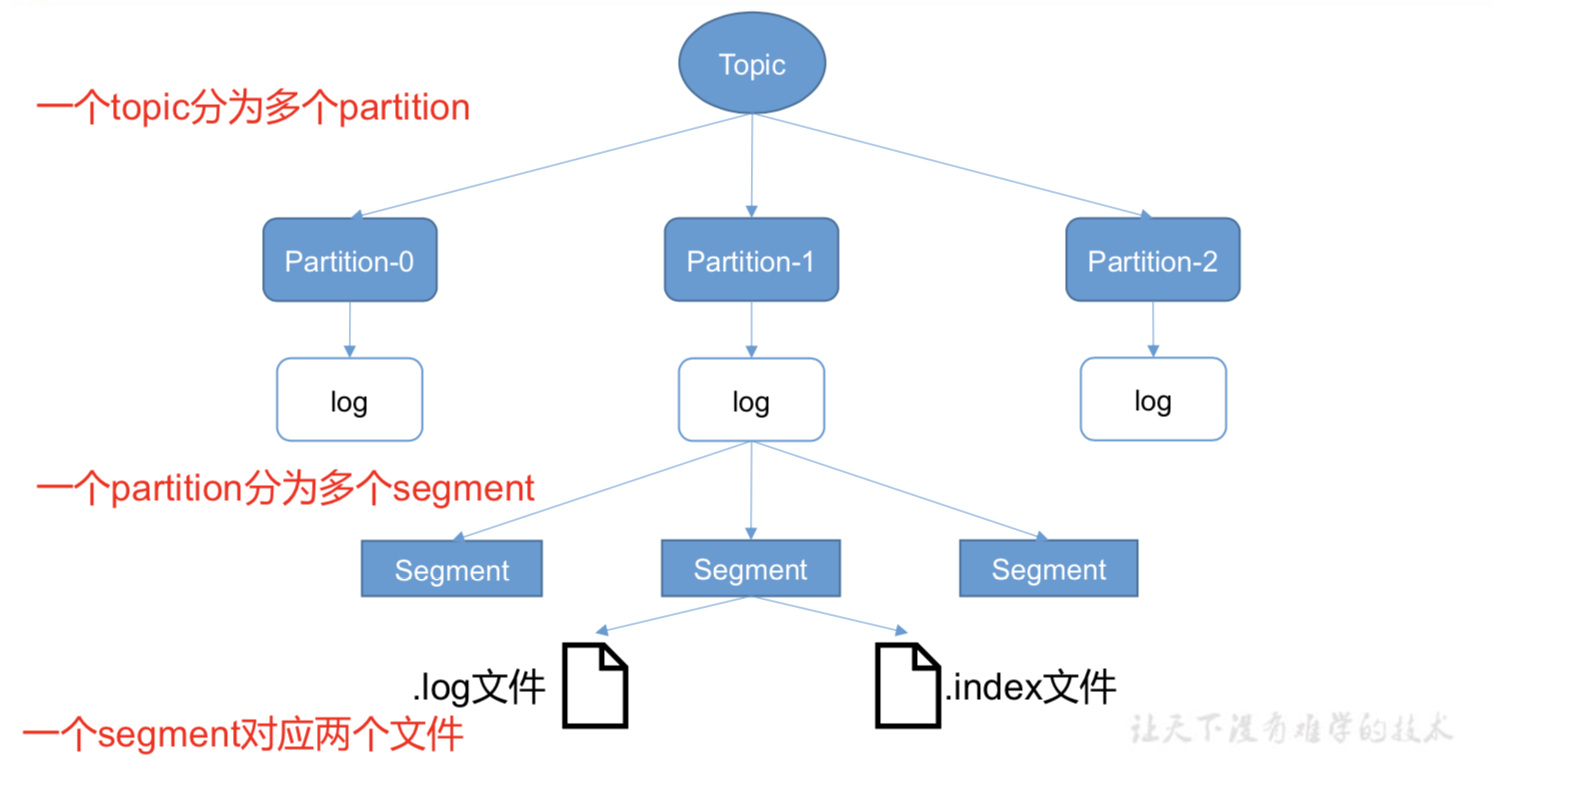
log中存的是实际数据,默认存储7天。
xxxxx.log文件
xxxxx.index文件
log.segment.bytes=1073741824 (1G)
1、当超过1G,会再建一个新的xxxxxxxxx.log数据文件。(一个segment)
2、如何在文件中快速定位到消费者需要的数据(xxxxx.index文件)
由于生产者生产的消息会不断追加到 log 文件末尾,为防止 log 文件过大导致数据定位 效率低下,Kafka 采取了分片和索引机制,将每个 partition 分为多个 segment。每个 segment 对应两个文件——“.index”文件和“.log”文件。这些文件位于一个文件夹下,该文件夹的命名 规则为:topic 名称+分区序号。例如,first 这个 topic 有三个分区,则其对应的文件夹为 first- 0,first-1,first-2。
index 和 log 文件以当前 segment 的第一条消息的 offset 命名。下图为 index 文件和 log 文件的结构示意图。
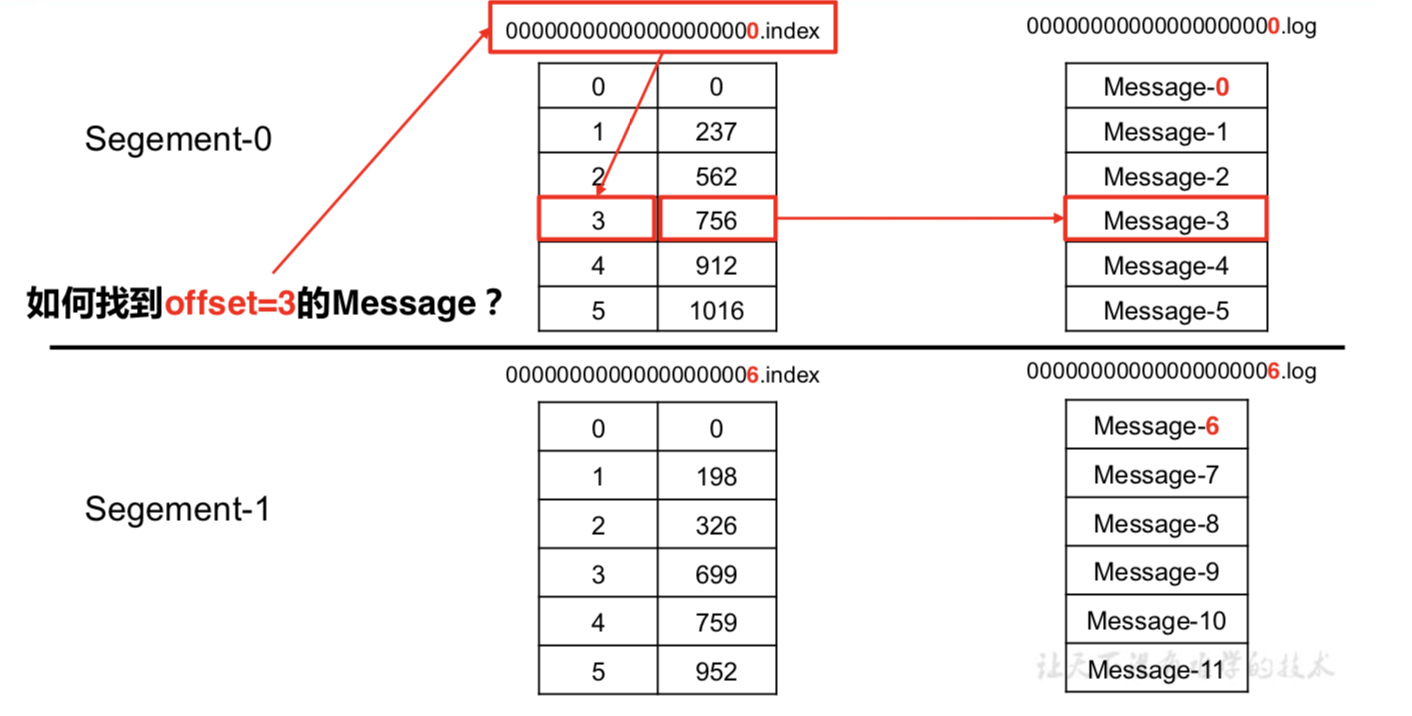
“.index”文件存储大量的索引信息,“.log”文件存储大量的数据,索引文件中的元 数据指向对应数据文件中 message 的物理偏移地址。 (先通过二分查找,找到消息在某个xxxx.log文件,再去xxxx.index去找消息开头在log中的物理偏移地址)
index文件中每项数据大小一样,不仅存储了每条messge的起始位置,还有每条消息的大小:上图未画出。 利用起始位置+消息大小,读取整个消息
Kafka架构深入:Kafka 工作流程及文件存储机制的更多相关文章
- 深入了解Kafka【二】工作流程及文件存储机制
1.Kafka工作流程 Kafka中的消息以Topic进行分类,生产者与消费者都是面向Topic处理数据. Topic是逻辑上的概念,而Partition是物理上的概念,每个Partition分为多个 ...
- Kafka与RocketMq文件存储机制对比
一个商业化消息队列的性能好坏,其文件存储机制设计是衡量一个消息队列服务技术水平和最关键指标之一. 开头问题 kafka文件结构和rocketMQ文件结构是什么样子?特点是什么? 一.目录结构 Kafk ...
- kafka知识体系-kafka设计和原理分析-kafka文件存储机制
kafka文件存储机制 topic中partition存储分布 假设实验环境中Kafka集群只有一个broker,xxx/message-folder为数据文件存储根目录,在Kafka broker中 ...
- Kafka文件存储机制及partition和offset
转载自: https://yq.aliyun.com/ziliao/65771 参考: Kafka集群partition replication默认自动分配分析 如何为kafka选择合适的p ...
- Kafka文件存储机制及offset存取
Kafka是什么 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx ...
- Kafka文件存储机制那些事
Kafka是什么 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx ...
- Kafka 文件存储机制那些事 - 美团技术团队
出处:https://tech.meituan.com/2015/01/13/kafka-fs-design-theory.html 自己总结: Kafka 文件存储机制_结构图:https://ww ...
- kafka学习之-文件存储机制
Kafka是什么 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx ...
- 转】 Kafka文件存储机制那些事
原博文出自于:http://tech.meituan.com/kafka-fs-design-theory.html 感谢! Kafka是什么 Kafka是最初由Linkedin公司开发,是一个 ...
随机推荐
- bufferedReader 读取文件第一行第一个字符丢失问题
在做一个解析pacp文件的时候需要读取文件中的每个属性,但是每次读出来的内容的每一行的第一个字符都被吞掉了,找了半天不知道为什么,后来看到在读取的时候用的read()方法,而且返回值是int类型,在变 ...
- 多测师讲解自动化_rf框架搭建_高级讲师肖sir
robot framework:自动化测试框架(简称RF框架) Python3.7 RIDE(可视化界面). Wxpython pip(在线下载) . setuptools(在线安装) . 第三方 ...
- 多测师讲解pthon _函数__return_高级讲师肖sir
#函数中的返回的作用(return) 案例: #函数中的返回的作用:def fun(): #定义的一个函数 num =100 a=num/2 #print(a) #50.0 return a # pr ...
- Kibana基础之直接操作ElasticSearch
1.入门级别操作 Elasticsearch采用Rest风格API,其API就是一次http请求,你可以用任何工具发起http请求 创建索引的请求格式: 请求方式:PUT 请求路径:/索引库名 请求参 ...
- java axis调用带有soap头(soapheader)的.net webservice
使用axis调用.net带soapheader的webservice是如何实现的,现在贴出代码 <?xml version="1.0" encoding="utf- ...
- 想买保时捷的运维李先生学Java性能之 生存与毁灭
一.判断对象是否存活 1.引用计数算法 给对象中添加一个引用计数器,每当有一个地方引用它时,计数器就加1:当引用失效时,计数器的值就减1:任何时刻计数器为0的对象是不可能再被使用的.引用计 ...
- IntelliJ IDEA 使用指南:集成GIT客户端
一.安装GIT客户端 首先需要在本地安装好GIT的客户端. GIT客户端官网下载地址:https://www.git-scm.com/download/ 安装说明 Linux系统安装 使用yum指令 ...
- Mybatis---00Mybatis入门
一.什么是Mybatis Mybatis框架是一个半ORM框架.Mybatis是一个优秀的基于 java 的持久层框架,它内部封装了 jdbc,使开发者只需要关注 sql 语句本身,而不需要花费精力去 ...
- modbus协议开关量采集模块
modbus协议开关量采集模块是指的使用Modbus协议的进行信号的采集与控制的一种设备. Modbus 协议设备都具有唯一的 Modbus 地址,众山 DTU 默认 Modbus 地址为 100,用 ...
- 4G DTU的使用方法和应用领域
4G DTU是一种数据传输单元,通俗理解就是,用来传输数据的一种硬件.既然是用来传输数据的,那就能将它视为一个管道,也就是说,指令同过它传给设备,而管道是不对这些指令做出响应的. 4G DTU如何使用 ...