
Scrapy框架爬虫初探——中关村在线手机参数数据爬取
关于Scrapy如何安装部署的文章已经相当多了,但是网上实战的例子还不是很多,近来正好在学习该爬虫框架,就简单写了个Spider Demo来实践。
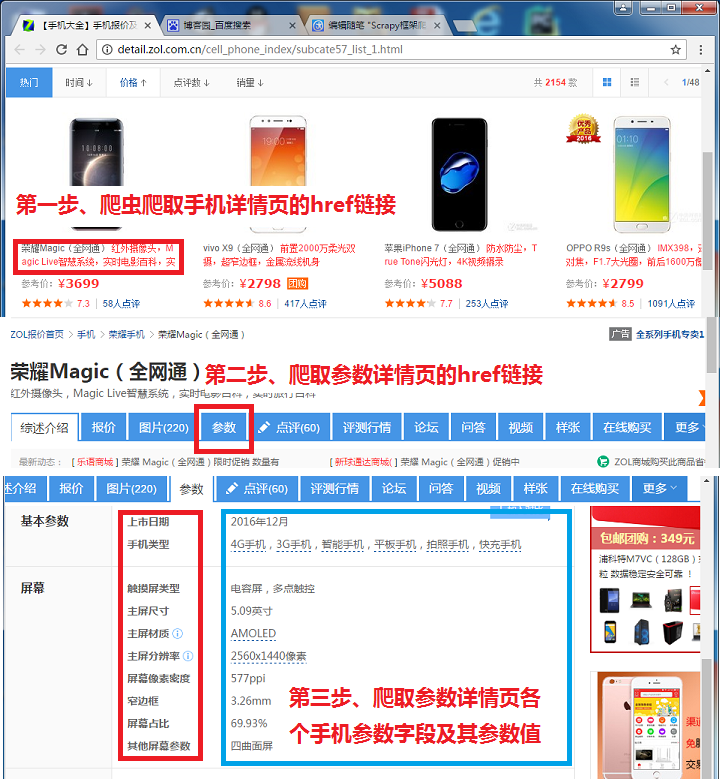
作为硬件数码控,我选择了经常光顾的中关村在线的手机页面进行爬取,大体思路如下图所示。
 # coding:utf-8

 import scrapy

 import re

 import os

 import sqlite3

 from myspider.items import SpiderItem

 class ZolSpider(scrapy.Spider):

     name = "zol"

     # allowed_domains = ["http://detail.zol.com.cn/"]  # 用于限定爬取的服务器域名

     start_urls = [

         # 主要爬去中关村在线的手机信息页面,考虑到是演示目的就仅仅爬了首页,其实爬分页跟二级爬虫原理相同,出于节省时间目的这里就不爬了

         # 这里可以写多个入口URL

         "http://detail.zol.com.cn/cell_phone_index/subcate57_list_1.html"

     ]

     item = SpiderItem()  # 没法动态创建,索性没用上,用的meta在spider函数间传值

     # 只是test一下就用sqlite吧,比较轻量化

     #database = sqlite3.connect(":memory:")

     database_file = os.path.dirname(os.path.abspath(__file__)) + "\\phonedata.db"

     if os.path.exists(database_file):

         os.remove(database_file)

     database = sqlite3.connect(database_file)

     # 先建个字段,方便理解字段含义就用中文了

     database.execute(

         '''

         CREATE TABLE CELL_PHONES

         (

         手机型号 TEXT

         );

         '''

     )

     # 用于检查数据增改是否全面,与total_changes对比

     counter = 0

     # 手机报价首页爬取函数

     def parse(self, response):

         # 获取手机详情页链接并以其创建二级爬虫

         hrefs = response.xpath("//h3/a")

         for href in hrefs:

             url = response.urljoin(href.xpath("@href")[0].extract())

             yield scrapy.Request(url, self.parse_detail_page)

     # 手机详情页爬取函数

     def parse_detail_page(self, response):

         # 通过xpath获取手机型号

         model = response.xpath("//h1").xpath("text()")[0].extract()

         # 创建该型号手机的数据库记录

         sql = 'INSERT INTO CELL_PHONES (手机型号) VALUES ("' + model + '")'

         self.counter += 1

         self.database.execute(sql)

         self.database.commit()

         # 获取参数详情页的链接

         url = response.urljoin(response.xpath("//div[@id='tagNav']//a[text()='参数']").xpath("@href")[0].extract())

         # 由于Scrapy是异步驱动的(逐级启动爬虫函数),所以当需绑定父子级爬虫函数间的某些变量时,可以采用meta字典传递,全局的item字段无法动态创建,在较灵活的爬取场景中不是很适用

         yield scrapy.Request(url, callback=self.parse_param_page, meta={'model': model})

     # 手机参数详情页爬取函数

     def parse_param_page(self, response):

         # 获取手机参数字段并一一遍历

         params = response.xpath("//span[contains(@class,'param-name')]")

         for param in params:

             legal_param_name_field = param_name = param.xpath("text()")[0].extract()

             # 将手机参数字段转变为合法的数据库字段(非数字开头,且防止SQL逻辑污染剔除了'/'符号)

             if re.match(r'^\d', param_name):

                 legal_param_name_field = re.sub(r'^\d', "f" + param_name[0], param_name)

             if '/' in param_name:

                 legal_param_name_field = legal_param_name_field.replace('/', '')

             # 通过查询master表检查动态添加的字段是否已经存在,若不存在则增加该字段

             sql = "SELECT * FROM sqlite_master WHERE name='CELL_PHONES' AND SQL LIKE '%" + legal_param_name_field + "%'"

             if self.database.execute(sql).fetchone() is None:

                 sql = "ALTER TABLE CELL_PHONES ADD " + legal_param_name_field + " TEXT"

                 self.database.execute(sql)

                 self.database.commit()

             # 根据参数字段名的xpath定位参数值元素

             xpath = "//span[contains(@class,'param-name') and text()='" + param_name +\

                     "']/following-sibling::span[contains(@id,'newPmVal')]//text()"

             vals = response.xpath(xpath)

             # 由于有些字段的参数值是多个值,所以需将其附加到一起,合成一个字段,以方便存储。

             # 如需数据细分选用like子句或支持全文索引的数据库也不错,当然nosql更好

             pm_val = ""

             for val in vals:

                 pm_val += val.extract()

             re.sub(r'\r|\n',"",pm_val)

             sql = "UPDATE CELL_PHONES SET %s = '%s' WHERE 手机型号 = '%s'" \

                   % (legal_param_name_field, pm_val, response.meta['model'])

             self.database.execute(sql)

             self.counter += 1

             # 检查下爬取的数据对不对

         results = self.database.execute("SELECT * FROM CELL_PHONES").fetchall()

         # 千万别忘了commit否则持久化数据库可能结果不全

         self.database.commit()

         print(self.database.total_changes, self.counter) # 对比下数据库的增改情况是否有丢失

         for row in results:

             print(row, end='\n')  # 其实这里有个小小的编码问题需要解决

         # 最后愉快的用scrapy crawl zol 启动爬虫吧!
部分爬到数据库的数据最后建议在settings脚本中修改USER_AGENT,以模拟浏览器请求,避免反爬,例如:
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'
当然高级点的反爬手段也有别的办法应付:
1.基于用户行为的爬取,可以增设爬取逻辑路由,以动态的爬行方式获取资源,并且频繁切换IP及UA,基于session及cookie的反爬亦可以基于此手段;
2.AJAX等异步js交互的页面,可自定义js请求,如果请求被加密了,结合selenium + webdriver来驱动浏览器,模拟用户交互异曲同工;
3.关于匹配方式,正则,XPath、CSS等等selector因人而异,前端经常调整的话不建议用CSS selector;
正则表达式从执行效率上较XPath会高一些,但是XPath可以基于元素逻辑层次、属性值条件,甚至结合XPath函数十分灵活的定位一个多个(组)元素;
总的来说做爬虫的同学,正则和XPath应该是基本功啦,特别是在定向爬取数据时尤为重要。
4.关于路由及任务调度问题,虽然Scrapy提供了非常简单的异步IO方案,能够轻松爬取多级页面,并根据base URL及灵活的自定义回调函数实现深层(有选择的)爬虫,
但对于爬取海量数据的场景,灵活性较差,因此队列管理(排重、防中断、防重跑)及分布式爬虫可能更为适用。
当然,学习Python爬虫,掌握urllib(2、3)、requests、BeautifulSoup、lxml等模块也会让你如虎添翼,还需因地制宜才是。
p.s.进来用Golang做爬虫的童鞋也多了起来,性能较之Python会好不少,可以尝试一下。会JAVA的童鞋,也可以关注下Nutch引擎。(路漫漫其修远兮啊,一起学习吧。)
Scrapy框架爬虫初探——中关村在线手机参数数据爬取的更多相关文章
- Python爬虫入门教程 29-100 手机APP数据抓取 pyspider
1. 手机APP数据----写在前面 继续练习pyspider的使用,最近搜索了一些这个框架的一些使用技巧,发现文档竟然挺难理解的,不过使用起来暂时没有障碍,估摸着,要在写个5篇左右关于这个框架的教程 ...
- python 手机app数据爬取
目录 一:爬取主要流程简述 二:抓包工具Charles 1.Charles的使用 2.安装 (1)安装链接 (2)须知 (3)安装后 3.证书配置 (1)证书配置说明 (2)windows系统安装证书 ...
- Python爬虫:用BeautifulSoup进行NBA数据爬取
爬虫主要就是要过滤掉网页中没用的信息.抓取网页中实用的信息 一般的爬虫架构为: 在python爬虫之前先要对网页的结构知识有一定的了解.如网页的标签,网页的语言等知识,推荐去W3School: W3s ...
- selenium在爬虫中的应用之动态数据爬取
一.selenium概念 selenium 是一个基于浏览器自动化的模块 selenium爬虫之间的关联: 1.便捷的获取动态加载的数据 2.实现模拟登录 基本使用 pip install selen ...
- (转)python爬虫----(scrapy框架提高(1),自定义Request爬取)
摘要 之前一直使用默认的parse入口,以及SgmlLinkExtractor自动抓取url.但是一般使用的时候都是需要自己写具体的url抓取函数的. python 爬虫 scrapy scrapy提 ...
- python3爬虫初探(五)之从爬取到保存
想一想,还是写个完整的代码,总结一下前面学的吧. import requests import re # 获取网页源码 url = 'http://www.ivsky.com/tupian/xiaoh ...
- 第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码 打码接口文件 # -*- coding: cp936 -*- import sys import os ...
- Scrapy框架-----爬虫
说明:文章是本人读了崔庆才的Python3---网络爬虫开发实战,做的简单整理,希望能帮助正在学习的小伙伴~~ 1. 准备工作: 安装Scrapy框架.MongoDB和PyMongo库,如果没有安装, ...
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
随机推荐
- Linux平台 Oracle 10gR2(10.2.0.5)RAC安装 Part1:准备工作
Linux平台 Oracle 10gR2(10.2.0.5)RAC安装 Part1:准备工作 环境:OEL 5.7 + Oracle 10.2.0.5 RAC 1.实施前准备工作 1.1 服务器安装操 ...
- 谈谈一些有趣的CSS题目(八)-- 纯CSS的导航栏Tab切换方案
开本系列,谈谈一些有趣的 CSS 题目,题目类型天马行空,想到什么说什么,不仅为了拓宽一下解决问题的思路,更涉及一些容易忽视的 CSS 细节. 解题不考虑兼容性,题目天马行空,想到什么说什么,如果解题 ...
- ASP.NET Core project.json imports 是什么意思?
示例代码: "frameworks": { "netcoreapp1.0.0": { "imports" : "portable- ...
- SDWebImage源码解读之SDWebImageCache(上)
第五篇 前言 本篇主要讲解图片缓存类的知识,虽然只涉及了图片方面的缓存的设计,但思想同样适用于别的方面的设计.在架构上来说,缓存算是存储设计的一部分.我们把各种不同的存储内容按照功能进行切割后,图片缓 ...
- 最好的.NET开源免费ZIP库DotNetZip(.NET组件介绍之三)
在项目开发中,除了对数据的展示更多的就是对文件的相关操作,例如文件的创建和删除,以及文件的压缩和解压.文件压缩的好处有很多,主要就是在文件传输的方面,文件压缩的好处就不需要赘述,因为无论是开发者,还是 ...
- Entity Framework 延伸系列目录
1.采用MiniProfiler监控EF与.NET MVC项目 2.采用EntityFramework.Extended 对EF进行扩展 3.EntityFramework执行存储过程中遇到的那些坑 ...
- 由js apply与call方法想到的js数据类型(原始类型和引用类型)
原文地址:由js apply与call方法想到的js数据类型(原始类型和引用类型) js的call方法与apply方法的区别在于第二个参数的不同,他们都有2个参数,第一个为对象(即需要用对象a继承b, ...
- AngularJS 系列 学习笔记 目录篇
目录: AngularJS 系列 01 - HelloWorld和数据绑定 AngularJS 系列 02 - 模块 (持续更新)
- PowerShell 数组以及XML操作
PowerShell基础 PowerShell数组操作 将字符串拆分成数据的操作 cls #原始字符串 $str = "abc,def,ghi,mon" #数据定义 #$StrAr ...
- DoraCMS 源码知识点备注
项目需要研究了下DoraCMS这款开源CMS,真心做的不错:).用的框架是常用的express 4 + mongoose,代码也很规范,值得学习. 源码中一些涉及到的小知识点备注下: https:// ...