
HashMap 的 put 方法源码分析(JDK 1.8)
一、HashMap 的 put 方法源码分析(JDK 1.8)
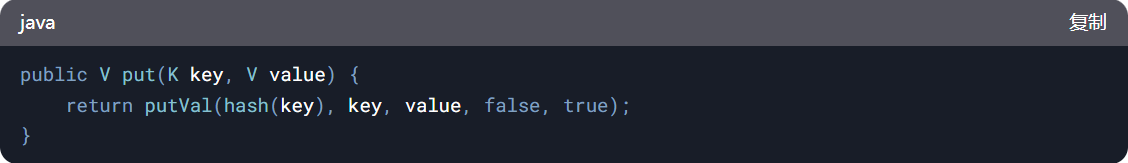
以下是 HashMap 的 put 方法的源码(JDK 1.8):
hash(key) 方法
hash(key) 方法用于计算键的哈希值:
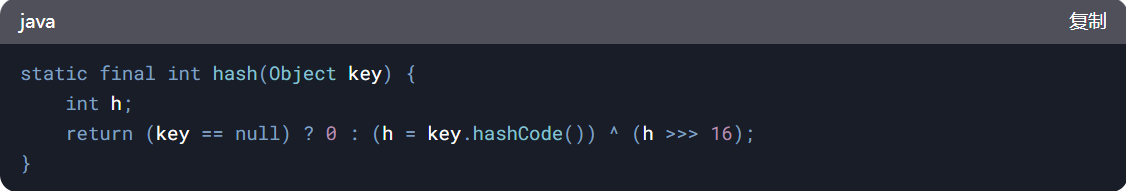
如果键为 null,返回 0。
否则,返回键的哈希码与高 16 位的异或结果(目的是减少哈希冲突)。
putVal 方法
putVal 方法是 HashMap 的核心方法,用于将键值对插入哈希表中。以下是 putVal 方法的源码:
    final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {

        Node<K,V>[] tab; // 哈希表数组

        Node<K,V> p;     // 当前节点

        int n, i;        // n: 哈希表长度; i: 索引位置

        // 如果哈希表为空或长度为 0,进行扩容

        if ((tab = table) == null || (n = tab.length) == 0)

            n = (tab = resize()).length;

        // 计算索引位置,如果该位置为空,直接插入新节点

        if ((p = tab[i = (n - 1) & hash]) == null)

            tab[i] = newNode(hash, key, value, null);

        else {

            Node<K,V> e; // 目标节点

            K k;         // 当前节点的键

            // 检查第一个节点是否匹配

            if (p.hash == hash &&

                ((k = p.key) == key || (key != null && key.equals(k))))

                e = p;

            // 如果节点是树节点,调用红黑树的插入方法

            else if (p instanceof TreeNode)

                e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);

            else {

                // 遍历链表

                for (int binCount = 0; ; ++binCount) {

                    if ((e = p.next) == null) {

                        // 插入新节点

                        p.next = newNode(hash, key, value, null);

                        // 如果链表长度超过阈值,转换为红黑树

                        if (binCount >= TREEIFY_THRESHOLD - 1)

                            treeifyBin(tab, hash);

                        break;

                    }

                    // 检查节点是否匹配

                    if (e.hash == hash &&

                        ((k = e.key) == key || (key != null && key.equals(k))))

                        break;

                    p = e;

                }

            }

            // 如果找到匹配的节点,更新值并返回旧值

            if (e != null) {

                V oldValue = e.value;

                if (!onlyIfAbsent || oldValue == null)

                    e.value = value;

                afterNodeAccess(e);

                return oldValue;

            }

        }

        // 修改计数器加 1

        ++modCount;

        // 如果元素数量超过阈值,进行扩容

        if (++size > threshold)

            resize();

        afterNodeInsertion(evict);

        return null;

    }
二、putVal 源码解析
1、初始化哈希表:
- 如果哈希表为空或长度为 0,调用 resize() 方法进行扩容
2、计算索引位置:
使用 (n - 1) & hash 计算键的存储位置
如果该位置为空,直接插入新节点
3、处理哈希冲突:
如果该位置不为空,检查第一个节点是否匹配
如果节点是树节点,调用红黑树的插入方法
否则,遍历链表,插入新节点或更新值
4、更新值:
- 如果找到匹配的节点,更新值并返回旧值
5、扩容:
- 如果元素数量超过阈值,调用 resize() 方法进行扩容
三、JDK 1.8 中 HashMap 的 resize() 方法源码分析
resize() 是 HashMap 中的一个核心方法,用于在哈希表容量不足时进行扩容。扩容的目的是为了减少哈希冲突,提高 HashMap 的性能。在 JDK 1.8 中,resize() 方法不仅负责扩容,还负责在扩容时重新分配键值对的位置
1、resize() 方法的源码
以下是 HashMap 的 resize() 方法的源码(JDK 1.8):
    final Node<K,V>[] resize() {

        Node<K,V>[] oldTab = table; // 旧的哈希表

        int oldCap = (oldTab == null) ? 0 : oldTab.length; // 旧容量

        int oldThr = threshold; // 旧阈值

        int newCap, newThr = 0; // 新容量和新阈值

        // 计算新容量和新阈值

        if (oldCap > 0) {

            if (oldCap >= MAXIMUM_CAPACITY) { // 如果旧容量已达到最大值

                threshold = Integer.MAX_VALUE; // 阈值设置为最大值

                return oldTab; // 直接返回旧表,不再扩容

            }

            else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && // 新容量为旧容量的 2 倍

                     oldCap >= DEFAULT_INITIAL_CAPACITY) // 如果旧容量大于默认初始容量

                newThr = oldThr << 1; // 新阈值为旧阈值的 2 倍

        }

        else if (oldThr > 0) // 如果旧阈值大于 0(初始化时指定了容量)

            newCap = oldThr; // 新容量为旧阈值

        else { // 如果旧容量和旧阈值都为 0(默认初始化)

            newCap = DEFAULT_INITIAL_CAPACITY; // 新容量为默认初始容量(16)

            newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); // 新阈值为默认负载因子 × 默认初始容量

        }

        // 如果新阈值为 0,重新计算

        if (newThr == 0) {

            float ft = (float)newCap * loadFactor; // 新容量 × 负载因子

            newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?

                      (int)ft : Integer.MAX_VALUE); // 如果未超过最大容量,设置为 ft,否则设置为最大值

        }

        threshold = newThr; // 更新阈值

        @SuppressWarnings({"rawtypes","unchecked"})

        Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; // 创建新表

        table = newTab; // 更新哈希表

        // 如果旧表不为空,重新分配键值对

        if (oldTab != null) {

            for (int j = 0; j < oldCap; ++j) { // 遍历旧表

                Node<K,V> e;

                if ((e = oldTab[j]) != null) { // 如果当前桶不为空

                    oldTab[j] = null; // 清空旧桶

                    if (e.next == null) // 如果当前桶只有一个节点

                        newTab[e.hash & (newCap - 1)] = e; // 直接放入新表

                    else if (e instanceof TreeNode) // 如果当前桶是红黑树

                        ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); // 拆分红黑树

                    else { // 如果当前桶是链表

                        Node<K,V> loHead = null, loTail = null; // 低位链表头尾节点

                        Node<K,V> hiHead = null, hiTail = null; // 高位链表头尾节点

                        do {

                            if ((e.hash & oldCap) == 0) { // 如果哈希值的对应位为 0

                                if (loTail == null) // 如果低位链表为空

                                    loHead = e; // 设置头节点

                                else

                                    loTail.next = e; // 添加到尾部

                                loTail = e; // 更新尾节点

                            }

                            else { // 如果哈希值的对应位为 1

                                if (hiTail == null) // 如果高位链表为空

                                    hiHead = e; // 设置头节点

                                else

                                    hiTail.next = e; // 添加到尾部

                                hiTail = e; // 更新尾节点

                            }

                        } while ((e = e.next) != null); // 遍历链表

                        // 将低位链表放入新表的原位置

                        if (loTail != null)

                            loTail.next = null;

                        newTab[j] = loHead;

                        // 将高位链表放入新表的新位置(原位置 + 旧容量)

                        if (hiTail != null)

                            hiTail.next = null;

                        newTab[j + oldCap] = hiHead;

                    }

                }

            }

        }

        return newTab; // 返回新表

    }
四、resize() 方法源码解析
1、计算新容量和新阈值
如果旧容量大于 0:
如果旧容量已达到最大值(MAXIMUM_CAPACITY),直接返回旧表,不再扩容
否则,新容量为旧容量的 2 倍,新阈值为旧阈值的 2 倍
如果旧容量为 0 但旧阈值大于 0(初始化时指定了容量),新容量为旧阈值
如果旧容量和旧阈值都为 0(默认初始化),新容量为默认初始容量(16),新阈值为默认负载因子 × 默认初始容量
2、创建新表
根据新容量创建新表(newTab)
更新哈希表引用(table = newTab)
3、重新分配键值对
遍历旧表的每个桶:
如果当前桶只有一个节点,直接放入新表
如果当前桶是红黑树,调用 split() 方法拆分红黑树
如果当前桶是链表,将链表拆分为低位链表和高位链表:
低位链表:哈希值的对应位为 0,放入新表的原位置
高位链表:哈希值的对应位为 1,放入新表的新位置(原位置 + 旧容量)
4、返回新表
- 返回扩容后的新表
五、resize() 方法的关键点
1、扩容时机:
- 当 HashMap 中的元素数量超过阈值(容量 × 负载因子)时,触发扩容
2、扩容机制:
新容量为旧容量的 2 倍
新阈值为旧阈值的 2 倍
3、键值对重新分配:
通过 (e.hash & oldCap) 判断键值对应该放入低位链表还是高位链表。
低位链表放入新表的原位置,高位链表放入新表的新位置(原位置 + 旧容量)
值得注意的是:为了防止java1.7之前元素迁移头插法在多线程是会造成死循环,java1.8+后使用尾插法
4、红黑树拆分:
- 如果桶是红黑树,调用 split() 方法将红黑树拆分为两个链表或红黑树
六、resize() 方法的示例
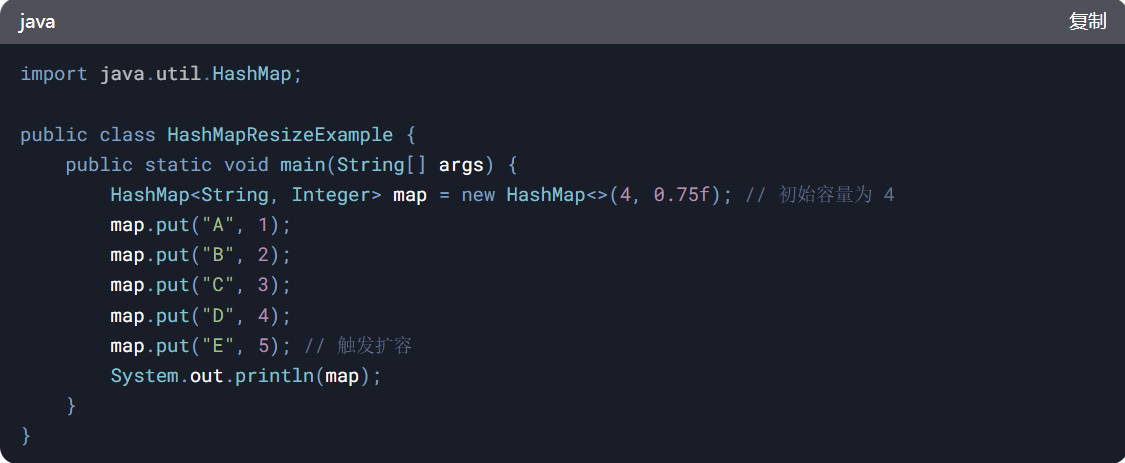
以下是一个 HashMap 扩容的示例:
七、总结
resize() 是 HashMap 的核心方法之一,负责在容量不足时进行扩容。它的主要逻辑包括:
1、计算新容量和新阈值。
2、创建新表。
3、重新分配键值对。
4、返回扩容后的新表。
通过扩容,HashMap 可以减少哈希冲突,提高性能。理解 resize() 方法的实现原理,有助于更好地使用和优化 HashMap
HashMap 的 put 方法源码分析(JDK 1.8)的更多相关文章
- hashmap的put方法源码分析
put主源码如下: public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = ha ...
- HashMap实现原理及源码分析之JDK8
继续上回HashMap的学习 HashMap实现原理及源码分析之JDK7 转载 Java8源码-HashMap 基于JDK8的HashMap源码解析 [jdk1.8]HashMap源码分析 一.H ...
- java-通过 HashMap、HashSet 的源码分析其 Hash 存储机制
通过 HashMap.HashSet 的源码分析其 Hash 存储机制 集合和引用 就像引用类型的数组一样,当我们把 Java 对象放入数组之时,并非真正的把 Java 对象放入数组中.仅仅是把对象的 ...
- 【转】HashMap实现原理及源码分析
哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景极其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表,而HashMap的实现原理也常常出 ...
- 每天学会一点点(HashMap实现原理及源码分析)
HashMap实现原理及源码分析 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希 ...
- Java split方法源码分析
Java split方法源码分析 public String[] split(CharSequence input [, int limit]) { int index = 0; // 指针 bool ...
- invalidate和requestLayout方法源码分析
invalidate方法源码分析 在之前分析View的绘制流程中,最后都有调用一个叫invalidate的方法,这个方法是啥玩意?我们来看一下View类中invalidate系列方法的源码(ViewG ...
- Linq分组操作之GroupBy,GroupJoin扩展方法源码分析
Linq分组操作之GroupBy,GroupJoin扩展方法源码分析 一. GroupBy 解释: 根据指定的键选择器函数对序列中的元素进行分组,并且从每个组及其键中创建结果值. 查询表达式: var ...
- HashMap的小总结 + 源码分析
一.HashMap的原理 所谓Map,就是关联数组,存的是键值对——key&value. 实现一个简单的Map,你也许会直接用两个LIst,一个存key,一个存value.然后做查询或者get ...
- 2、JDK8中的HashMap实现原理及源码分析
本篇提纲.png 本篇所述源码基于JDK1.8.0_121 在写上一篇线性表的文章的时候,笔者看的是Android源码中support24中的Java代码,当时发现这个ArrayList和Linked ...
随机推荐
- Kotlin:闭包、lambda与匿名内部类
- 四.3 Redis 五大数据类型/结构的详细说明/详细使用( hash 哈希表数据类型详解和使用)
四.3 Redis 五大数据类型/结构的详细说明/详细使用( hash 哈希表数据类型详解和使用) @ 目录 四.3 Redis 五大数据类型/结构的详细说明/详细使用( hash 哈希表数据类型详解 ...
- Q:oracle通过正则表达式替换对应值
示例 把http://192.168.1.1:8888/a.html中的192.168.1.1:8888/替换成172.32.32.1:9999/ SELECT replace('http://192 ...
- Luogu P11361 NOIP2024 编辑字符串 题解 [ 黄 ] [ 贪心 ]
编辑字符串:这题能评蓝已经说明了洛谷的唐氏. 结论 找到两个字符串种连续的且可以移动的所有极大子区间,然后线性扫一遍,看这一位所处的子区间中有多少个 \(0\) 和 \(1\),两个都有 \(0\) ...
- .NET中 泛型 + 依赖注入 的实现与应用
在.NET中,注入泛型依赖项是一个常见的场景. 在依赖注入(DI)中使用泛型可以使得应用程序更加模块化.易于测试和扩展. 在ASP.NET Core中注册泛型服务 假设我们有一个需要注入的泛型接口 I ...
- 《Indie Tools • 半月刊》第001期
引言:独立开发者工具分享 <INDIE TOOLS>专注于分享独立开发出海精选.最新.最实用的工具. 欢迎订阅半月刊:<INDIE TOOLS • 半月刊> 如果本文能给你提供 ...
- 发那科焊接机器人M-10iA维修总结
发那科作为工业机器人制造商,其焊接机器人产品广泛应用于各种工业领域.然而,随着时间的推移,焊接机器人可能会出现故障,因此了解发那科焊接机器人M-10iA维修知识显得尤为重要. 一.日常法那科机械手维护 ...
- Memcached深度剖析:解锁高性能分布式内存缓存的秘密
引言 在当今快节奏的互联网世界中,应用程序的响应速度往往是用户体验的关键.为了提升性能,减轻数据库的压力,Memcached作为一种高性能的分布式内存对象缓存系统,被广泛应用于加速动态Web应用程序. ...
- vue+elementUI 表格操作按钮添加loading
前言 表格操作栏,某个操作需要异步请求才能做跳转等 方案 整个列表每行都加一个loading字段,不够优雅 利用$set方法 改变当前行当前按钮loading,可行(代码如下) //按钮 row.lo ...
- httprunner 断言报错 expect_value 和check_value类型不一致
csv 源码 drillCode,drillName,code,msg y500,牙轮500,200,操作成功 YL201,牙轮201,500,牙轮编号已存在 运行后报错 E httprunner.e ...