
1.1大数据平台架构及Hadoop生态圈
1.硬件架构实例

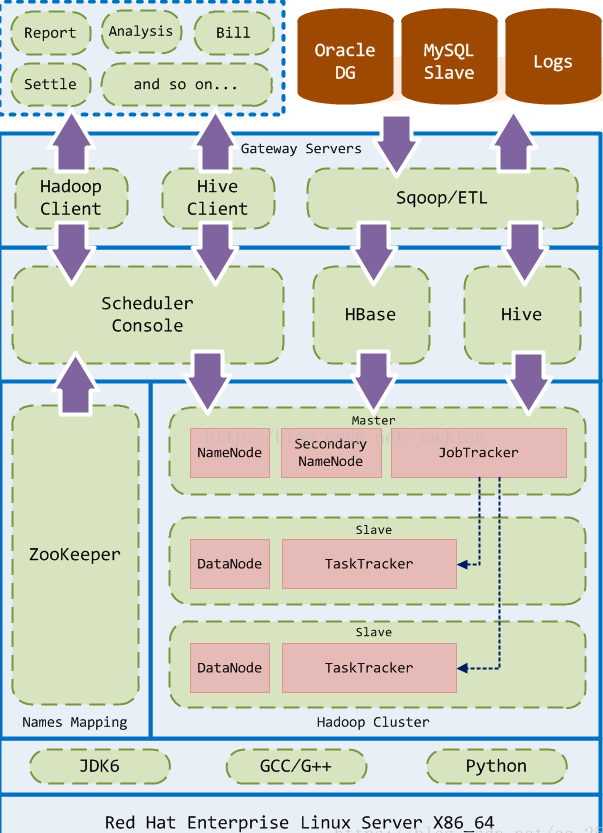
2.软件架构实例
3.数据流通用概念模型
a.数据源(互联网、物联网、企业数据):App、Device、Site
b.数据收集(ETL、提取、转换、加载):Flume、Kafka、Sqoop
c.数据存储:HDFS、Hive/HBase
d.资源管理:Yarn、Mesos
e.批处理:MapReduce、Spark core
流处理:Storm、Spark streaming
f.数据挖掘(OLAP、BI):Mahout、MLlib
g.数据可视化(report)
4.Hadoop生态圈


1.1大数据平台架构及Hadoop生态圈的更多相关文章
- 知名大厂如何搭建大数据平台&架构
今天我们来看一下淘宝.美团和滴滴的大数据平台,一方面进一步学习大厂大数据平台的架构,另一方面也学习大厂的工程师如何画架构图.通过大厂的这些架构图,你就会发现,不但这些知名大厂的大数据平台设计方案大同小 ...
- 大数据平台搭建(hadoop+spark)
大数据平台搭建(hadoop+spark) 一.基本信息 1. 服务器基本信息 主机名 ip地址 安装服务 spark-master 172.16.200.81 jdk.hadoop.spark.sc ...
- 分布式处理与大数据平台(RabbitMQ&Celery&Hadoop&Spark&Storm&Elasticsearch)
热门的消息队列中间件RabbitMQ,分布式任务处理平台Celery,大数据分布式处理的三大重量级武器:Hadoop.Spark.Storm,以及新一代的数据采集和分析引擎Elasticsearch. ...
- 大数据平台搭建:Hadoop
To construct big data distributed platform based on Hadoop is a common method. Hadoop comes fron Goo ...
- 《阿里如何实现秒级百万TPS?搜索离线大数据平台大数据平台架构解读》读后感
在使用淘宝时发现搜索框很神奇,它可以将将我们想要的商品全部查询出来,但是我们并感觉不到数据库查询的过程,速度很快.通过阅读这篇文章让我知道了搜索框背后包含着很多技术,对我以后的学习可能很有借鉴. 平时 ...
- 《阿里如何实现秒级百万TPS?搜索离线大数据平台架构解读》--阅读
离线?在阿里搜索工程体系中我们把搜索引擎.在线算分.SearchPlanner等ms级响应用户请求的服务称之为“在线”服务:与之相对应的,将各种来源数据转换处理后送入搜索引擎等“在线”服务的系统统称为 ...
- 大数据平台架构(flume+kafka+hbase+ELK+storm+redis+mysql)
上次实现了flume+kafka+hbase+ELK:http://www.cnblogs.com/super-d2/p/5486739.html 这次我们可以加上storm: storm-0.9.5 ...
- 基于Hadoop的大数据平台实施记——整体架构设计[转]
http://blog.csdn.net/jacktan/article/details/9200979 大数据的热度在持续的升温,继云计算之后大数据成为又一大众所追捧的新星.我们暂不去讨论大数据到底 ...
- 基于Hadoop的大数据平台实施记——整体架构设计
大数据的热度在持续的升温,继云计算之后大数据成为又一大众所追捧的新星.我们暂不去讨论大数据到底是否适用于您的组织,至少在互联网上已经被吹嘘成无所不能的超级战舰.好像一夜之间我们就从互联网时代跳跃进了大 ...
随机推荐
- Windows 修改域用户账户密码
打开powershell as administrator Set-ADAccountPassword -Identity 域用户名 弹出提示框,输入旧密码 弹出提示框,输入新密码,两遍 登出 win ...
- yum clear all无反应
卸载重装yum 操作系统版本:centos7 [root@linux-node3 ~]# uname -r 3.10.0-514.el7.x86_64 一.将现有的yum源卸载 [root@linux ...
- php curl 跨域情趣
function curl_post($url='',$postdata='',$options=array()){ $ch=curl_init($url); curl_setopt($ch,CURL ...
- python 网络爬虫概念与HTTP(s)协议
1. 爬虫相关概念 1.1 定义 爬虫就是通过编写程序模拟浏览器上网,然后让其去互联网上抓取数据的过程 1.2 主流语言实现爬虫优劣 php:可以实现爬虫.但是php在实现爬虫中支持多线程和多进程方面 ...
- SPARK-18560
##### Receiver data can not be dataSerialized properly. ``` // :: ERROR executor.Executor: Exception ...
- 白盒测试实践-day02
一.任务进展情况 小组分工完成后,了解findbugs的使用过程,以及junit的测试步骤. 二.存在的问题 由于对单元测试不是太了解,导致无法进行测试. 三.解决方法 看mooc上面的视频,了解测试 ...
- vim编辑器显示行号
Vim编辑器显示行号的设置 1. 显示行号 :set nu 2. 不显示行号 :set nonu :set nu :set nonu
- FTP服务器匿名登录
ftp需要开通对匿名用户.本地用户.及虚拟用户的支持.并且特别对虚拟用户中的(stu.teacher.admin)分别授予不同的权限. 1.创建多层目录,然后挂载 2.配置yum源文件 3.安 ...
- C++接口与实现的抽象分离
IPerson.h #ifndef I_PERSON_H_ #define I_PERSON_H_ #include <string> #include <ostream> c ...
- oracle 内存不足处理
alter日志 TNS-12535: TNS:operation timed out ns secondary err code: 12606 nt main err code: 0 nt secon ...