
Selenium_POM架构(17)
POM是Page Object Model的简称,它是一种设计思想,意思是,把每一个页面,当做一个对象,页面的元素和元素之间操作方法就是页面对象的属性和行为。
POM一般使用三层架构,分别为:基础封装层、页面对象层、测试用例层。
目录结构大致如下
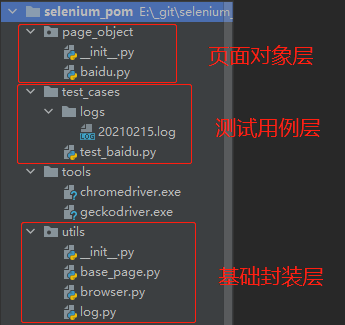
下面简单介绍下我的POM架构实现方式。
基础封装层
基础封装层主要是封装一些常用的方法,提高代码的复用。
基础封装层当前只包含了3个文件:
- base_page.py:将所有界面共用的方法进行封装
- browser.py:继承了selenium常用的webdriver操作,并对部分操作进行了封装
- log,py:封装日志功能
base_page.py文件代码如下:
class BasePage(object):

    def __init__(self, driver):

        self.__driver = driver

    def find_element(self, by, value, times=10, wait_time=1) -> object:

        return self.__driver.until_find_element(by, value, times=10, wait_time=1)
因为在页面对象层,我们会将每个界面定义成一个类对象,而每个类对象都需要传入一个webdriver的实例对象,为了减少这样的重复操作,我们在base_page.py定义一个页面基类BasePage,在页面对象层定义的类继承该基类就可以完成webdriver实例对象的传入。
browser.py文件代码如下:
import time

import logging

from selenium.webdriver import Chrome, Firefox

from selenium.common.exceptions import NoSuchElementException

class Browser(Chrome, Firefox):

    def __init__(self, browser_type="chrome", driver_path=None, *args, **kwargs):

        """

        根据浏览器类型初始化浏览器

        :param browser_type: 浏览器类型,只可传入chrome或firefox

        :param driver_path:指定驱动存放的路径

        """

        # 检查browser_type值是否合法

        if browser_type not in ["chrome", "firefox"]:

            # 不合法报错

            logging.error("browser_type 输入值不为chrome,firefox")

            raise ValueError("browser_type 输入值不为chrome,firefox")

        self.__browser_type = browser_type

        # 根据browser_type值选择对应的驱动

        if self.__browser_type == "chrome":

            if driver_path:

                Chrome.__init__(self, executable_path=f"{driver_path}/chromedriver.exe", *args, **kwargs)

            else:

                Chrome.__init__(self, *args, **kwargs)

        elif self.__browser_type == "firefox":

            if driver_path:

                Firefox.__init__(self, executable_path=f"{driver_path}/geckodriver.exe", *args, **kwargs)

            else:

                Firefox.__init__(self, *args, **kwargs)

    def open_browser(self, url):

        self.get(url)

        self.maximize_window()

    @property

    def browser_name(self):

        return self.capabilities["browserName"]

    @property

    def browser_version(self):

        return self.capabilities["browserVersion"]

    def until_find_element(self, by, value, times=10, wait_time=1):

        """

        用于定位元素

        :param by: 定位元素的方式

        :param value: 定位元素的值

        :param times: 定位元素的重试次数

        :param wait_time: 定位元素失败的等待时间

        :return: 返回定位的元素

        """

        # 检查by的合法性

        if by not in ["id", "xpath", "name", "class", "tag", "text", "partial_text", "css"]:

            # 不合法报错

            logging.error(f"无效定位方式:{by},请输入:id,xpath, name, class, tag, text, partial_text, css")

            raise ValueError(f"无效定位方式:{by},请输入:id,xpath, name, class, tag, text, partial_text, css")

        # 定位元素,如果定位失败,增加重试机制

        for i in range(times):

            # 定位元素

            el = None

            try:

                if by == "id":

                    el = super().find_element_by_id(value)

                elif by == "xpath":

                    el = super().find_element_by_xpath(value)

                elif by == "name":

                    el = super().find_element_by_name(value)

                elif by == "class":

                    el = super().find_element_by_class_name(value)

                elif by == "tag":

                    el = super().find_elements_by_tag_name(value)

                elif by == "text":

                    el = super().find_element_by_link_text(value)

                elif by == "partial_text":

                    el = super().find_element_by_partial_link_text(value)

                elif by == "css":

                    el = super().find_element_by_css_selector(value)

            except NoSuchElementException:

                # 如果报错为未找到元素,则重试

                logging.error(f"通过{by}未定位到元素【{value}】,正在进行第{i+1}次重试...")

                time.sleep(wait_time)

            else:

                # 如果成功定位元素则返回元素

                logging.info(""f"通过{by}成功定位元素【{value}】!")

                return el

        # 如果循环完仍为定位到元素,则抛错

        logging.error(f"通过{by}无法定位元素【{value}】,请检查...")

        raise NoSuchElementException(f"通过{by}无法定位元素【{value}】,请检查...")

    def switch_to_new_page(self):

        # 获取老窗口的handle

        old_handle = self.current_window_handle

        handles = self.window_handles

        for handle in handles:

            if handle != old_handle:

                self.switch_to.window(handle)

                break
在browser.py文件中,我们主要定义一个 Browser类,该类继承了selenium的Chrome 和 Firefox,在实例化Browser类后,我们能使用selenium所有的方法,同时,我们在Browser类中还封装一些其它操作,比如将查找元素的8种方法进行封装并增加元素定位失败后重试次数,比如切换新界面的handle等
log.py文件代码如下:
import os

import logging

import time

from logging.handlers import RotatingFileHandler

def log(log_level="DEBUG"):

    # 创建logger,如果参数为空则返回root logger

    logger = logging.getLogger()

    # 设置logger日志等级

    # logger.setLevel(logging.DEBUG)

    logger.setLevel(log_level)

    # 创建handler

    log_size = 1024 * 1024 * 20

    # 将日志写入到文件中

    dir_name = "./logs/"

    if not os.path.exists(dir_name):

        os.mkdir(dir_name)

    time_str = time.strftime("%Y%m%d", time.localtime())

    fh = RotatingFileHandler(dir_name + f"{time_str}.log", encoding="utf-8", maxBytes=log_size, backupCount=100)

    # 将日志输出到控制台

    ch = logging.StreamHandler()

    # 设置输出日志格式

    formatter = logging.Formatter(

        fmt="%(asctime)s [%(levelname)s] %(filename)s line:%(lineno)s  %(message)s",

        # datefmt="%Y/%m/%d %X"

    )

    # 注意 logging.Formatter的大小写

    # 为handler指定输出格式,注意大小写

    fh.setFormatter(formatter)

    ch.setFormatter(formatter)

    # 为logger添加的日志处理器

    logger.addHandler(fh)

    logger.addHandler(ch)
log.py文件主要定义了一个log函数,函数中定义了日志相关的操作,注意,定义的log函数需要在任意被执行文件中被调用,比如,在用例层我们调用了browser.py文件中的方法,那么在架构中必定执行utils文件中__init.py文件,所以我们在__init__.py文件中调用log函数。
__init__.py文件代码如下:
from .log import log

log("INFO")
到此,我们完成了日志的环境配置,当需要记录日志时,只需要在文件中导入logging包,使用logging.info()这种方式记录日志即可。点我查看更多日志操作
页面对象层
什么是页面对象?页面对象就是将每个界面当成一个对象,界面中的元素当成对象的属性。下面以百度首页和新闻页为例,介绍页面对象层。
在页面对象层,新增文件baidu.py,文件代码如下:
from utils.base_page import BasePage

class HomePage(BasePage):

    @property

    def input_box(self):

        return self.find_element("id", "kw")

    @property

    def search_button(self):

        return self.find_element("id", "su")

    @property

    def news_link(self):

        return self.find_element("xpath", '//*[@id="s-top-left"]/a[1]')

class NewsPage(BasePage):

    @property

    def game_link(self):

        return self.find_element("xpath", '//*[@id="channel-all"]/div/ul/li[10]/a')
类对象HomePage和NewsPage分别代表百度首页和百度新闻页,在类对象中定义了一些方法,每个方法表示页面中的一个元素,再使用装饰器@property将这些方法属性化。比如,input_box表示输入框,search_button表示搜索框。
测试用例层
在测试用例层,我们使用了uniittest框架来管理和执行用例,下面以两个简单的用例,来演示脚本的编写。
test_baidu.py文件代码如下:
import unittest

import time

import logging

from utils.browser import Browser

from page_object.baidu import HomePage, NewsPage

class Baidu(unittest.TestCase):

    def setUp(self) -> None:

        self.driver = Browser("firefox")

        self.driver.open_browser("http://www.baidu.com")

        logging.info("打开浏览器")

        logging.info(f"浏览器名称:{self.driver.browser_name},浏览器版本:{self.driver.browser_version}")

        self.homepage = HomePage(self.driver)

        self.newspage = NewsPage(self.driver)

    def tearDown(self) -> None:

        self.driver.quit()

        logging.info("关闭浏览器")

    def test_search(self):

        """ 用例1:测试百度搜索框输入selenium能搜索出包含selenium相关的信息 """

        logging.info("用例1:测试百度搜索框输入selenium能搜索出包含selenium相关的信息")

        # 输入搜索信息

        self.homepage.input_box.send_keys("selenium")

        logging.info("输入搜索信息")

        # 点击按钮

        self.homepage.search_button.click()

        logging.info("点击搜索按钮")

        time.sleep(2)

        # 校验搜索结果

        els = self.driver.find_element_by_partial_link_text("selenium")

        self.assertIsNotNone(els)

    def test_access_game_news(self):

        """ 用例2:测试通过百度首页能进入新闻界面的游戏专题 """

        logging.info("用例2:测试通过百度首页能进入新闻界面的游戏专题")

        # 点击新闻链接

        self.homepage.news_link.click()

        logging.info("点击新闻链接")

        # 切换窗口

        self.driver.switch_to_new_page()

        logging.info("切换窗口")

        # 点击游戏链接

        self.newspage.game_link.click()

        logging.info("点击游戏链接")

        # 校验url

        current_url = self.driver.current_url

        self.assertEqual(current_url, "http://news.baidu.com/game")

if __name__ == '__main__':

    unittest.main()
执行用例
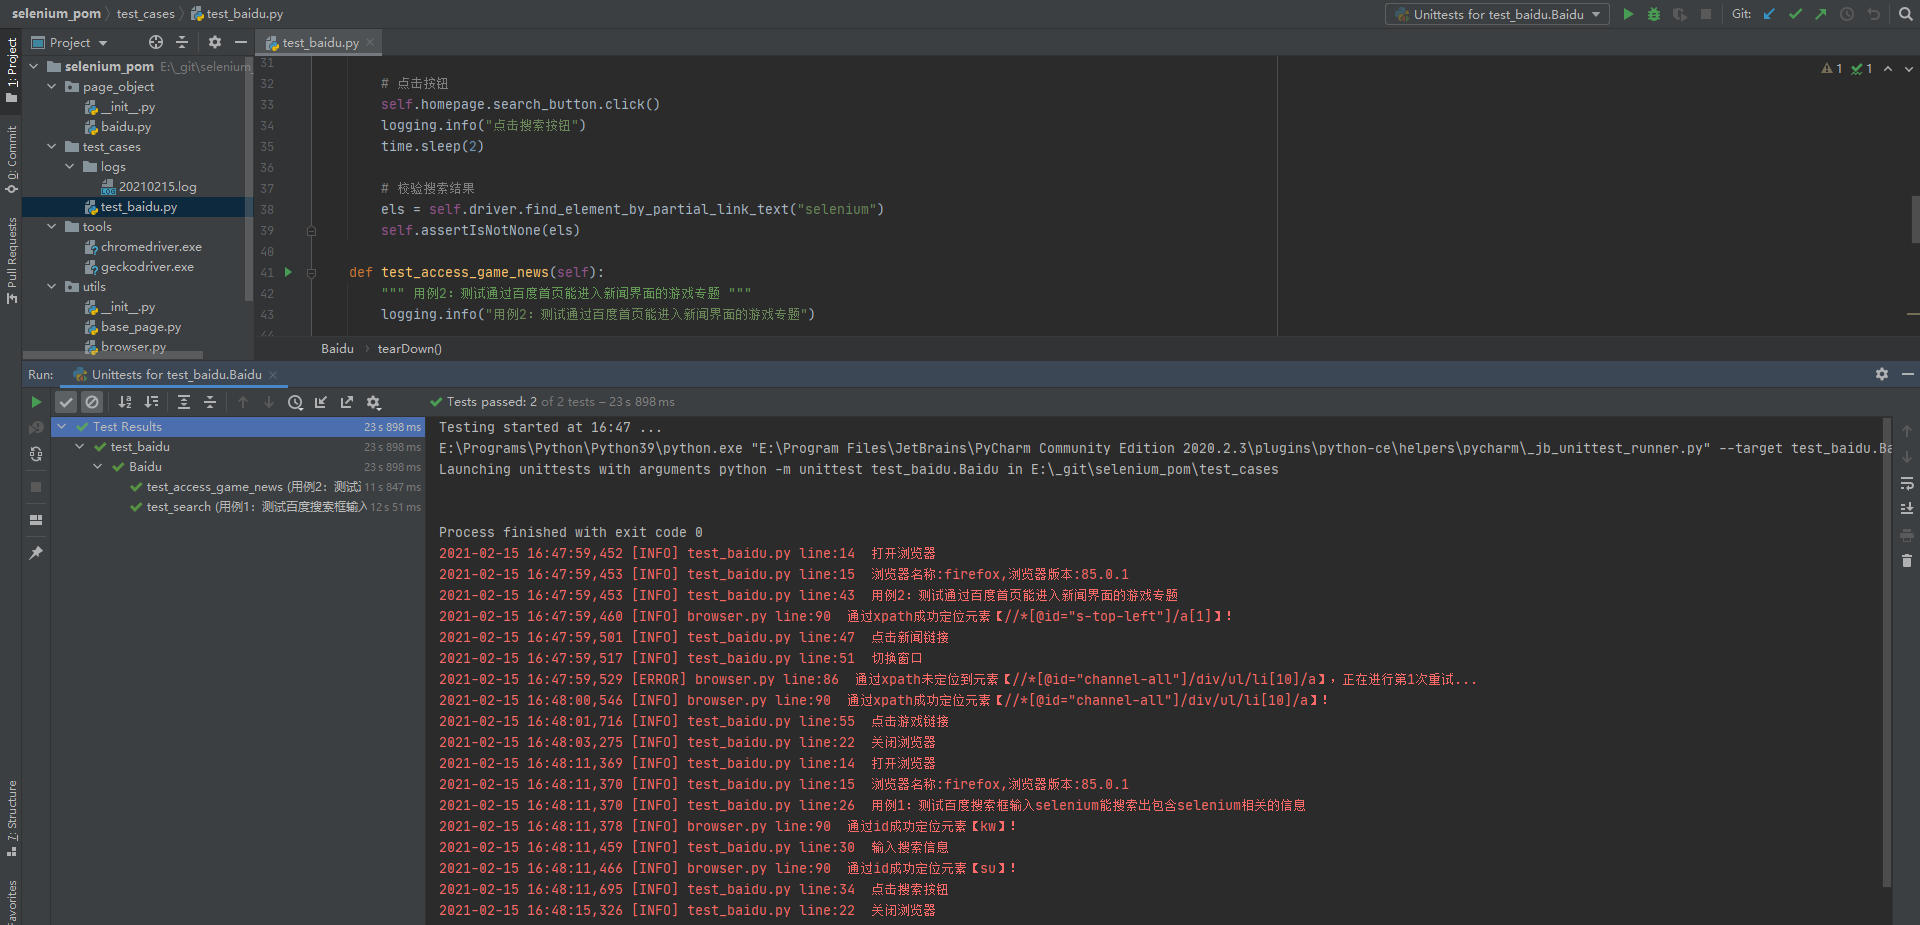
到此,POM架构基本实现。
Selenium_POM架构(17)的更多相关文章
- 这是一套Java菜鸟到大牛的学习路线之高级教程,由工作了10年的资深Java架构师整理。
这是一套Java菜鸟到大牛的学习路线之高级教程,由工作了10年的资深Java架构师整理. 01-java高级架构师设计-基础深入 J2SE深入讲解 Java多 ...
- 《iOS开发指南》正式出版-源码-样章-目录,欢迎大家提出宝贵意见
智捷iOS课堂-关东升老师最新作品:<iOS开发指南-从0基础到AppStore上线>正式出版了 iOS架构设计.iOS性能优化.iOS测试驱动.iOS调试.iOS团队协作版本控制.... ...
- Web后台快速开发框架
Web后台快速开发框架 Coldairarrow 目录 目录 第1章 目录 1 第2章 简介 3 第3章 基础准备 4 3.1 开发环境要求 4 3.2 ...
- docker“少折腾”
1.docker镜像加速 新版的 Docker 使用 /etc/docker/daemon.json(Linux) 或者 %programdata%\docker\config\daemon.json ...
- 《关于长沙.NET技术社区未来发展规划》问卷调查结果公布
那些开发者们对于社区的美好期待 2月,长沙.net 技术社区自从把群拉起来开始,做了一次比较正式.题目为<关于长沙.NET技术社区未来发展规划>的问卷调查,在问卷调查中,溪源写道: 随着互 ...
- 2017年--10年java大神告诉你开发最常用的百分之二十的技术有哪些?
首先题主说的20%我不知道从哪方面去理解.接下来我会将自己多年来工作中会经常使用到的技术列出来. 1.html.css 2.java工作原理(jvm) 3.java语法.数据结构和算法 4.java语 ...
- 《JSP+Servlet+Tomcat应用开发从零開始学》
当当网页面: http://product.dangdang.com/23619990.html 内容简单介绍 本书全面介绍了 JSP开发中涉及的相关技术要点和实战技巧. 全书结构清晰,难 ...
- 新书上线:《Spring Boot+Spring Cloud+Vue+Element项目实战:手把手教你开发权限管理系统》,欢迎大家买回去垫椅子垫桌脚
新书上线 大家好,笔者的新书<Spring Boot+Spring Cloud+Vue+Element项目实战:手把手教你开发权限管理系统>已上线,此书内容充实.材质优良,乃家中必备垫桌脚 ...
- Docker技术入门与实战第2版-高清文字版
Docker技术入门与实战第2版-高清文字版 下载地址https://pan.baidu.com/s/1bAoRQQlvBa-PXy5lgIlxUg 扫码下面二维码关注公众号回复100011 获取 ...
随机推荐
- 【Service】【Web】【Middleware】Tomcat
1. 概念 1.1. 官方网站:tomcat.apache.org 1.2. tomcat的组件 <Server> <Service> <Connector/> & ...
- 【Linux】【Basis】Grub
GRUB(Boot Loader): 1. grub: GRand Unified Bootloader grub 0.x: grub legacy grub 1.x: grub2 2. gr ...
- Spring AOP通过注解的方式设置切面和切入点
切面相当于一个功能的某一个类,切入点是这个类的某部分和需要额外执行的其他代码块,这两者是多对多的关系,在代码块处指定执行的条件. Aspect1.java package com.yh.aop.sch ...
- 计算机网络 Raw_Socket编程 Ping C语言
计算机网络做了一个附加题,用C语言Raw_Socket实现ping指令. 通过本部的Mooc学习了一下Socket编程,然后成功写了出来orz 先放一下代码: #include <stdio.h ...
- Nginx 中 location 的匹配顺序
nginx中location的匹配模式有以下几种: 精确匹配:以=开头,只有完全匹配才能生效,例子location = /uri 非正则匹配:以^~开头,^表示非.~表示正则,例子location ^ ...
- [手写系列] Spirit带你实现防抖函数和节流函数
前言 防抖函数和节流函数,无论是写业务的时候还是面试的时候,想必大家已经听过很多次了吧.但是大家在用到的时候,有了解过他们之间的区别嘛,他们是如何实现的呢?还是说只是简单的调用下像lodash和und ...
- [BUUCTF]PWN——others_shellcode
others_shellcode 附件 解题步骤: 例行检查,32位程序,开启了NX(堆栈不可执行)和PIE(地址随机化)双重保护 试运行了一下,发现直接就能执行shell的命令 远程连接运行一下,直 ...
- java 输入输出 对象序列化implements Serializable与反序列化:ObjectOutputStream.writeObject() ;objectInputStream.readObject() ;serialVersionUID字段注意
对象序列化 对象序列化的目标是将对象保存到磁盘中,或允许在网络中直接传输对象.对象序列化机制允许把内存中的 Java 对象转换成平台无关的二进制流,从而允许把这种二进制流持久地保存在磁盘上,通过网络将 ...
- c++模板移除引用
背景 一个函数内部需将函数内的一个变量转为其参数的类型, 函数的参数是引用 本文要演示的环境需要c++11支持(使用了新的关键字 using) 例如 get_value 内部将dobuble类型数据转 ...
- 【LeetCode】312. Burst Balloons 解题报告(Python)
作者: 负雪明烛 id: fuxuemingzhu 个人博客: http://fuxuemingzhu.cn/ 题目地址: https://leetcode.com/problems/burst-ba ...