
Beautifulsoup网页解析——爬取豆瓣排行榜分类接口
我们在网页爬取的过程中,会通过requests成功的获取到所需要的信息,而且,在返回的网页信息中,也是通过HTML代码的形式进行展示的。HTML代码都是通过固定的标签组合来实现页面信息的展示,所以,最方便的做法就是依据标签来获取信息,所以我们提取信息也应该通过选择标签信息来获取我们需要的内容。
python的spider中提供了许多的网页解析的第三方库,而对于HTML的解析(也就是我们通常说的通过css选择器进行解析),bs4中的Beautifulsoup是很好的选择。
下面的代码实现了Beautifulsoup的基本实现方式
 1 '''

 2 @Description: Beautifulsoup网页解析(获取豆瓣电影分类排行榜)

 3 @Version: 1.0

 4 @Autor: Montoin Yan

 5 @Date: 2020-02-06 19:36:54

 6 @LastEditors  : Montoin Yan

 7 @LastEditTime : 2020-02-06 20:09:09

 8 '''

 9

10 import requests

11 import re

12 import lxml

13 import random

14 import bs4

15

16 Base_URL = 'http://movie.douban.com' #设置网页的根路径

17 CHART_URL = '{}/{}'.format(Base_URL,'chart') #拼接为网页的入口地址

18

19 def main(): #主函数

20     #设置多个请求头,防止被反扒措施进行拦截

21     ua_list = [

22         "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:72.0) Gecko/20100101 Firefox/72.0",

23         "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.29 Safari/537.36",

24         "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.102 Safari/537.36 Edge/18.18362",

25         "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3741.400 QQBrowser/10.5.3863.400"

26     ]

27     #随机pick one

28     ua = random.choice(ua_list)

29     response = requests.get(CHART_URL,headers={

30         'User-agent':ua

31     })

32     response.encoding = 'UTF-8' #设置获取网页的编码

33     # print(response.text)

34     soup = bs4.BeautifulSoup(markup=response.text,features='lxml') #使用lxml进行解析处理,使用头两个参数,markup:表示需要解析的内容  features:表示进行解析的特定解析器或者标记的类型

35     typerank_list = soup.find_all('a',href = re.compile('^/typerank')) #获取豆瓣a标签下所有的href属性为typerank的内容(通过正则)

36     for t in typerank_list:

37         type_title = t.contents[0] #获取文字的分类标题

38         print('【%s】访问路径:%s' % (type_title,Base_URL+t['href'])) #将获取到的数据进行拼接

39

40

41 if __name__ == "__main__":

42     main()
执行的结果可以试一下情形:
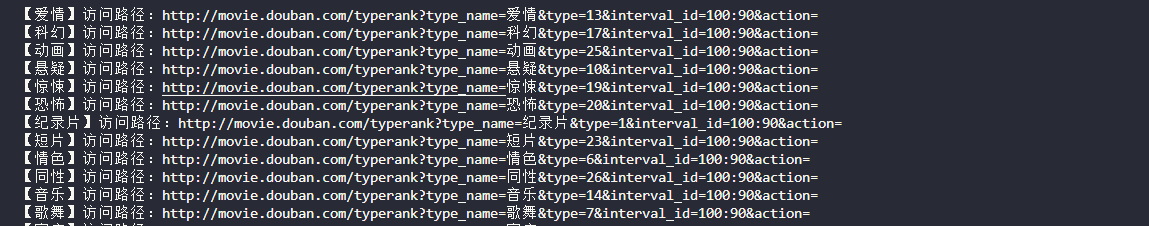
可以知道我们通过程序入口进行了对HTML代码的解析能够获取到我们想要的完整信息,然后我们通过对解析结果的分析能够获取到我们需要的接口路径,当我们获得这些接口的完整路径的时候,我们就可以通过这些路径进行下一步的操作了。
Beautifulsoup网页解析——爬取豆瓣排行榜分类接口的更多相关文章
- urllib+BeautifulSoup无登录模式爬取豆瓣电影Top250
对于简单的爬虫任务,尤其对于初学者,urllib+BeautifulSoup足以满足大部分的任务. 1.urllib是Python3自带的库,不需要安装,但是BeautifulSoup却是需要安装的. ...
- 爬虫之爬取豆瓣图书名字及ID
from urllib import request from bs4 import BeautifulSoup as bs #爬取豆瓣最受关注图书榜 resp = request.urlopen(' ...
- Python爬虫使用lxml模块爬取豆瓣读书排行榜并分析
上次使用了BeautifulSoup库爬取电影排行榜,爬取相对来说有点麻烦,爬取的速度也较慢.本次使用的lxml库,我个人是最喜欢的,爬取的语法很简单,爬取速度也快. 本次爬取的豆瓣书籍排行榜的首页地 ...
- Python开发爬虫之静态网页抓取篇:爬取“豆瓣电影 Top 250”电影数据
所谓静态页面是指纯粹的HTML格式的页面,这样的页面在浏览器中展示的内容都在HTML源码中. 目标:爬取豆瓣电影TOP250的所有电影名称,网址为:https://movie.douban.com/t ...
- 【转】爬取豆瓣电影top250提取电影分类进行数据分析
一.爬取网页,获取需要内容 我们今天要爬取的是豆瓣电影top250页面如下所示: 我们需要的是里面的电影分类,通过查看源代码观察可以分析出我们需要的东西.直接进入主题吧! 知道我们需要的内容在哪里了, ...
- Python爬虫之利用BeautifulSoup爬取豆瓣小说(一)——设置代理IP
自己写了一个爬虫爬取豆瓣小说,后来为了应对请求不到数据,增加了请求的头部信息headers,为了应对豆瓣服务器的反爬虫机制:防止请求频率过快而造成“403 forbidden”,乃至封禁本机ip的情况 ...
- python爬取豆瓣电影Top250(附完整源代码)
初学爬虫,学习一下三方库的使用以及简单静态网页的分析.就跟着视频写了一个爬取豆瓣Top250排行榜的爬虫. 网页分析 我个人感觉写爬虫最重要的就是分析网页,找到网页的规律,找到自己需要内容所在的地方, ...
- 爬虫系列(十) 用requests和xpath爬取豆瓣电影
这篇文章我们将使用 requests 和 xpath 爬取豆瓣电影 Top250,下面先贴上最终的效果图: 1.网页分析 (1)分析 URL 规律 我们首先使用 Chrome 浏览器打开 豆瓣电影 T ...
- python爬虫08 | 你的第二个爬虫,要过年了,爬取豆瓣最受欢迎的250部电影慢慢看
马上就要过年啦 过年在家干啥咧 准备好被七大姑八大姨轮番「轰炸」了没? 你的内心 os 是这样的 但实际上你是这样的 应付完之后 闲暇时刻不妨看看电影 接下来咱们就来爬取豆瓣上评分最高的 250部电影 ...
随机推荐
- 快速人体姿态估计:CVPR2019论文阅读
快速人体姿态估计:CVPR2019论文阅读 Fast Human Pose Estimation 论文链接: http://openaccess.thecvf.com/content_CVPR_201 ...
- 广播 (broadcasting)
广播 (broadcasting) 飞桨(PaddlePaddle,以下简称Paddle)和其他框架一样,提供的一些API支持广播(broadcasting)机制,允许在一些运算时使用不同形状的张量. ...
- Google Pixel 超分辨率--Super Resolution Zoom
Google Pixel 超分辨率--Super Resolution Zoom Google 的Super Res Zoom技术,主要用于在zoom时增强画面细节以及提升在夜景下的效果. 文章的主要 ...
- GPU编程和流式多处理器(六)
GPU编程和流式多处理器(六) 5. 纹理和表面 读取和写入纹理和表面的指令,所引用的隐式状态,比其他指令要多得多.header中包含诸如基地址,尺寸,格式和纹理内容的解释之类的参数,该header是 ...
- python_selenium_键盘事件
引言 ----在实际的web测试工作中,需要配合键盘按键来操作,webdriver的 keys()类提供键盘上所有按键的操作,还可以模拟组合键Ctrl+a,Ctrl+v等. 举例: #cording ...
- awr快照保留时间修改
============== awr快照保留时间修改 ============= 1.查询当前awr报告保留时间 col SNAP_INTERVAL for a20col RETENTION for ...
- 一、部署监控服务器--安装LNMP环境
1.要求: 本案例要求部署-台Zabbix监控服务器, -台被监控主机,为进一步执行具体的监控任务做准备:1.安装LNMP环境2.源码安装Zabbix3.安装监控端主机,修改基本配置4.初始化Zabb ...
- 如果你这么去理解HashMap就会发现它真的很简单
Java中的HashMap相信大家都不陌生,也是大家编程时最常用的数据结构之一,各种面试题更是恨不得掘地三尺的去问HashMap.HashTable.ConcurrentHashMap,无论面试题多么 ...
- Java代码优化:使用构造函数和使用一个个setter的效率差别
在对Java代码进行优化的时候,想方设法的要提高整体的效率,使用JProfiler看代码的时间占比,然后,看看哪些部分是可以优化的,减少运行时间的.下面有这么几个方向. 1. 能使用构造函数一步到位的 ...
- Python语言规范之Pylint的使用
1.Pylint是什么 pylint是一个Python源代码中查找bug的工具,能找出错误,和代码规范的运行.也就是你的代码有Error错误的时候能找出来错误,没有错误的时候,能根据Python代码规 ...