
Spark 集群安装部署
安装准备
Spark 集群和 Hadoop 类似,也是采用主从架构,Spark 中的主服务器进程就叫 Master(standalone 模式),从服务器进程叫 Worker
Spark 集群规划如下:
- node-01:Master
- node-02:Worker
- node-03:Worker
安装步骤
1. 上传并解压 Spark 安装文件
将 spark-2.4.7-bin-hadoop2.7.tgz 安装包上传到 node-01 的 /root 目录下,并将其解压
# 解压到 /apps 目录中

[root@node-01 ~]# tar -zxvf spark-2.4.7-bin-hadoop2.7.tgz -C apps/

# 删除安装压缩包

[root@node-01 ~]# rm -rf spark-2.4.7-bin-hadoop2.7.tgz

[root@node-03 ~]# cd /root/apps/

# 改名

[root@node-01 apps]# mv spark-2.4.7-bin-hadoop2.7/ spark-2.4.7
2. 配置环境变量
[root@node-01 ~]# vim /etc/profile

#行尾添加

export SPARK_HOME=/root/apps/spark-2.4.7

export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin

[root@node-01 ~]# source /etc/profile
3. 配置运行环境
[root@node-01 ~]# cd /root/apps/spark-2.4.7/conf/

# 改名(去掉后面的 template 模板后缀名)

[root@node-01 conf]# mv spark-env.sh.template spark-env.sh

[root@node-01 conf]# vi spark-env.sh

# 行尾添加

export JAVA_HOME=/root/apps/jdk1.8.0_141/

# 设置 Spark Master 所在的主机名(或IP地址)

export SPARK_MASTER_HOST=node-01

export SPARK_MASTER_PORT=7077
4. 修改 slaves 配置
该脚本文件用于设置 Master 下面的 Worker 的主机名(或IP地址)
[root@node-01 ~]# cd /root/apps/spark-2.4.7/conf/

# 改名(去掉后面的 template 模板后缀名)

[root@node-01 conf]# mv slaves.template slaves

[root@node-01 conf]# vi slaves

node-02

node-03
5. 创建启动和关闭 Spark 集群脚本软连接
创建软连接的原因是 hadoop/sbin 目录和 spark/sbin 目录脚本可能命名相同,导致执行命令冲突
[root@node-01 ~]# cd /root/apps/spark-2.4.7/sbin/

[root@node-01 sbin]# ln -s start-all.sh start-all-spark.sh

[root@node-01 sbin]# ln -s stop-all.sh stop-all-spark.sh
5. 将 Spark 安装包复制到集群其他主机上
[root@node-01 ~]# cd /etc

[root@node-01 etc]# scp profile node-02:$PWD

[root@node-01 etc]# scp profile node-03:$PWD

[root@node-02 ~]# source /etc/profile

[root@node-03 ~]# source /etc/profile

[root@node-01 ~]# cd apps/

[root@node-01 apps]# scp -r  spark-2.4.7/  node-02:$PWD

[root@node-01 apps]# scp -r  spark-2.4.7/  node-03:$PWD
6. 启动 Spark 集群
Spark 的 sbin 目录(里面存放各种 Spark 操作命令)
[root@node-01 ~]# start-all-spark.sh

starting org.apache.spark.deploy.master.Master, logging to /root/apps/spark-2.4.7/logs/spark-root-org.apache.spark.deploy.master.Master-1-hdp-01.out

hdp-03: starting org.apache.spark.deploy.worker.Worker, logging to /root/apps/spark-2.4.7/logs/spark-root-org.apache.spark.deploy.worker.Worker-1-hdp-03.out

hdp-02: starting org.apache.spark.deploy.worker.Worker, logging to /root/apps/spark-2.4.7/logs/spark-root-org.apache.spark.deploy.worker.Worker-1-hdp-02.out

[root@hdp-01 sbin]# jps

1690 Master

1742 Jps
再去查看 node-02 和 node-03
[root@node-02 ~]# jps

1557 Jps

1512 Worker

[root@node-03 ~]# jps

1538 Worker

1583 Jps
说明 Spark 集群已经启动成功
- 单独启动 Master:# start-master.sh
- 单独启动 Worker:# start-slave.sh spark://node-01:7077
6. 启动 Spark 的浏览器 Web 页面
这里 Web 的服务器端口号是 8080(端口号 7077 是 RPC 远程调用的通信端口)
打开浏览器输入:http://node-01:8080/ 回车
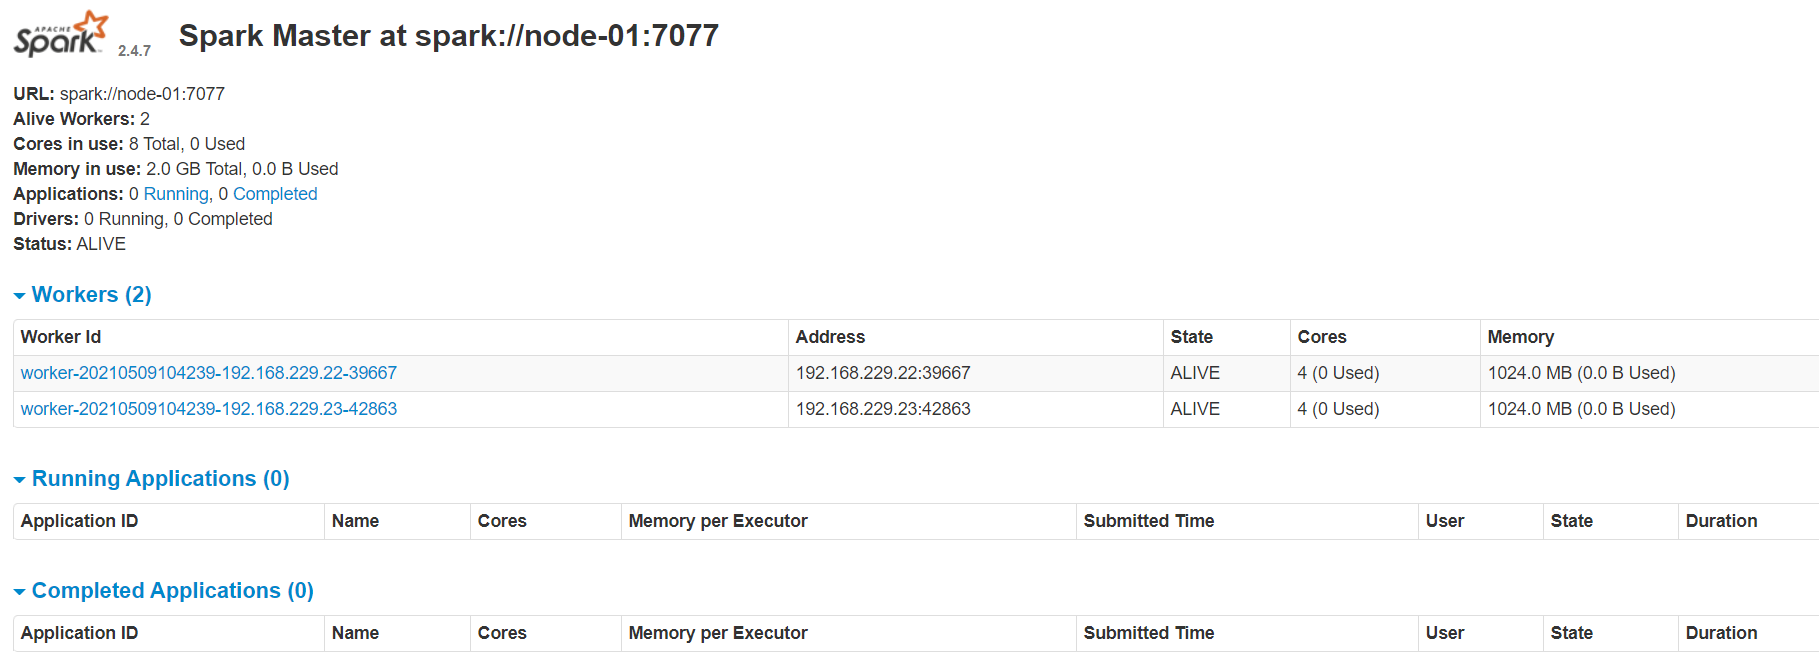
默认情况下 Spark 会占用机器上的所有 cores(CPU)和 memory(内存)
Spark 集群安装部署的更多相关文章
- Hadoop2.2集群安装配置-Spark集群安装部署
配置安装Hadoop2.2.0 部署spark 1.0的流程 一.环境描写叙述 本实验在一台Windows7-64下安装Vmware.在Vmware里安装两虚拟机分别例如以下 主机名spark1(19 ...
- spark集群安装部署
通过Ambari(HDP)或者Cloudera Management (CDH)等集群管理服务安装和部署在此不多介绍,只需要在界面直接操作和配置即可,本文主要通过原生安装,熟悉安装配置流程. 1.选取 ...
- [bigdata] spark集群安装及测试
在spark安装之前,应该已经安装了hadoop原生版或者cdh,因为spark基本要基于hdfs来进行计算. 1. 下载 spark: http://mirrors.cnnic.cn/apache ...
- CentOS6安装各种大数据软件 第十章:Spark集群安装和部署
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- Spark入门:第2节 Spark集群安装:1 - 3;第3节 Spark HA高可用部署:1 - 2
三. Spark集群安装 3.1 下载spark安装包 下载地址spark官网:http://spark.apache.org/downloads.html 这里我们使用 spark-2.1.3-bi ...
- Spark 个人实战系列(1)--Spark 集群安装
前言: CDH4不带yarn和spark, 因此需要自己搭建spark集群. 这边简单描述spark集群的安装过程, 并讲述spark的standalone模式, 以及对相关的脚本进行简单的分析. s ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- spark集群安装配置
spark集群安装配置 一. Spark简介 Spark是一个通用的并行计算框架,由UCBerkeley的AMP实验室开发.Spark基于map reduce 算法模式实现的分布式计算,拥有Hadoo ...
- HBase集群安装部署
0x01 软件环境 OS: CentOS6.5 x64 java: jdk1.8.0_111 hadoop: hadoop-2.5.2 hbase: hbase-0.98.24 0x02 集群概况 I ...
随机推荐
- Dynamics CRM证书更换
Dynamics CRM产品一般有两种认证方式.第一种是基于声明的内部访问也就是无证书单纯用账号密码验证.第二种就是联合身份认证,需要安装网站证书. 对于联合身份认证的情况因为需要安装证书,而且证书是 ...
- 如何在 NET 程序万种死法中有效的生成 Dump (上)
一:背景 相信很多人都知道通过 任务管理器 抓取dump,虽然简单粗暴,但无法满足程序的无数种死法,比如: 内存膨胀,程序爆炸 CPU爆高,程序累死 应用无响应,用户气死 意外退出,和人生一样 既然手 ...
- 消息队列高手课,带你从源码角度全面解析MQ的设计与实现
消息队列中间件的使用并不复杂,但如果你对消息队列不熟悉,很难构建出健壮.稳定并且高性能的企业级系统,你会面临很多实际问题: 如何选择最适合系统的消息队列产品? 如何保证消息不重复.不丢失? 如果你掌握 ...
- 【CTF】2019湖湘杯 miscmisc writeup
题目来源:2019湖湘杯 题目链接:https://adworld.xctf.org.cn/task/answer?type=misc&number=1&grade=1&id= ...
- IDEA xml 注解快捷键
注释:CTRL + SHIFT + / 撤销注释:CTRL + SHIFT + \
- Day15_86_通过反射机制获取所有方法(method)
通过反射机制获取所有方法(method) import java.lang.reflect.Field; import java.lang.reflect.Method; import java.la ...
- JavaScript设计模式(二):工厂模式
工厂模式模式的定义与特点 工厂模式(Factory Pattern)是编程中最常用的设计模式之一.这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式.在工厂模式中,我们在创建对象时不会对 ...
- java中switch的用法
switch关键字对于多数java学习者来说并不陌生,由于笔试和面试经常会问到它的用法,这里做了一个简单的总结: 能用于switch判断的类型有:byte.short.int.char(JDK1.6) ...
- Redis持久化——AOF日志
最新:Redis内存--内存消耗(内存都去哪了?) 最新:Redis持久化--如何选择合适的持久化方式 最新:Redis持久化--AOF日志 更多文章... 上一篇文章Redis持久化--内存快照(R ...
- Standalone模式下,通过Systemd管理Flink1.11.1的启停及异常退出
Flink以Standalone模式运行时,可能会发生jobmanager(以下简称jm)或taskmanager(以下简称tm)异常退出的情况,我们可以使用Linux自带的Systemd方式管理jm ...