
EDG夺冠!用Python分析22.3万条数据:粉丝都疯了!
一、EDG夺冠信息
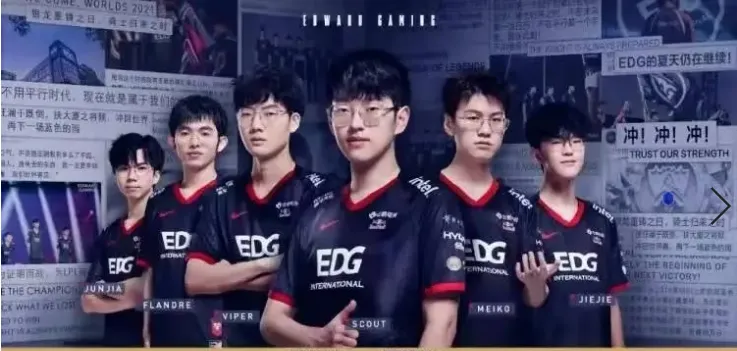
11月6日,在英雄联盟总决赛中,EDG战队以3:2战胜韩国队,获得2021年英雄联盟全球总决赛冠军,这个比赛在全网各大平台也是备受瞩目:
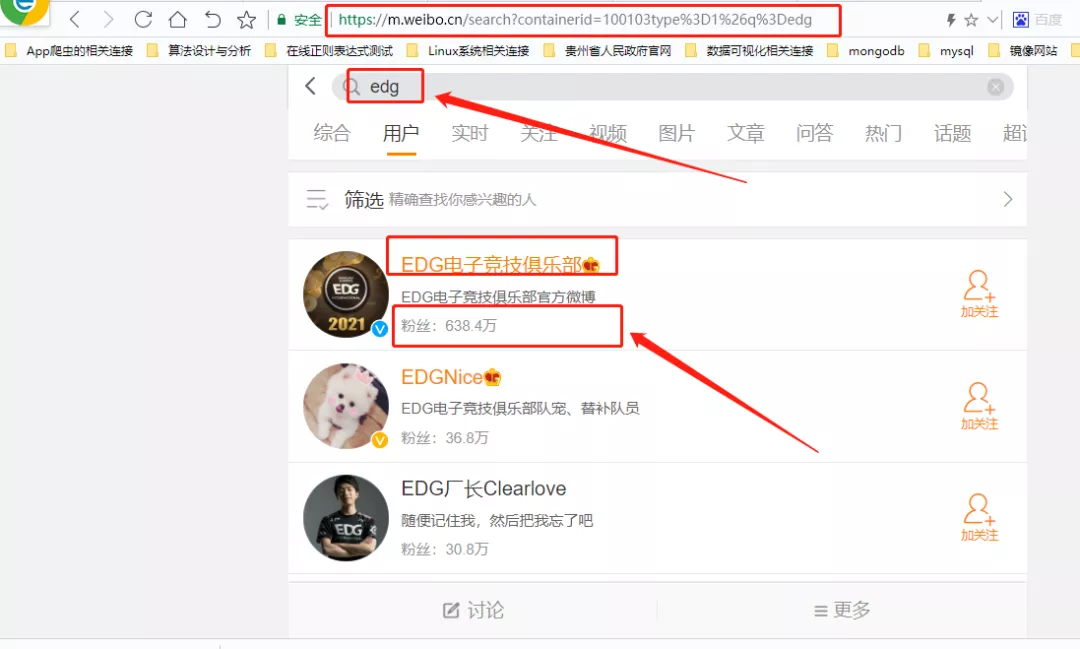
1、微博热搜第一名,截止2021-11-10已有亿级观看量,微博粉丝数到达638.4万
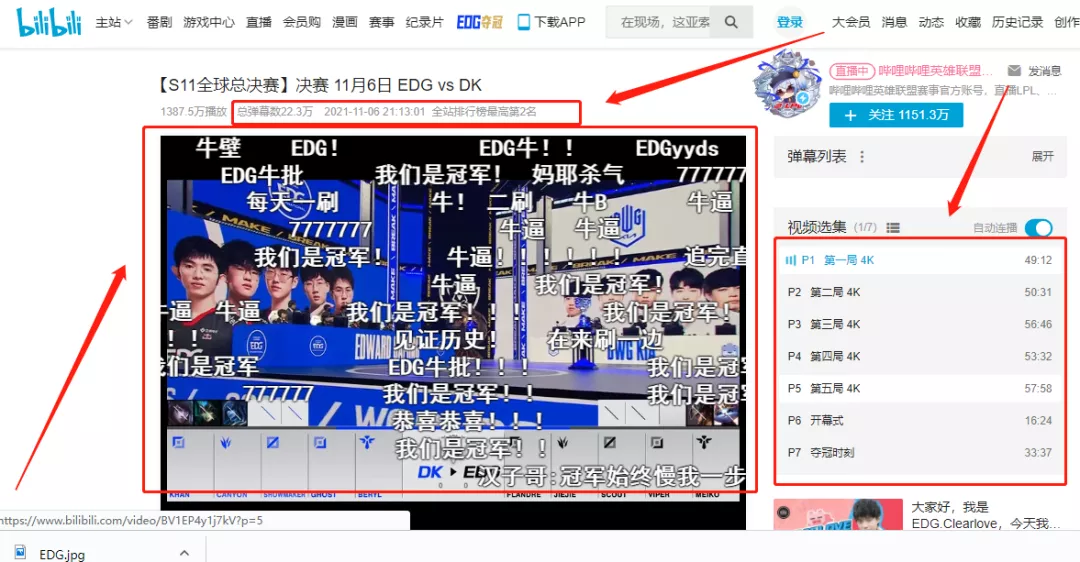
2、哔哩哔哩已有几亿人气,总弹幕有22.3万,全站排行榜最高第2名,B站粉丝已有219.9万

3、腾讯、爱奇艺、优酷等视频平台800万人看过
4、虎牙等直播平台热度也是居高不下
5、央视新闻也发微博庆祝EDG夺冠

既然比赛热度这么高,那么本次我们就以bilibili为基准,通过采集EDG夺冠比赛视频在哔哩哔哩的22.3万条弹幕数据,再通过Python来分析进而感受粉丝的热情
二、实战目标
1、利用爬虫技术抓取EDG战队在B站夺冠比赛视频的22.3万条弹幕数据
2、通过jieba、numpy等Python库对抓取来的弹幕数据进行分析并且可视化
三、bilibili接口分析
首先进入EDG夺冠比赛视频URL:
https://www.bilibili.com/video/BV1EP4y1j7kV?p=1
哔哩哔哩已为大家整理好了EDG比赛视频,从开幕式到夺冠时刻,共有7个视频

哔哩哔哩弹幕数据接口:
http://api.bilibili.com/x/v1/dm/list.so?oid=XXX
这个接口就是B站弹幕数据专用接口,我们可以直接拿来用,这个接口中的oid可以理解为每个视频中的唯一标识符,它由数字组成,每一个视频都有唯一的一个oid,那么我们只要找到oid就可以请求相应比赛视频弹幕的API接口,从而抓取弹幕数据
获取oid
打开开发者工具,切换到Network选项,然后找到以pagelist为开头的请求接口

接着找到Request URL这个请求接口,打开新窗口直接用这个API接口请求,如下图:
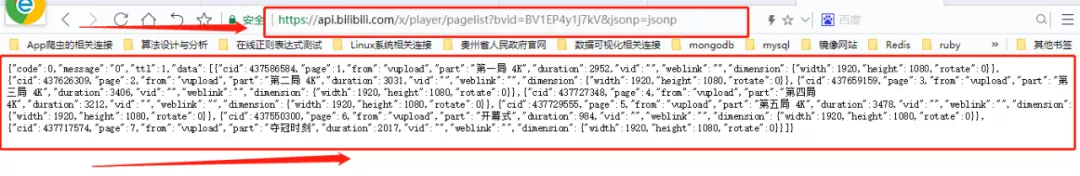
当我们直接请求这个API接口时可以看到JSON格式的数据,而在里面的cid就是我们需要的oid,如下所示:
1 {"code":0,"message":"0","ttl":1,"data":[{"cid":437586584,"page":1,"from":"vupload","part":"第一局 4K","duration":2952,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437626309,"page":2,"from":"vupload","part":"第二局 4K","duration":3031,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437659159,"page":3,"from":"vupload","part":"第三局 4K","duration":3406,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437727348,"page":4,"from":"vupload","part":"第四局 4K","duration":3212,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437729555,"page":5,"from":"vupload","part":"第五局 4K","duration":3478,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437550300,"page":6,"from":"vupload","part":"开幕式","duration":984,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}},{"cid":437717574,"page":7,"from":"vupload","part":"夺冠时刻","duration":2017,"vid":"","weblink":"","dimension":{"width":1920,"height":1080,"rotate":0}}]
当然我们也可以点击Preview选项,点击data,打开数据,而里面的JSON数据是折叠的,包括cid在内,如下图所示:
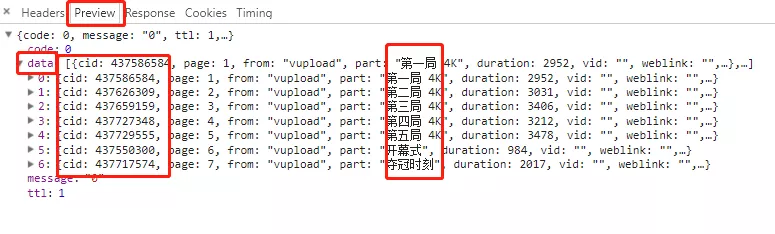
可以看到,每个cid对应每一个比赛视频。我们也可以点击Response选项,里面的数据是真实的数据,意味着数据没有经过折叠,与直接请求Request URL返回的JSON数据是一样的
四、编码
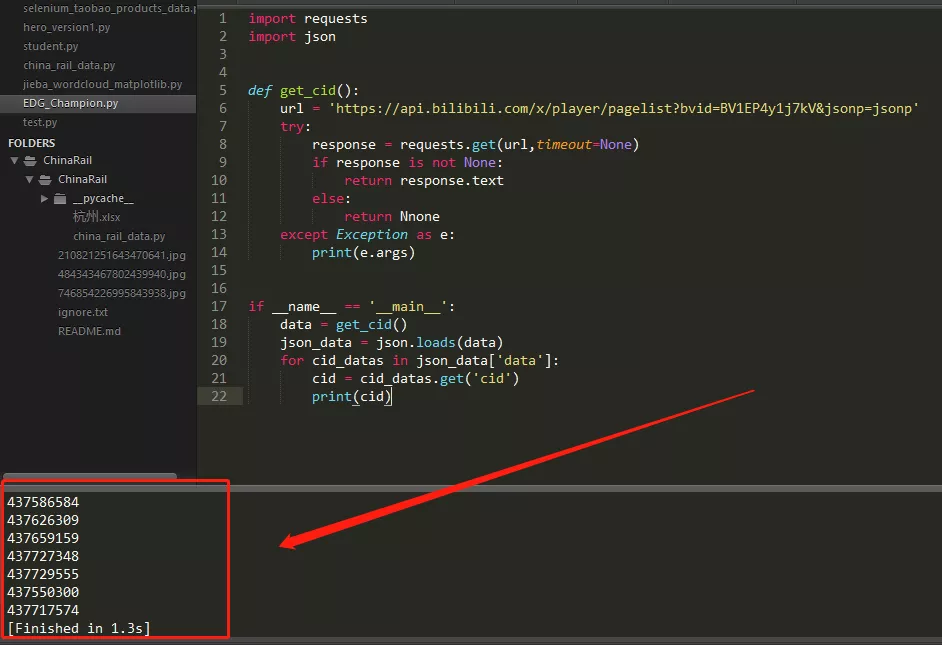
定义一个获取cid的方法
 1 import requests

 2 import json

 3

 4

 5 def get_cid():

 6   url = 'https://api.bilibili.com/x/player/pagelist?bvid=BV1EP4y1j7kV&jsonp=jsonp'

 7   try:

 8     response = requests.get(url,timeout=None)

 9     if response is not None:

10       return response.text

11     else:

12       return Nnone

13   except Exception as e:

14     print(e.args)

15

16

17 if __name__ == '__main__':

18   data = get_cid()

19   json_data = json.loads(data)

20   for cid_datas in json_data['data']:

21     cid = cid_datas.get('cid')

22     print(cid)
控制台输出如下:
拼接URL弹幕数据API接口
1 if __name__ == '__main__':

2   data = get_cid()

3   json_data = json.loads(data)

4   base_api = 'http://api.bilibili.com/x/v1/dm/list.so?oid='

5   for cid_datas in json_data['data']:

6     cid = cid_datas.get('cid')

7     detail_api = base_api + str(cid)

8     print(detail_api)
控制台输出如下:
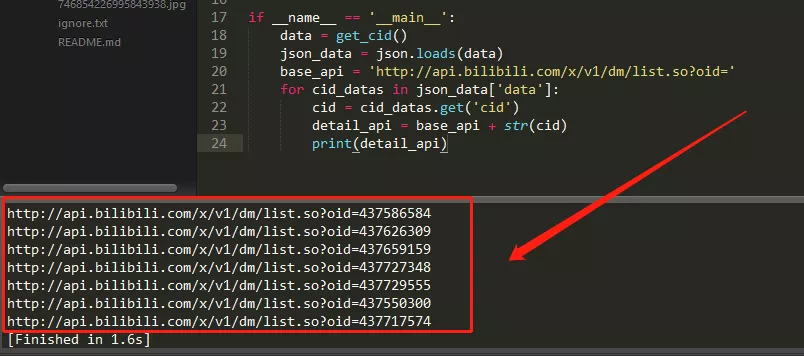
一共有7个网址,对应7个EDG比赛视频的弹幕数据,我们点开第一个网址查看

抓取弹幕数据
从上一张图可以看到,每一条弹幕数据都在每一个<d>标签中,面对这种格式我们思考一下用哪种解析工具比较合适?答案当然是正则表达式,接下来我们要获取7个比赛视频的22.3万条数据,代码如下:
 1 base_api = 'http://api.bilibili.com/x/v1/dm/list.so?oid='

 2   all_api = []

 3   for cid_datas in json_data['data']:

 4     cid = cid_datas.get('cid')

 5     detail_api = base_api + str(cid)

 6     all_api.append(detail_api)

 7   for api in all_api:

 8     edg_datas = get_api_data(detail_api)

 9     edg_datas = re.findall('<d.*?>(.*?)</d>',edg_datas,re.S)

10     with open('EDG.txt','a',encoding='utf-8') as f:

11       for edg_data in edg_datas:

12         print(edg_data)

13         f.write(edg_data + '\n')
避免乱码,加上如下代码:
1 response.encoding = chardet.detect(response.content)['encoding']
控制台输出如下:
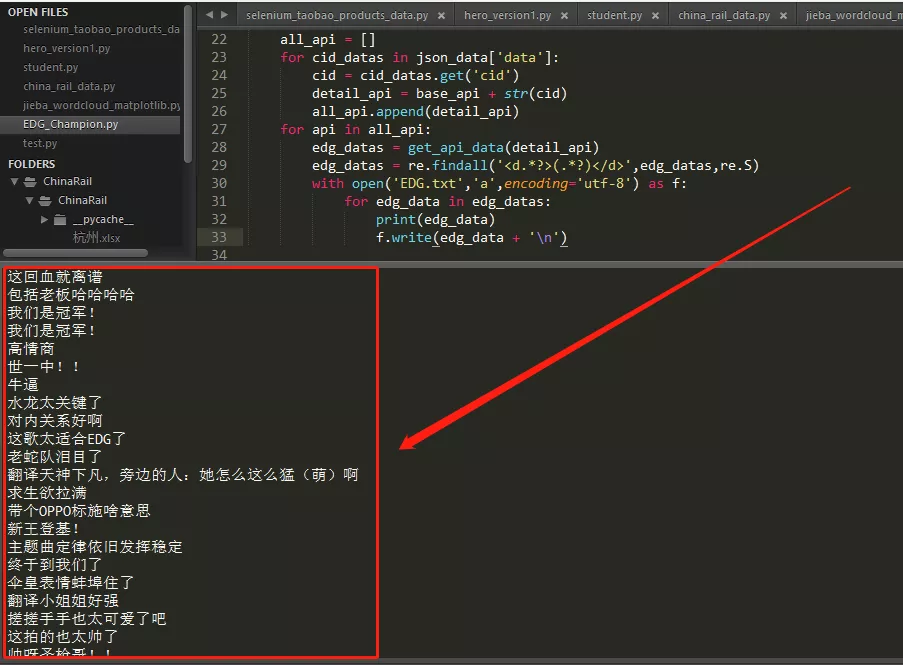
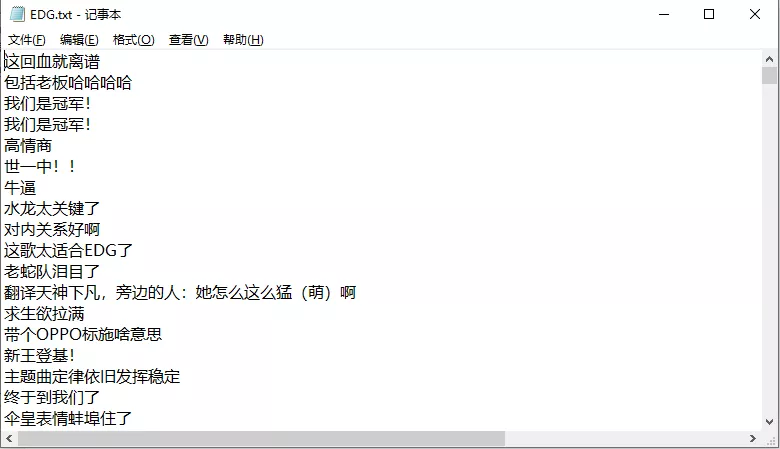
由于弹幕数据共有22.3万条,这里仅展示EDG.txt部分弹幕数据,如下图所示:
词云图制作
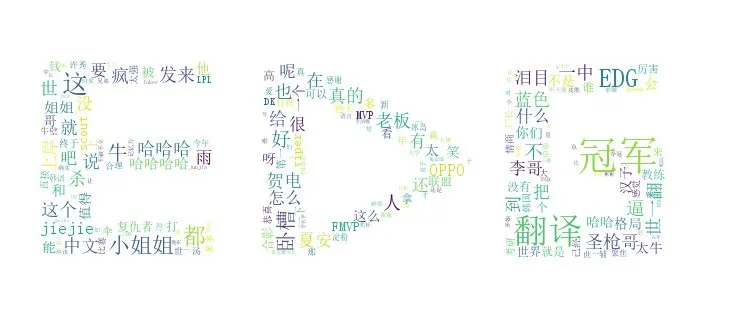
我们已经抓取到弹幕数据,接下来利用EDG背景图做一个词云图
代码如下:
 1 import jieba

 2 from wordcloud import WordCloud

 3 import matplotlib.pyplot as plt

 4 from PIL import Image

 5 import numpy as np

 6

 7 def do_wordcloud():

 8   text = open('EDG.txt','r',encoding='utf-8').read()

 9   text = text.replace('\n','').replace('\u3000','')

10   text_cut = jieba.lcut(text)

11   text_cut = ' '.join(text_cut)

12

13   #过滤一些没有关系的词

14   stop_words = ['“',',',' ','我','的','是','了',':','?','!','啊','你','吗','。','我们']

15

16   background = Image.open("EDG.jpg")

17   graph = np.array(background)

18

19   word_cloud = WordCloud(font_path='simsun.ttc',

20                          background_color='white',

21                          mask=graph, # 指定词云的形状

22                          stopwords=stop_words)

23

24   word_cloud.generate(text_cut)

25   plt.subplots(figsize=(12,8))

26   plt.imshow(word_cloud)

27   plt.axis('off')

28   plt.show()

29   word_cloud.to_file('edg.png')
控制台输出如下:
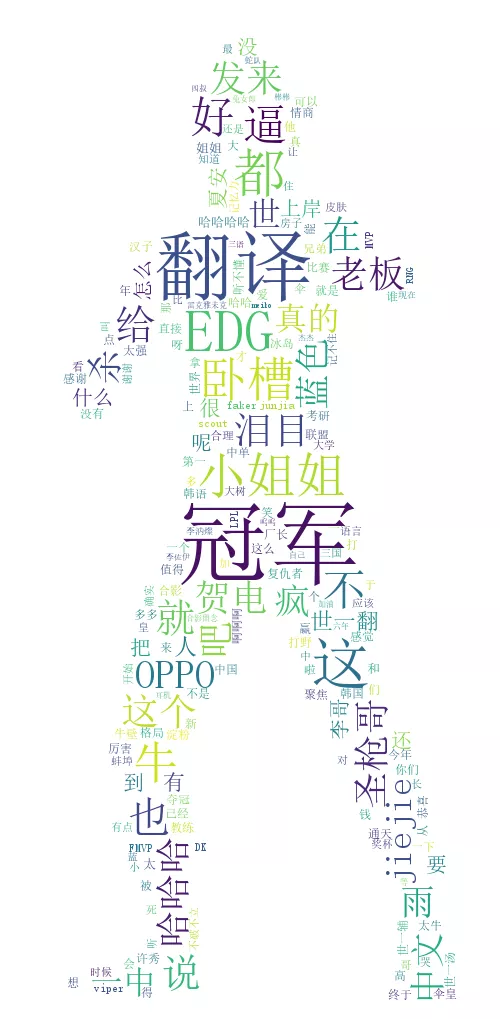
把迪迦奥特曼背景图片也制作一波吧,哈哈哈!
制作成迪迦奥特曼词云图形状,如下所示:
当然你也可以使用pyecharts/echarts制作也行,还可以制作成你喜欢的图片形状。如果你接触过情感分析的话,也可以用这些弹幕数据分析一波
五、总结
PIL库
jieba库
numpy库
requests库
wordcloud库
matplotlib库
json,re,chardet库
六、完整项目及源码下载
完整项目(包括源码)获取方式:下载
原创不易,如果觉得有趣好玩,希望可以随手点个赞,拜谢各位老铁!
更多独家精彩内容 请扫码关注个人公众号,我们一起成长,一起Coding,让编程更有趣!
—— —— —— —— — END —— —— —— —— ————
欢迎扫码关注我的公众号
小鸿星空科技

EDG夺冠!用Python分析22.3万条数据:粉丝都疯了!的更多相关文章
- [Python] 通过采集两万条数据,对《无名之辈》影评分析
一.说明 本文主要讲述采集猫眼电影用户评论进行分析,相关爬虫采集程序可以爬取多个电影评论. 运行环境:Win10/Python3.5. 分析工具:jieba.wordcloud.pyecharts.m ...
- [Python] 通过采集23万条数据,对《哪吒》影评分析
一.说明 数据来源:猫眼: 运行环境:Win10/Python3.7 和 Win7/Python3.5: 分析工具:jieba.WorldCloud.pyecharts和matplotlib: 程序基 ...
- (转)Python网络爬虫实战:世纪佳缘爬取近6万条数据
又是一年双十一了,不知道从什么时候开始,双十一从“光棍节”变成了“双十一购物狂欢节”,最后一个属于单身狗的节日也成功被攻陷,成为了情侣们送礼物秀恩爱的节日. 翻着安静到死寂的聊天列表,我忽然惊醒,不行 ...
- Mvc+Dapper+存储过程分页10万条数据
10万条数据采用存储过程分页实现(Mvc+Dapper+存储过程) 有时候大数据量进行查询操作的时候,查询速度很大强度上可以影响用户体验,因此自己简单写了一个demo,简单总结记录一下: 技术:Mvc ...
- 复杂业务下向Mysql导入30万条数据代码优化的踩坑记录
从毕业到现在第一次接触到超过30万条数据导入MySQL的场景(有点low),就是在顺丰公司接入我司EMM产品时需要将AD中的员工数据导入MySQL中,因此楼主负责的模块connector就派上了用场. ...
- 插入1000万条数据到mysql数据库表
转自:https://www.cnblogs.com/fanwencong/p/5765136.html 我用到的数据库为,mysql数据库5.7版本的 1.首先自己准备好数据库表 其实我在插入100 ...
- 绝对干货,教你4分钟插入1000万条数据到mysql数据库表,快快进来
我用到的数据库为,mysql数据库5.7版本的 1.首先自己准备好数据库表 其实我在插入1000万条数据的时候遇到了一些问题,现在先来解决他们,一开始我插入100万条数据时候报错,控制台的信息如下: ...
- 1000万条数据导入mysql
今天需要将一个含有1000万条数据的文本内容插入到数据库表中,最初自然想到的是使用Insertinto '表名'values(),(),()...这种插入方式,但是发现这种方式对1000万条数据量的情 ...
- QTreeView处理大量数据(使用1000万条数据,每次都只是部分刷新)
如何使QTreeView快速显示1000万条数据,并且内存占用量少呢?这个问题困扰我很久,在网上找了好多相关资料,都没有找到合理的解决方案,今天在这里把我的解决方案提供给朋友们,供大家相互学习. 我开 ...
随机推荐
- whistle安装
可参考官方帮助文档:https://wproxy.org/whistle/install.html 系统:windows10 jdk:1.8.0_171 node:10.16.0 np ...
- 定要过python二级 第二套
1.name=random.choice(brandlist) 与第一套中的 random.randint() 2. eval(input()) 看到一段代码,判读输入的数字,用的是eva ...
- Ubuntu安装Oracleclient远程连接数据库
平时Oracle数据库都安装在本地或者WindowsServer上进行使用,但因为工作需要,领导要求在虚拟机中安装Ubuntu来连接Windows本地安装的数据库,先将操作过程和遇到的问题进行梳理总结 ...
- 题解 GT考试
题目传送门 题目大意 给出\(n,m,k\),以及一个长度为\(m\)的数字串\(s_{1,2,...,m}\),求有多少个长度为\(n\)的数字串\(X\)满足\(s\)不出现在其中的个数模\(k\ ...
- spoj2 prime1 (区间筛)
给定t组询问,每组询问包括一个l和r,要求\([l,r]\)的素数有哪些 其中\(t \le 10,1 \le l \le r \le 1000000000 , r-l \le 100000\) Qw ...
- 全场景效能平台猪齿鱼常用的前端css实现方案
居中 最常用的height + line-height,以及margin:0 auto的居中方式就不再阐述,以下介绍两种容错性高的实现方案. flex布局实现 猪齿鱼前端日常开发中,我们多以f ...
- Hadoop面试题(四)——YARN
1.简述hadoop1与hadoop2 的架构异同 1)加入了yarn解决了资源调度的问题. 2)加入了对zookeeper的支持实现比较可靠的高可用. 2.为什么会产生 yarn,它解决了什么问题, ...
- CentOS 用户与群组
目录 1.用户管理 1.1.切换用户 1.2.添加用户 1.3.删除用户 1.4.修改用户 2.群组管理 2.1.查看群组 2.2.添加群组 2.3.删除群组 2.4.修改群组 1.用户管理 Linu ...
- Python使用阿里云OSS服务
Python使用阿里云OSS服务 前言: 在远程搭建了一个平台,通过改远程平台进行数据的采集,需要将数据内容传送至本地进行处理:为了实现该功能,考虑了阿里云的OSS对象储存的服务. 40G包月只需1元 ...
- NKOJ-2936 城市建设
问题描述: PS国是一个拥有诸多城市的大国,国王Louis为城市的交通建设可谓绞尽脑汁.Louis可以在某些城市之间修建道路,在不同的城市之间修建道路需要不同的花费.Louis希望建造最少的道路使得国 ...