
CUDA计算矩阵相乘
1.最简单的 kernel 函数
__global__ void MatrixMulKernel( float* Md, float* Nd, float* Pd, int Width)

{

    int tx = threadIdx.x; // cloumn

    int ty = threadIdx.y; // row

    float Pvalue = 0;

    for (int k = 0; k<Width; k++)

    {

        float Mdele = Md[ty*Width + k];

        float Ndele = Nd[k*Width + tx];

        Pvalue += Mdele * Ndele;

    }

    Pd[ty*Width + tx] = Pvalue;

}
2.适用更大矩阵
第一节中例子缺点是,假如使用更多的块时,每个块中会计算相同的矩阵。而且矩阵元素不能超过512个线程(块最大线程限制)。
改进方法是,假设每个块维度都是方阵形式,且其维度由变量 TILE_WIDTH 指定。矩阵 Pd 的每一维都划分为部分,每个部分包含 TILE_WIDTH 个元素。
#define TILE_WIDTH 4

#define Width 8

__global__ void MatrixMulKernel( float* Md, float* Nd, float* Pd, int Width)

{

    int Col = blockId.x*TILE_WIDTH + threadIdx.x; // cloumn

    int Row = blockId.y*TILE_WIDTH + threadIdx.y; // row

    float Pvalue = 0;

    for (int k = 0; k<Width; k++)

    {

        Pvalue += Md[Row*Width + k] * Nd[k*Width + Col];

    }

    Pd[ty*Width + tx] = Pvalue;

}
dim3 dimGrid(Width/TILE_WIDTH, Width/TILE_WIDTH);

dim3 dimBlock(TILE_WIDTH, TILE_WIDTH);
CUDA 硬件相关概念
针对 GT200而言
- 每个
SM有最多8个块 - 每个
SM有最多1024个线程
应当注意每个块中分配的线程数,以便能够充分利用SM
- 以32个线程为一个
warp,warp为线程调度单位
3.通过改变储存器提到访问效率
CGMA(Compute to Global Memory Access),尽量提高CGMA比值。
对前面来说,每个for循环内需要两次访问全局内存(Md[Row*Width + k], Nd[k*Width + Col]),两次浮点计算(加法与乘法)。因此 CGMA 为2:2 = 1。
G80 全局存储器带宽为 86.4 GB/s,计算峰值性能 367 Gflops。(每秒取 21.6G 个变量,由于CGMA=1,会进行 21.6G 次浮点计算)
若每个单精度浮点数为 4 字节,那么由于存储器限制,最大浮点操作不会超过 21.6 Gflops。
| 存储器类型 | 变量 | 周期 | 特点 | 访问速度 |
| --- | --- | --- | --- |
| 共享存储器 | 共享变量 | kernel函数 | 每个块中所有线程都可以访问,用于线程间协作高效方式 | 相当快,高度并行访问 |
| 常数存储器 | 常数变量 | 所有网格 | 相当快,并行访问 |
| 寄存器 | 自动变量 | 线程 | 寄存器具有储存容量限制 | 非常块
| 全局存储器 | 全局变量 | | 用于调用不同kernel函数时传递信息 | 慢 |
减少全局存储器流量策略
各个存储器特点:
- 全局存储器,容量大,访问慢
- 共享存储器,容量小,访问块
新算法要点:
- 将共享存储器上数据划分子集,每个子集满足共享存储器容量限制
- 通过线程协作将
M和N中的元素加载到共享存储器中,每个线程负责块中一个元素赋值(Mds[threadIdx.y][threadIdx.x],Nds[threadIdx.y][threadIdx.x]) - 通过加载到共享存储器,使得每个块访问全局内存的次数减小为原来的
TILE_WIDTH分之一(加载到共享内存时读取一次,每个块中使用TILE_WIDTH次)
__global__ void kernel_tile(float* M, float* N, float* P){

	int i, k;

	float Pvalue = 0;

	__shared__ float Mds[tile_width][tile_width];

	__shared__ float Nds[tile_width][tile_width];

	int Row = threadIdx.y + blockIdx.y*tile_width;

	int Col = threadIdx.x + blockIdx.x*tile_width;

	for( i = 0; i< width/tile_width; i++ ){

		Mds[threadIdx.y][threadIdx.x] = M[Row*width + i*tile_width + threadIdx.x];

		Nds[threadIdx.y][threadIdx.x] = N[(threadIdx.y + i*tile_width)*width + Col];

		__syncthreads();

		for (k = 0; k<tile_width; k++){

			Pvalue += Mds[threadIdx.y][k]*Nds[k][threadIdx.x];

		}

		__syncthreads();

	}

	P[Row*width + Col] = Pvalue;

}
存储器容量限制
G80 硬件中
- 每个
SM寄存器大小为 8 KB(8192 B) - 每个
SM共享内存大小为 16 KB - 若每个
SM中容纳线程数为 768,那么每个线程可用寄存器不超过 8 KB/768=10 Bytes(两个单精度变量占用 8 Bytes) - 若每个线程占用了多余 10 Bytes,那么就会减少
SM上线程数,且以块为单位减少 - 若每个
SM中容纳 8 个块,那么每个块不能使用超过 2 KB 的存储器
4.数据预取
在 CUDA 中,当某些线程在等待其存储器访问结果时,CUDA 线程模型可以通过允许其他 warp 继续运行,这样就能容许长时间的访问延时。
为了充分利用此特性,需要当使用当前数据元素时预取下一个数据元素,这样就可以正价在储存器访问和已访问的数据使用指令之间的独立指令的数目。
预取技术经常和分块技术结合,解决带宽限制和长时间延迟问题。
例如在第三节中矩阵乘法问题中,使用预取技术后函数流程变为
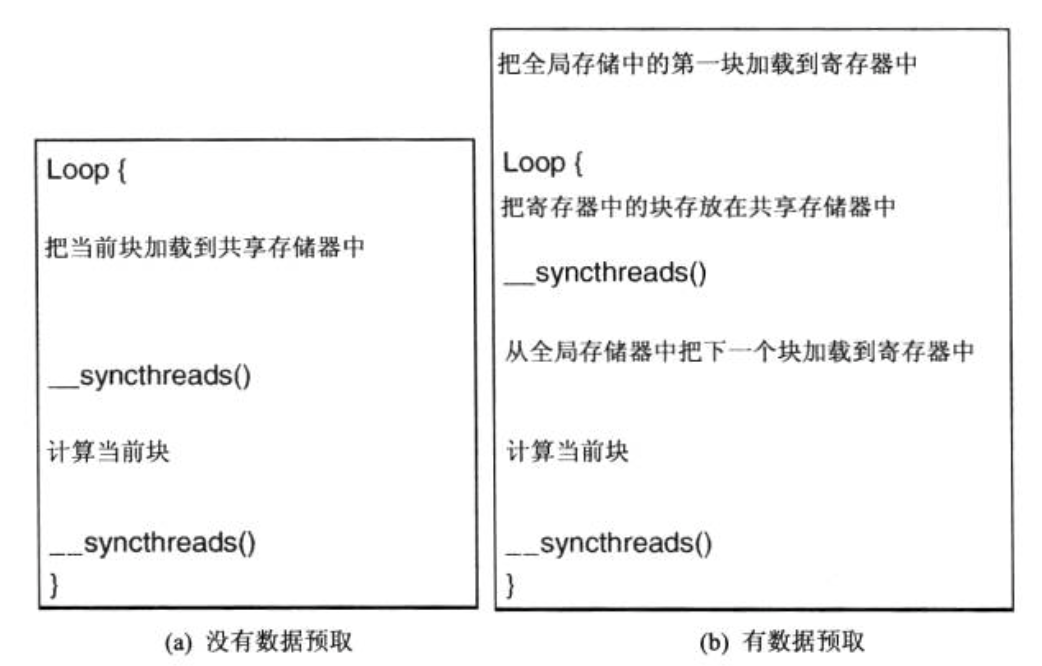
对应程序为
__global__ void kernel_prefetch(float* M, float* N, float* P){

	int i;

	float Pvalue = 0;

	float Mc, Nc;

	int Row = threadIdx.y + tile_width*blockIdx.y;

	int Col = threadIdx.x + tile_width*blockIdx.x;

	__shared__ float Mds[tile_width][tile_width];

	__shared__ float Nds[tile_width][tile_width];

	Mc = M[Row*width + threadIdx.x];

	Nc = N[Col + threadIdx.y*width];

	for (i = 1; i<width/tile_width+1; i++){

		Mds[threadIdx.y][threadIdx.x] = Mc;

		Nds[threadIdx.y][threadIdx.x] = Nc;

		__syncthreads();

		Mc = M[Row*width + threadIdx.x + i*tile_width];

		Nc = N[Col + (threadIdx.y + i*tile_width)*width];

		for (int k = 0; k<tile_width; k++){

			Pvalue += Mds[threadIdx.y][k]*Nds[k][threadIdx.x];

		}

		__syncthreads();

	}

	P[Col + Row*width] = Pvalue;

}
Mc,Nc 为增加的两个储存在寄存器内的变量。
CUDA计算矩阵相乘的更多相关文章
- STL模板之_map,stack(计算矩阵相乘的次数)
#include <map>#include <stack>#include <iostream>using namespace std; struct Node ...
- Java实现矩阵相乘问题
1 问题描述 1.1实验题目 设M1和M2是两个n×n的矩阵,设计算法计算M1×M2 的乘积. 1.2实验目的 (1)提高应用蛮力法设计算法的技能: (2)深刻理解并掌握分治法的设计思想: (3)理解 ...
- CUDA编程-(2)其实写个矩阵相乘并不是那么难
程序代码及图解析: #include <iostream> #include "book.h" __global__ void add( int a, int b, i ...
- 编程计算2×3阶矩阵A和3×2阶矩阵B之积C。 矩阵相乘的基本方法是: 矩阵A的第i行的所有元素同矩阵B第j列的元素对应相乘, 并把相乘的结果相加,最终得到的值就是矩阵C的第i行第j列的值。 要求: (1)从键盘分别输入矩阵A和B, 输出乘积矩阵C (2) **输入提示信息为: 输入矩阵A之前提示:"Input 2*3 matrix a:\n" 输入矩阵B之前提示
编程计算2×3阶矩阵A和3×2阶矩阵B之积C. 矩阵相乘的基本方法是: 矩阵A的第i行的所有元素同矩阵B第j列的元素对应相乘, 并把相乘的结果相加,最终得到的值就是矩阵C的第i行第j列的值. 要求: ...
- cuda计算的分块
gpu的架构分为streaming multiprocessors 每个streaming multiprocessors(SM)又能分步骤执行很多threads,单个SM内部能同时执行的thread ...
- 利用Hadoop实现超大矩阵相乘之我见(二)
前文 在<利用Hadoop实现超大矩阵相乘之我见(一)>中我们所介绍的方法有着“计算过程中文件占用存储空间大”这个缺陷,本文中我们着重解决这个问题. 矩阵相乘计算思想 传统的矩阵相乘方法为 ...
- 利用Hadoop实现超大矩阵相乘之我见(一)
前记 最近,公司一位挺优秀的总务离职,欢送宴上,她对我说“你是一位挺优秀的程序员”,刚说完,立马道歉说“对不起,我说你是程序员是不是侮辱你了?”我挺诧异,程序员现在是很低端,很被人瞧不起的工作吗?或许 ...
- POJ 2246 Matrix Chain Multiplication(结构体+栈+模拟+矩阵相乘)
题意:给出矩阵相乘的表达式,让你计算需要的相乘次数,如果不能相乘,则输出error. 思路: 参考的网站连接:http://blog.csdn.net/wangjian8006/article/det ...
- MapReduce实现矩阵相乘
矩阵相乘能够查看百度百科的解释http://baike.baidu.com/view/2455255.htm?fr=aladdin 有a和b两个矩阵 a: 1 2 ...
随机推荐
- kivy布局(一)
# import kivy from kivy.app import App # 导入应用 from kivy.uix.label import Label # 导入标签 from kivy.uix. ...
- find&正则表达式
标准的正则表示式格式 常用元字符 代码 说明 . 匹配除换行符以外的任意字符 \w 匹配字母或数字或下划线 \s 匹配任意的空白符 \d 匹配数字 \b 匹配单词的开始或结束 ^ 匹配字符串的开始 $ ...
- 人人都写过的5个Bug!
大家好,我是良许. 计算机专业的小伙伴,在学校期间一定学过 C 语言.它是众多高级语言的鼻祖,深入学习这门语言会对计算机原理.操作系统.内存管理等等底层相关的知识会有更深入的了解,所以我在直播的时候, ...
- Vue项目搭建常用的配置文件,request.js和vue.config.js
request.js用来请求数据,封装的代码如下: import axios from 'axios' const request = axios.create({ timeout: 5000 }) ...
- 21.6.29 test
\(NOI\) 模拟赛 \(T1\) 正解是个题解难以理解的数论,结果是组合数相加.暴力分拿满了,尝试打了 \(20*20\) 的表,最后大概打出了个三角形的表,并且帮我找到了一些性质.\(45\)p ...
- 还在用canvas画格子吗?文字烟花效果更不错噢
大家好,我是小丞同学,一名前端爱好者 欢迎访问博主的个人网站:一口奶盖 "在人间贩卖声音 等凑够满天星辰 放烟花给你看" 上次的烟花有些许平淡,这次来放大招了,让你的名字在天空绽放 ...
- Ubuntu 16.04 curl 安装 使用
curl是利用URL语法在命令行方式显工作的开元文件传输工具. 安装 $ sudo apt install -y curl 使用 $ curl http://www.baidu.com 这是最简单的使 ...
- PHP笔记3__简易计算器
<?php header("Content-type: text/html; charset=utf-8"); error_reporting(E_ALL & ~E_ ...
- 单自由度系统中质量、阻尼和刚度变化对频率响应函数(FRF)影响图的绘制
作者:赵兵 日期:2020-02-17 目录 单自由度系统中质量.阻尼和刚度变化对频率响应函数(FRF)影响图的绘制 1. 背景 2. VISIO绘制 3. Matlab绘制 ...
- 菜鸡的Java笔记 第十六 - java 引用传递
referenceDelivery 引用传递是整个java 的精髓,也是所有初学者最难学的地方 引用的本质:同一块堆内存可以被不同的栈内存所指向 下面通过三道程序来进行引用传 ...