
Impala简介PB级大数据实时查询分析引擎
1、Impala简介
• Cloudera公司推出,提供对HDFS、Hbase数据的高性能、低延迟的交互式SQL查询功能。
• 基于Hive使用内存计算,兼顾数据仓库、具有实时、批处理、多并发等优点
• 是CDH平台首选的PB级大数据实时查询分析引擎
官网:http://www.cloudera.com/products/apache-hadoop/impala.html
http://www.impala.io/index.html
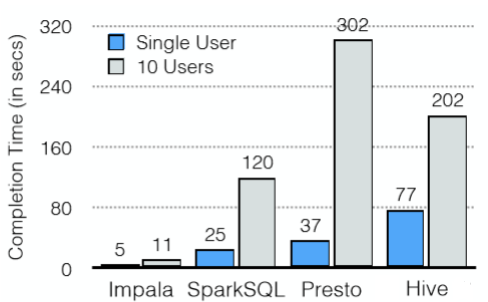
下面是在基于单用户和多用户查询的时候,不同的查询分析器所使用的时间:
2、Impala的特点
• 1、基于内存进行计算,能够对PB级数据进行交互式实时查询、分析
• 2、无需转换为MR,直接读取HDFS数据
• 3、C++编写,LLVM统一编译运行
• 4、兼容HiveSQL
• 5、具有数据仓库的特性,可对hive数据直接做数据分析
• 6、支持Data Local
• 7、支持列式存储
• 8、支持JDBC/ODBC远程访问
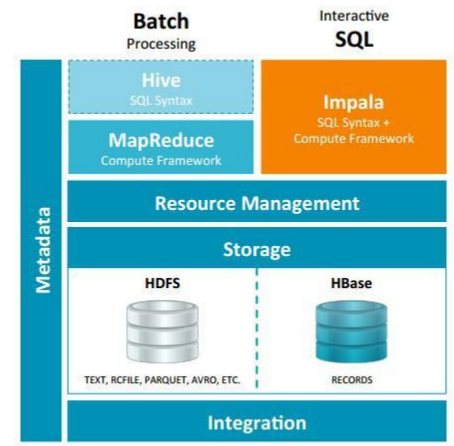 (相比于Hive,Impala不需要启动MapReduce直接同HDFS或HBase进行交互)
3、Impala 劣势
• 1、对内存依赖大
• 2、C++编写 开源?!
• 3、完全依赖于hive
• 4、实践过程中 分区超过1w 性能严重下下降
• 5、稳定性不如hive
4、Impala安装
• 安装方式:
– 1、ClouderaManager
– 2、手动安装(待续)
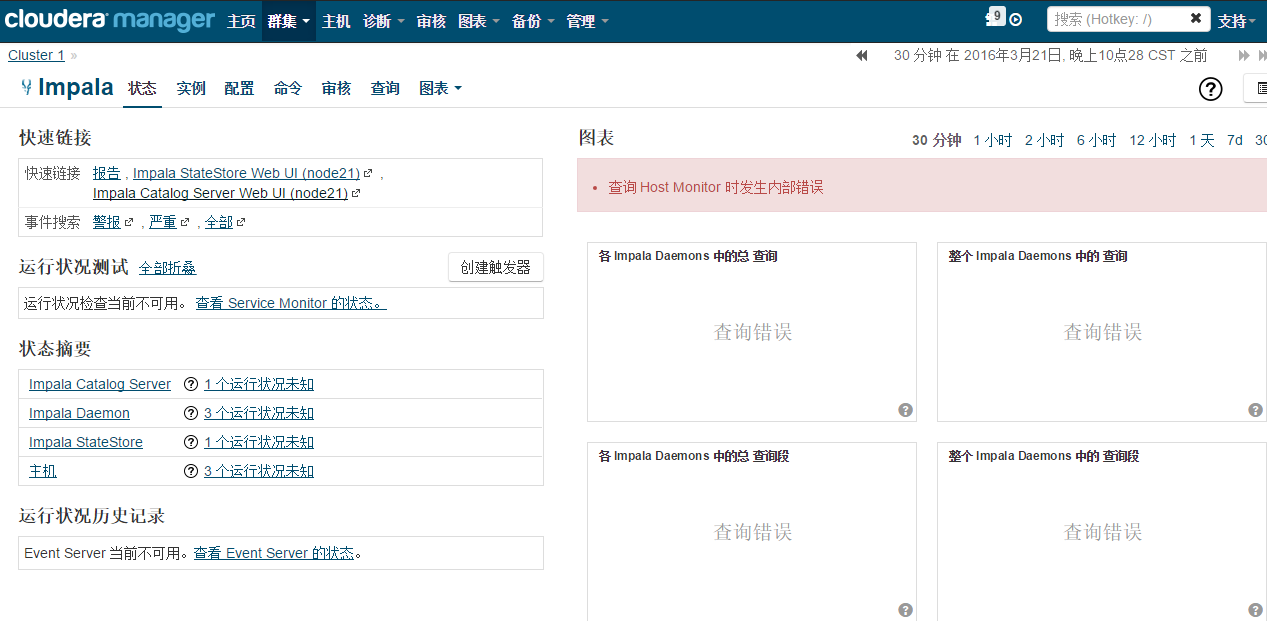
可以使用CDH安装,方便快捷,而且管理起来更加方便,下面是CDH安装以后的CDH管理界面:
5、Impala核心组件
• Statestore Daemon
• 实例*1 - statestored
– 负责收集分布在集群中各个impalad进程的资源信息、各节点健康状况,同步节点信息.
– 负责query的调度
• Catalog Daemon
• 实例*1 - catalogd
– 分发表的元数据信息到各个impalad中
– 接收来自statestore的所有请求
• Impala Daemon
• 实例*N – impalad
– 接收client、hue、jdbc或者odbc请求、Query执行并返回给中心协调节点
– 子节点上的守护进程,负责向statestore保持通信,汇报工作
6、Impala架构
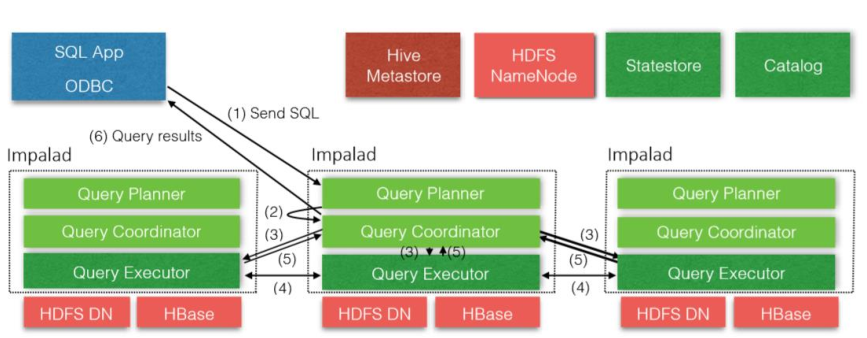
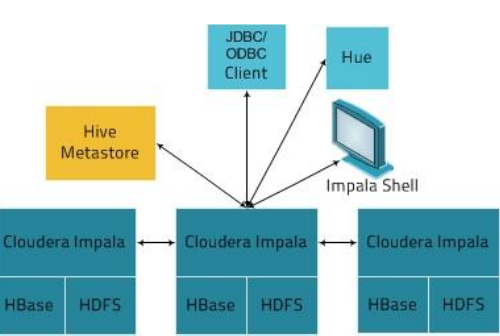
(1) 由Client发送一个执行SQL到任意一台Impalad的Query Planner
(2) 由Query Planner 把SQL发向Query Coordinator
(3) 由Query Coordinator 来调度分配任务到Impalad的所有节点
(4) 各个Impalad节点的Query Executor 进行执行SQL工作
(5) 执行SQL结束以后,将结果返回给Query Coordinator
(6) 再由Query Coordinator 将结果返回给Client
 阅读全文
Impala简介PB级大数据实时查询分析引擎的更多相关文章
- Druid:一个用于大数据实时处理的开源分布式系统——大数据实时查询和分析的高容错、高性能开源分布式系统
转自:http://www.36dsj.com/archives/28590 Druid 是一个用于大数据实时查询和分析的高容错.高性能开源分布式系统,旨在快速处理大规模的数据,并能够实现快速查询和分 ...
- 腾讯云EMR大数据实时OLAP分析案例解析
OLAP(On-Line Analytical Processing),是数据仓库系统的主要应用形式,帮助分析人员多角度分析数据,挖掘数据价值.本文基于QQ音乐海量大数据实时分析场景,通过QQ音乐与腾 ...
- 使用Oracle Stream Analytics 21步搭建大数据实时流分析平台
概要: Oracle Stream Analytics(OSA)是企业级大数据流实时分析计算平台.它可以通过使用复杂的关联模式,扩充和机器学习算法来自动处理和分析大规模实时信息.流式传输的大数据可以源 ...
- [NewLife.XCode]分表分库(百亿级大数据存储)
NewLife.XCode是一个有15年历史的开源数据中间件,支持netcore/net45/net40,由新生命团队(2002~2019)开发完成并维护至今,以下简称XCode. 整个系列教程会大量 ...
- 《深度访谈:华为开源数据格式 CarbonData 项目,实现大数据即席查询秒级响应》
深度访谈:华为开源数据格式 CarbonData 项目,实现大数据即席查询秒级响应 Tina 阅读数:146012016 年 7 月 13 日 19:00 华为宣布开源了 CarbonData ...
- 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
这个很简单,在集群机器里,选择就是了,本来自带就有Impala的. 扩展博客 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
- 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
不多说,直接上干货! Impala和Hive的关系(详解) 扩展博客 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解) 参考 horton ...
- 大数据实时计算工程师/Hadoop工程师/数据分析师职业路线图
http://edu.51cto.com/roadmap/view/id-29.html http://my.oschina.net/infiniteSpace/blog/308401 大数据实时计算 ...
- Storm 实战:构建大数据实时计算
Storm 实战:构建大数据实时计算(阿里巴巴集团技术丛书,大数据丛书.大型互联网公司大数据实时处理干货分享!来自淘宝一线技术团队的丰富实践,快速掌握Storm技术精髓!) 阿里巴巴集团数据平台事业部 ...
随机推荐
- jenkins部署记录
环境规划 主机分配 192.168.2.139 : gitlab 192.168.2.141 : jenkins 192.168.2.142 : haproxy01 192.168.2.143 :ha ...
- CentOS7下rsync服务的基本详解和使用
第1章 Rsync基本概述 1.1 什么是Rsync rsync是一款开源,快速,多功能的可实现增量的本地或远程的数据镜像同步备份的优秀工具.适用于多个平台.从软件名称可以看出来是远程同步的意思(re ...
- 企业Shell面试题及企业运维实战案例(三)
1.企业Shell面试题1:批量生成随机字符文件名案例 使用for循环在/oldboy目录下批量创建10个html文件,其中每个文件需要包含10个随机小写字母加固定字符串oldboy,名称示例如下: ...
- es6几个新增语法的使用----数组
//数组的累加方法 let arr=[1,2,3]; let sum=arr.reduce((prev,cur)=>{ return prev+cur; }) console.log(sum)/ ...
- pyqt5--学习资料
http://zetcode.com/gui/pyqt5/ http://www.thehackeruniversity.com/2014/01/23/pyqt5-beginner-tutorial/ ...
- hive 学习系列三(表格的创建create-table)
表格创建: 语法 第一种建表的形式: 说明: temporary 临时表,在当前回话内,这张表有效,当回话结束,可以理解为程序结束,则程序终止. external 外部表, hdfs 上的表的文件,并 ...
- Python自动化运维——系统性能信息模块
Infi-chu: http://www.cnblogs.com/Infi-chu/ 模块:psutil psutil是一个跨平台库,可以很轻松的为我们实现获取系统运行的进程和资源利用率等信息. 功能 ...
- python2.7练习小例子(十六)
16):题目:输入一行字符,分别统计出其中英文字母.空格.数字和其它字符的个数. 程序分析:利用 while 或 for 语句,条件为输入的字符不为 '\n'. 程序源代码: #!/u ...
- MongoDB入门---简介
最近呢,刚好有一些时间,所以就学习了一下新的数据库类型MongoDB.要想了解这个MongoDB,我们首先需要了解一个概念,那就是nosql(not only sql).一下就是官方的概念: NoSQ ...
- OrCAD把原理图中的器件添加到原理图库
1. 在使用OrCAD的时候,有时需要把别人的原理图里面的器件添加到自己的原理图库,方便以后使用,具体操作如下,依次选择Design Cache---元器件--Copy 2. 选中要存放的原理图库,鼠 ...