
利用百度文字识别API识别图像中的文字
本文将会介绍如何使用百度AI开放平台中的文字识别服务来识别图片中的文字。百度AI开放平台的访问网址为:http://ai.baidu.com/ ,为了能够使用该平台提供的AI服务,你需要事先注册一个百度账号。
创建百度AI文字识别应用
在百度AI开放平台中,登录自己的百度账号,点击“文字识别”服务中的“通用场景文字识别”,选择“创建应用”,填好应用名称,选择应用类型,填好应用描述,这样就创建好了“通用场景文字识别”服务,如下图:
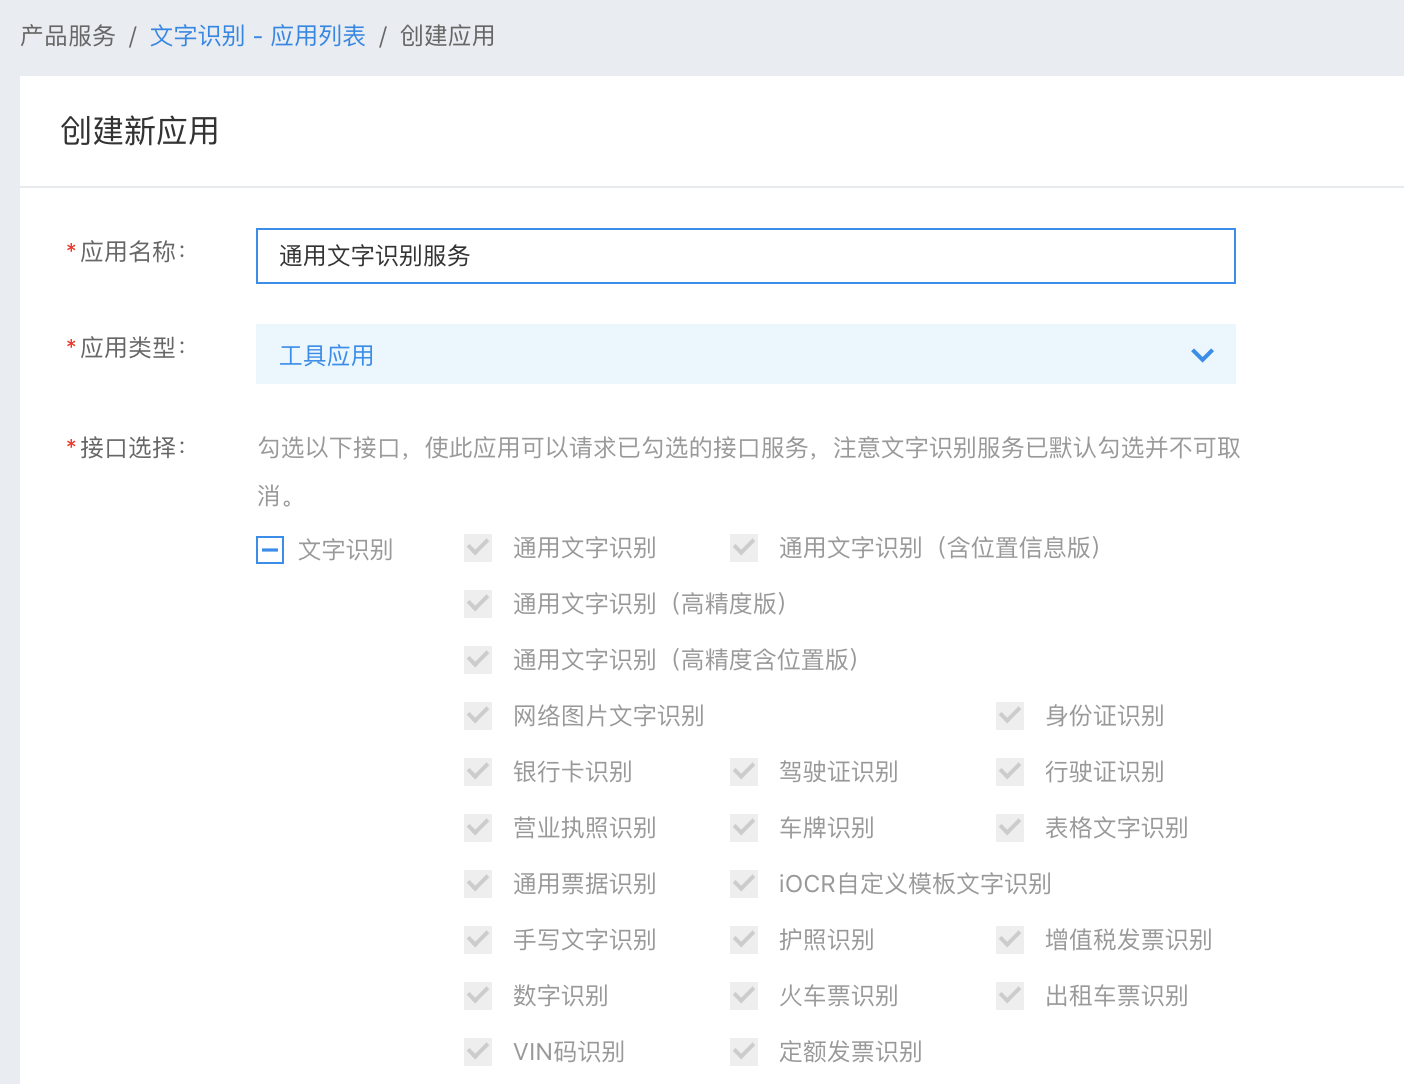
在应用列表中,能够看到自己刚刚创建好的文字识别服务了,记住,这个应用中的“AppID”,“API Key”,“Secret Key”很重要,是你这个应用的唯一识别。

OK,创建好这个应用后,我们就能使用该应用来识别图片中的文字了~
利用创建的应用来识别图片中的文字
接下来,我们将使用刚刚创建好的文字识别应用来识别图片中的文字,大致的步骤如下:
- 获取该应用的access_token;
- 利用access_token来创建HTTP请求;
- 解析请求成功后的json文件,获取识别后的结果。
具体的参考文档可以参考网址:https://ai.baidu.com/docs#/OCR-API/top, 本文将不再具体讲述。
我们需要识别的图片为含有两个汉字的图片验证码,图片名称为test.png,如下:

参考该应用的官方文档说明,我们写下如下的Python脚本,即可识别图片中的文字,完整的代码如下:
import json

import requests

import base64

import urllib.parse

APP_ID = '你的APP_ID'

API_KEY ='你的API_KEY'

SECRECT_KEY = '你的SECRECT_KEY'

# 获取token

url = 'https://aip.baidubce.com/oauth/2.0/token'

body = {'grant_type': 'client_credentials',

        'client_id': API_KEY,

        'client_secret': SECRECT_KEY

        }

req = requests.post(url=url, data=body)

token = json.loads(req.content)['access_token']

# 获取百度api识别结果

ocr_url = 'https://aip.baidubce.com/rest/2.0/ocr/v1/general_basic?access_token=%s'%token

headers = {'Content-Type': 'application/x-www-form-urlencoded'}

# 读取图片并进行base64加密

body = base64.b64encode(open('./test.png' ,'rb').read())

# 进行urlencode

data = urllib.parse.urlencode({'image': body})

# post请求

r = requests.post(url=ocr_url, headers=headers, data=data)

# 输出请求结果

print('请求码为: %s' %r.status_code)

res_words = json.loads(r.content)['words_result'][0]['words']

print('识别结果为: %s' % res_words)
输出的结果如下:
请求码为: 200

识别结果为: 高吸
可以看到,对于这张图片,百度的文字识别功能很好地识别出了图片中的文字。
利用Python的百度文字识别第三方模块来识别图片中的文字
上面我们参照了百度文字识别的官方文档来实现文字识别功能,但过程有点复杂,需要先获取access_token,再构建HTTP请求才能使用。幸运的是,在Python的第三库中,已经有了能实现该功能的第三方模块,即baidu-aip,安装方式如下:
pip install baidu-aip
利用这个第三方模块,我们能简洁快速地实现文字识别功能,示例的Python代码如下:
# 利用aip进行识别

from aip import AipOcr

APP_ID = '你的APP_ID'

API_KEY ='你的API_KEY'

SECRECT_KEY = '你的SECRECT_KEY'

client = AipOcr(APP_ID, API_KEY, SECRECT_KEY)

img = open('./test.png','rb').read()

message=client.basicGeneral(img)

res = message['words_result']

print('识别结果为: %s' % res[0]['words'])
总结
本文并没有讲述如何从AI模型来识别图片中的文字,而是利用百度AI平台中的文字识别服务来完成文字识别任务。看上去并没有什么新意,只是讲解使用使用API来识别图片中的文字罢了。
那么,本文的意义在哪?其实,在使用模型识别文字前,一个很重要的过程便于标注,标注费时费力,这时候我们借助第三方文字识别API能够减轻标注的工作量,让我们的标注量能减少点。
当然,如果你把这篇文章看作是一个学习如何利用百度文字识别API识别图像中的文字的机会,那也未尝不可!
注意:本人现已开通微信公众号: Python爬虫与算法(微信号为:easy_web_scrape), 欢迎大家关注哦~~
利用百度文字识别API识别图像中的文字的更多相关文章
- 使用 Python 识别并提取图像中的文字
1. 介绍 介绍使用 python 进行图像的文字识别,将图像中的文字提取出来,可以帮助我们完成很多有趣的事情. 2. 必备工具 tesseract-ocr 下载地址: https://github. ...
- Zybo智能小车识别图像中的文字
智能小车识别图像中的文字 [TOC] 运行平台 这次的内容是基于Xilinx公司的Zybo开发板以及其配套的Zrobot套件开发 Zybo上面的sd卡搭载了Ubuntu12.04LTS的linux版本 ...
- 利用百度接口进行人脸识别并保存人脸jpg文件
利用百度接口进行人脸识别,根据返回的人脸location用opencv切割保存. # coding : UTF-8 from aip import AipFace import cv2 import ...
- 安卓开发 利用百度识图api进行物体识别
前文 之前的随笔中,已经通过相机或相册获取到了我们想要的图片,接下来进行识图api的配置工作.我使用的是百度的api,利用python获取信息,并在MainActivity中进行调用来输出信息. 一. ...
- 利用百度AI OCR图片识别,Java实现PDF中的图片转换成文字
序言:我们在读一些PDF版书籍的时候,如果PDF中不是图片,做起读书笔记的还好:如果PDF中的是图片的话,根本无法编辑,做起笔记来,还是很痛苦的.我是遇到过了.我们搞技术的,当然得自己学着解决现在的痛 ...
- 安卓开发 利用百度识图api进行物体识别(java版)
之前的随笔中,已经实现了python版本调用api接口,之所以使用python是因为python比java要简洁. 但是我发现在使用过程中,chaquopy插件会弹出底部toast显示"un ...
- Android调用OCR识别图像中的文字
// CharacterExtractor.java // Copyright (c) 2010 William Whitney // All rights reserved. // This sof ...
- CNN如何识别一幅图像中的物体
让我们对卷积神经网络如何工作形成更好直观感受.我们先看下人怎样识别图片,然后再看 CNNs 如何用一个近似的方法来识别图片. 比如说,我们想把下面这张图片识别为金毛巡回犬. 一个需要被识别为金毛巡 ...
- 【Android】18.2 利用百度定位服务API实现位置跟踪
分类:C#.Android.VS2015: 创建日期:2016-03-04 一.简介 第3章已经介绍过百度定位SDK,这里再演示一遍其基本用法. 二.示例2-百度定位服务基本用法 运行截图 设计步骤 ...
随机推荐
- windows系统下sublime text3开发工具前端配置
1.打开https://www.sublimetext.com/3下载最新版Sublime Text 3安装. 2.打开packagecontrol安装方法按提示安装packagecontrol,或者 ...
- ORA-19625: error identifying file
问题描述:rman进行备份的时候,出现报错ORA-19625,无效的文件 1.进行数据库备份,然后就出现了报错,没有这个24号的归档日志 RMAN> run{ 2> allocate ch ...
- 关于eclipse码代码时光标自动消失要重新点击输入框的问题
前几天码代码时在两个电脑都出现了同样的问题,就是在输入的时候,输入法突然从程序框切换到某不可名状的位置,要重新点击输入框才能解决.(后发现不但是eclipse,任何带有输入框的都会出现此问题) 经排查 ...
- 手把手教你看懂并理解Arduino PID控制库——引子
介绍 本文主要依托于Brett Beauregard大神针对Arduino平台撰写的PID控制库Arduino PID Library及其对应的帮助博客Improving the Beginner’s ...
- Java开发图片浏览器--记录
效果 设计思路 需求分析 图片浏览,上/下一张,放大缩小等基本功能.可以继续拓展的功能:缩略图.旋转,画笔修改等.此外,缩放实现较为简单,所以会出现失真.设计此类软件功能可参考ACDSee或irfan ...
- 小米开源数据库<pegasus>简介
数据模型 组合键:Table + HashKey + SortKey Table实现业务数据的隔离 HashKey决定数据在那个分片 SortKey决定数据在分片内的排序 一致性协议 使用Pacifi ...
- 简单实现vue列表点击某个高亮显示
比如ul下有4个li元素. 给每个li绑定点击事件@click="select_li(index),然后这个点击时间会将一个全局变量 selectLi 赋值为 index 的值. 然后在每个 ...
- vue集成cesium,webgis平台第一步(附源码下载)
vue-cesium-platform Vue结合Cesium的web端gis平台 初步效果 笔记本性能限制,运行Cesium温度飙到70度以上.所以平时开发时先开发界面,之后加载Cesium地球 当 ...
- React-Native三种断点调试方式的流程和优缺点比较
RN的调试和web端的调试虽然相似,但是也有一些不同,下面就来比较一下三种断点调试方法的差异 总结: 感觉还是第一种好一些 1.React-Native-Debugger工具调试法 1.1 首先我们得 ...
- VS2019 开发Django(五)------createsuperuser
导航:VS2019开发Django系列 上篇我们已经把LazyOrders中用到的C#的实体转成了Django中的Entity,并且已经迁移数据库成功,那么,今天继续介绍Django中内置的数据库操作 ...