
Kafka的安装与使用(转)
9.1 Kafka 基础知识
9.1.1 消息系统
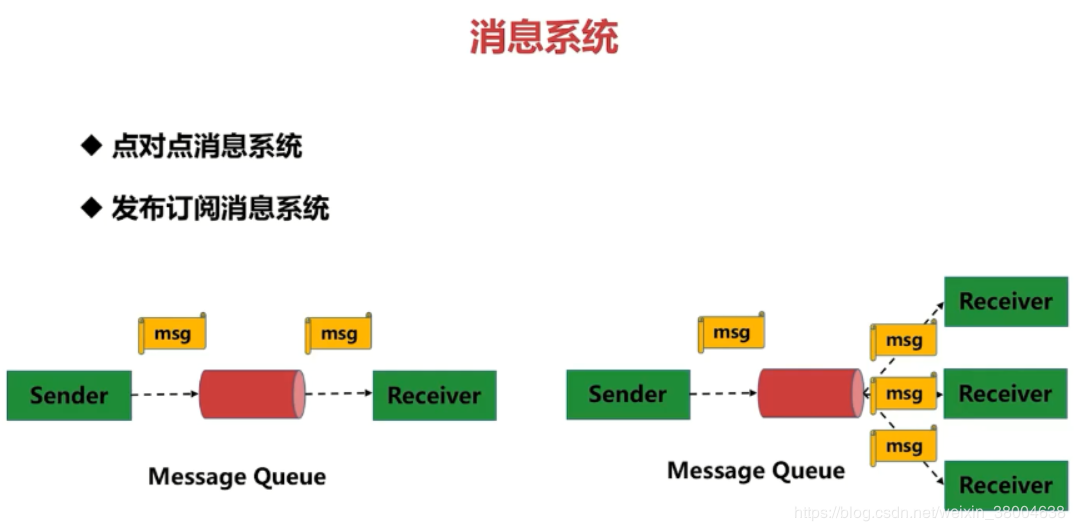
点对点消息系统:生产者发送一条消息到queue,一个queue可以有很多消费者,但是一个消息只能被一个消费者接受,当没有消费者可用时,这个消息会被保存直到有 一个可用的消费者,所以Queue实现了一个可靠的负载均衡。
发布订阅消息系统:发布者发送到topic的消息,只有订阅了topic的订阅者才会收到消息。topic实现了发布和订阅,当你发布一个消息,所有订阅这个topic的服务都能得到这个消息,所以从1到N个订阅者都能得到这个消息的拷贝。
9.1.2 kafka术语
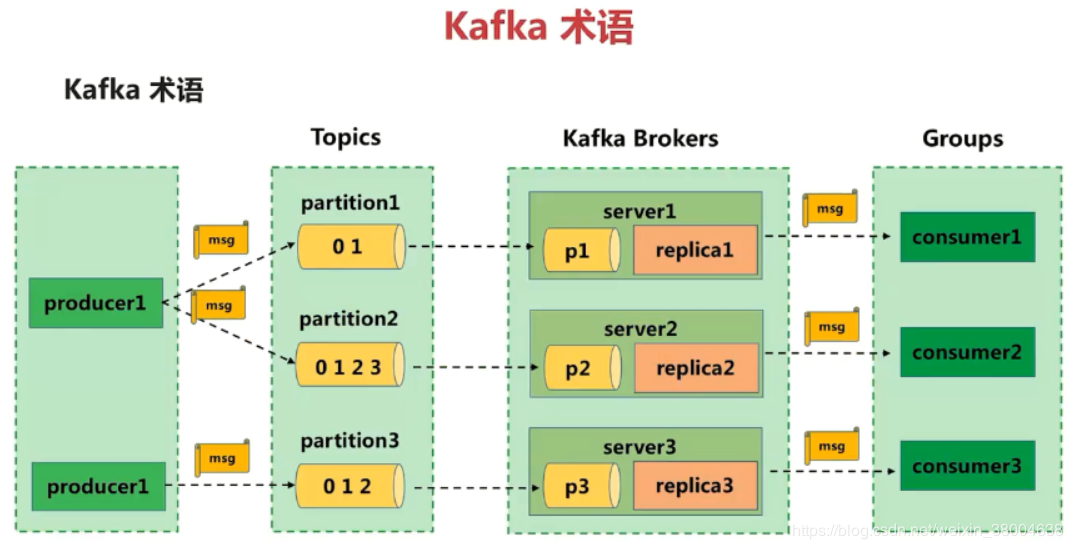
消息由producer产生,消息按照topic归类,并发送到broker中,broker中保存了一个或多个topic的消息,consumer通过订阅一组topic的消息,通过持续的poll操作从broker获取消息,并进行后续的消息处理。
Producer :消息生产者,就是向broker发指定topic消息的客户端。
Consumer :消息消费者,通过订阅一组topic的消息,从broker读取消息的客户端。
Broker :一个kafka集群包含一个或多个服务器,一台kafka服务器就是一个broker,用于保存producer发送的消息。一个broker可以容纳多个topic。
Topic :每条发送到broker的消息都有一个类别,可以理解为一个队列或者数据库的一张表。
Partition:一个topic的消息由多个partition队列存储的,一个partition队列在kafka上称为一个分区。每个partition是一个有序的队列,多个partition间则是无序的。partition中的每条消息都会被分配一个有序的id(offset)。
Offset:偏移量。kafka为每条在分区的消息保存一个偏移量offset,这也是消费者在分区的位置。kafka的存储文件都是按照offset.kafka来命名,位于2049位置的即为2048.kafka的文件。比如一个偏移量是5的消费者,表示已经消费了从0-4偏移量的消息,下一个要消费的消息的偏移量是5。
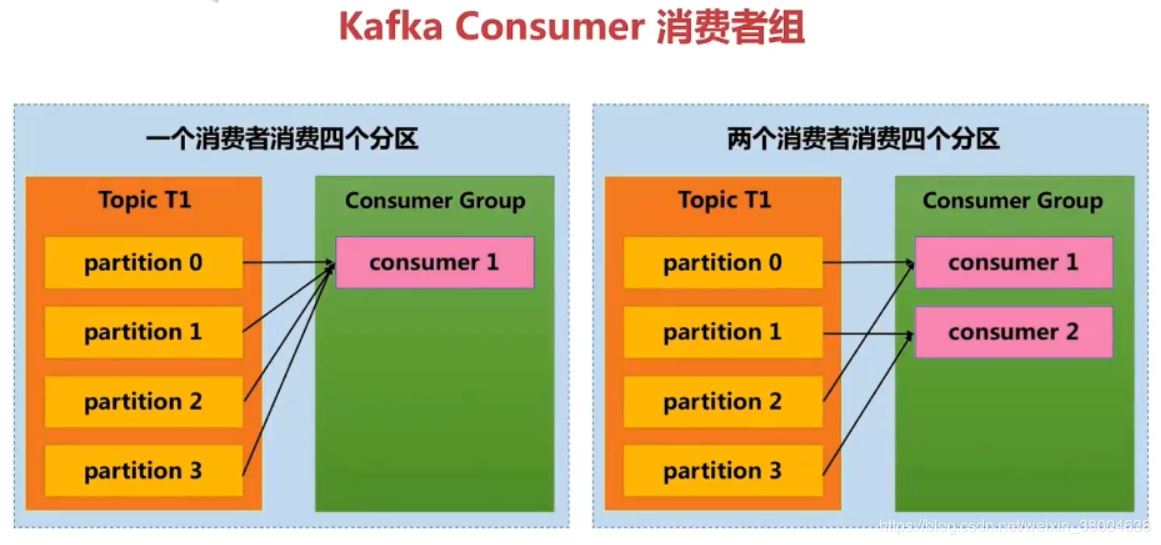
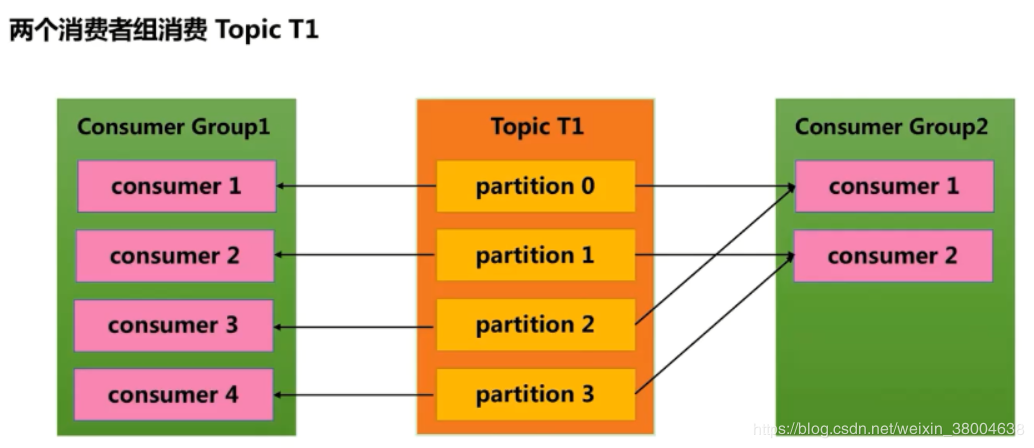
Consumer Group (CG):若干个Consumer组成的集合。这是kafka用来实现一个topic消息的广播(发给所有的consumer)和单播(发给任意一个consumer)的手段。一个topic可以有多个CG。topic的消息会复制(不是真的复制,是概念上的)到所有的CG,但每个CG只会把消息发给该CG中的一个consumer。如果需要实现广播,只要每个consumer有一个独立的CG就可以了。要实现单播只要所有的consumer在同一个CG。用CG还可以将consumer进行自由的分组而不需要多次发送消息到不同的topic。
假如一个消费者组有两个消费者,订阅了一个具有4个分区的topic的消息,那么这个消费者组的每一个消费者都会消费两个分区的消息。消费者组的成员是动态维护的,如果新增或者减少了消费者组中的消费者,那么每个消费者消费的分区的消息也会动态变化。比如原来一个消费者组有两个消费者,其中一个消费者因为故障而不能继续消费消息了,那么剩下一个消费者将会消费全部4个分区的消息。
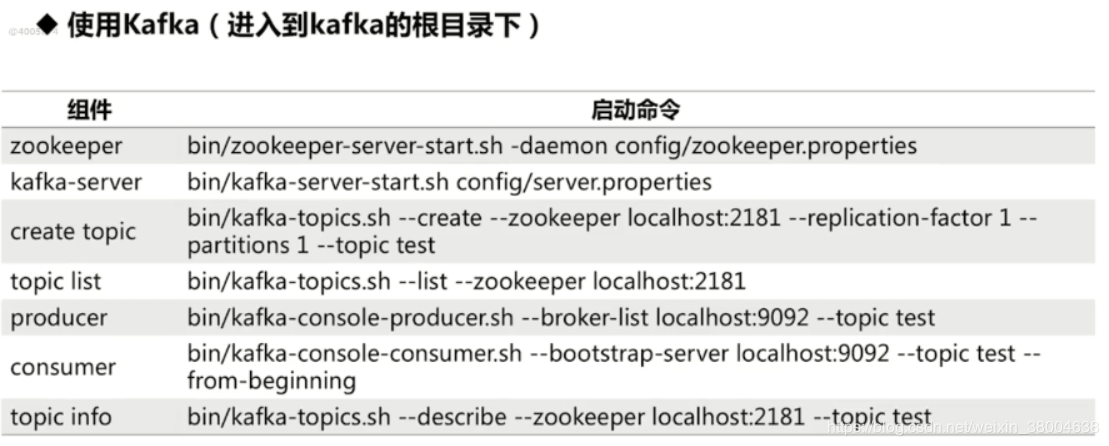
9.1.3 kafka安装和使用
在Windows安装运行Kafka:https://blog.csdn.net/weixin_38004638/article/details/91893910
9.1.4 kafka运行
一次写入,支持多个应用读取,读取信息是相同的
kafka-study.pom
<dependencies>
<dependency>
<groupId>org.apache.kafka</groupId>
<artifactId>kafka_2.12</artifactId>
<version>2.2.1</version>
</dependency>
<dependency>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-nop</artifactId>
<version>1.7.24</version>
</dependency>
</dependencies>
<build>
<plugins>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-compiler-plugin</artifactId>
<version>3.0</version>
<configuration>
<source>1.8</source>
<target>1.8</target>
<encoding>UTF-8</encoding>
</configuration>
</plugin>
</plugins>
</build>
Producer生产者
发送消息的方式,只管发送,不管结果:只调用接口发送消息到 Kafka 服务器,但不管成功写入与否。由于 Kafka 是高可用的,因此大部分情况下消息都会写入,但在异常情况下会丢消息
同步发送:调用 send() 方法返回一个 Future 对象,我们可以使用它的 get() 方法来判断消息发送成功与否
异步发送:调用 send() 时提供一个回调方法,当接收到 broker 结果后回调此方法
public class MyProducer {
private static KafkaProducer<String, String> producer;
//初始化
static {
Properties properties = new Properties();
//kafka启动,生产者建立连接broker的地址
properties.put("bootstrap.servers", "127.0.0.1:9092");
//kafka序列化方式
properties.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
properties.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
//自定义分区分配器
properties.put("partitioner.class", "com.imooc.kafka.CustomPartitioner");
producer = new KafkaProducer<>(properties);
}
/**
* 创建topic:.\bin\windows\kafka-topics.bat --create --zookeeper localhost:2181
* --replication-factor 1 --partitions 1 --topic kafka-study
* 创建消费者:.\bin\windows\kafka-console-consumer.bat --bootstrap-server localhost:9092
* --topic imooc-kafka-study --from-beginning
*/
//发送消息,发送完后不做处理
private static void sendMessageForgetResult() {
ProducerRecord<String, String> record = new ProducerRecord<>("kafka-study", "name", "ForgetResult");
producer.send(record);
producer.close();
}
//发送同步消息,获取发送的消息
private static void sendMessageSync() throws Exception {
ProducerRecord<String, String> record = new ProducerRecord<>("kafka-study", "name", "sync");
RecordMetadata result = producer.send(record).get();
System.out.println(result.topic());//imooc-kafka-study
System.out.println(result.partition());//分区为0
System.out.println(result.offset());//已发送一条消息,此时偏移量+1
producer.close();
}
/**
* 创建topic:.\bin\windows\kafka-topics.bat --create --zookeeper localhost:2181
* --replication-factor 1 --partitions 3 --topic kafka-study-x
* 创建消费者:.\bin\windows\kafka-console-consumer.bat --bootstrap-server localhost:9092
* --topic kafka-study-x --from-beginning
*/
private static void sendMessageCallback() {
ProducerRecord<String, String> record = new ProducerRecord<>("kafka-study-x", "name", "callback");
producer.send(record, new MyProducerCallback());
//发送多条消息
record = new ProducerRecord<>("kafka-study-x", "name-x", "callback");
producer.send(record, new MyProducerCallback());
producer.close();
}
//发送异步消息
//场景:每条消息发送有延迟,多条消息发送,无需同步等待,可以执行其他操作,程序会自动异步调用
private static class MyProducerCallback implements Callback {
@Override
public void onCompletion(RecordMetadata recordMetadata, Exception e) {
if (e != null) {
e.printStackTrace();
return;
}
System.out.println("*** MyProducerCallback ***");
System.out.println(recordMetadata.topic());
System.out.println(recordMetadata.partition());
System.out.println(recordMetadata.offset());
}
}
public static void main(String[] args) throws Exception {
//sendMessageForgetResult();
//sendMessageSync();
sendMessageCallback();
}
}
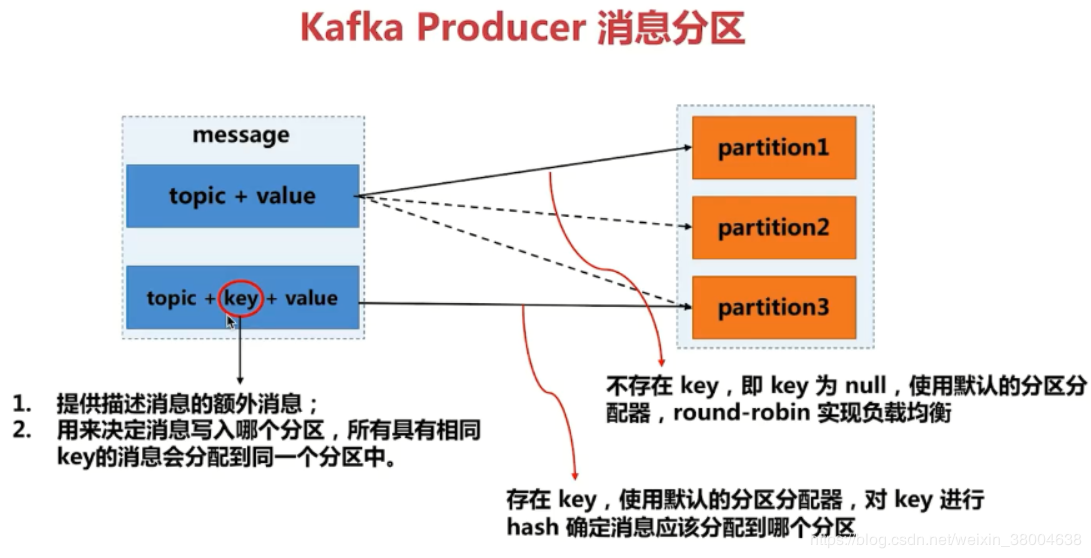
自定义分区分配器:决定消息存放在哪个分区.。默认分配器使用轮询存放,轮到已满分区将会写入失败。
public class CustomPartitioner implements Partitioner {
@Override
public int partition(String topic, Object key, byte[] keyBytes,
Object value, byte[] valueBytes, Cluster cluster) {
//获取topic所有分区
List<PartitionInfo> partitionInfos = cluster.partitionsForTopic(topic);
int numPartitions = partitionInfos.size();
//消息必须有key
if (null == keyBytes || !(key instanceof String)) {
throw new InvalidRecordException("kafka message must have key");
}
//如果只有一个分区,即0号分区
if (numPartitions == 1) {return 0;}
//如果key为name,发送至最后一个分区
if (key.equals("name")) {return numPartitions - 1;}
return Math.abs(Utils.murmur2(keyBytes)) % (numPartitions - 1);
}
@Override
public void close() {}
@Override
public void configure(Map<String, ?> map) {}
}
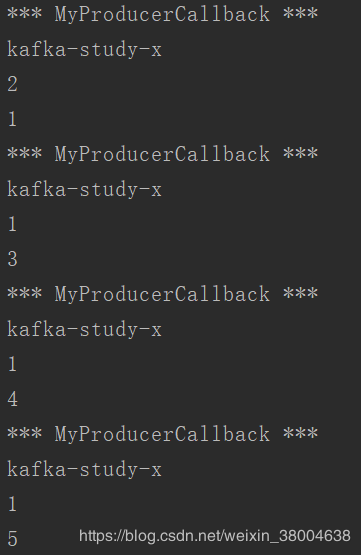
启动生产者发送消息,通过自定义分区分配器分配,查询到topic信息的value、partitioner
Kafka消费者(组)
* 自动提交位移 * 手动同步提交当前位移 * 手动异步提交当前位移 * 手动异步提交当前位移带回调 * 混合同步与异步提交位移
public class MyConsumer {
private static KafkaConsumer<String, String> consumer;
private static Properties properties;
//初始化
static {
properties = new Properties();
//建立连接broker的地址
properties.put("bootstrap.servers", "127.0.0.1:9092");
//kafka反序列化
properties.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
properties.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
//指定消费者组
properties.put("group.id", "KafkaStudy");
}
//自动提交位移:由consume自动管理提交
private static void generalConsumeMessageAutoCommit() {
//配置
properties.put("enable.auto.commit", true);
consumer = new KafkaConsumer<>(properties);
//指定topic
consumer.subscribe(Collections.singleton("kafka-study-x"));
try {
while (true) {
boolean flag = true;
//拉取信息,超时时间100ms
ConsumerRecords<String, String> records = consumer.poll(100);
//遍历打印消息
for (ConsumerRecord<String, String> record : records) {
System.out.println(String.format(
"topic = %s, partition = %s, key = %s, value = %s",
record.topic(), record.partition(), record.key(), record.value()
));
//消息发送完成
if (record.value().equals("done")) { flag = false; }
}
if (!flag) { break; }
}
} finally {
consumer.close();
}
}
//手动同步提交当前位移,根据需求提交,但容易发送阻塞,提交失败会进行重试直到抛出异常
private static void generalConsumeMessageSyncCommit() {
properties.put("auto.commit.offset", false);
consumer = new KafkaConsumer<>(properties);
consumer.subscribe(Collections.singletonList("kafka-study-x"));
while (true) {
boolean flag = true;
ConsumerRecords<String, String> records = consumer.poll(100);
for (ConsumerRecord<String, String> record : records) {
System.out.println(String.format(
"topic = %s, partition = %s, key = %s, value = %s",
record.topic(), record.partition(), record.key(), record.value()
));
if (record.value().equals("done")) { flag = false; }
}
try {
//手动同步提交
consumer.commitSync();
} catch (CommitFailedException ex) {
System.out.println("commit failed error: " + ex.getMessage());
}
if (!flag) { break; }
}
}
//手动异步提交当前位移,提交速度快,但失败不会记录
private static void generalConsumeMessageAsyncCommit() {
properties.put("auto.commit.offset", false);
consumer = new KafkaConsumer<>(properties);
consumer.subscribe(Collections.singletonList("kafka-study-x"));
while (true) {
boolean flag = true;
ConsumerRecords<String, String> records = consumer.poll(100);
for (ConsumerRecord<String, String> record : records) {
System.out.println(String.format(
"topic = %s, partition = %s, key = %s, value = %s",
record.topic(), record.partition(), record.key(), record.value()
));
if (record.value().equals("done")) { flag = false; }
}
//手动异步提交
consumer.commitAsync();
if (!flag) { break; }
}
}
//手动异步提交当前位移带回调
private static void generalConsumeMessageAsyncCommitWithCallback() {
properties.put("auto.commit.offset", false);
consumer = new KafkaConsumer<>(properties);
consumer.subscribe(Collections.singletonList("kafka-study-x"));
while (true) {
boolean flag = true;
ConsumerRecords<String, String> records = consumer.poll(100);
for (ConsumerRecord<String, String> record : records) {
System.out.println(String.format(
"topic = %s, partition = %s, key = %s, value = %s",
record.topic(), record.partition(), record.key(), record.value()
));
if (record.value().equals("done")) { flag = false; }
}
//使用java8函数式编程
consumer.commitAsync((map, e) -> {
if (e != null) {
System.out.println("commit failed for offsets: " + e.getMessage());
}
});
if (!flag) { break; }
}
}
//混合同步与异步提交位移
@SuppressWarnings("all")
private static void mixSyncAndAsyncCommit() {
properties.put("auto.commit.offset", false);
consumer = new KafkaConsumer<>(properties);
consumer.subscribe(Collections.singletonList("kafka-study-x"));
try {
while (true) {
//boolean flag = true;
ConsumerRecords<String, String> records = consumer.poll(100);
for (ConsumerRecord<String, String> record : records) {
System.out.println(String.format(
"topic = %s, partition = %s, key = %s, " + "value = %s",
record.topic(), record.partition(),
record.key(), record.value()
));
//if (record.value().equals("done")) { flag = false; }
}
//手动异步提交,保证性能
consumer.commitAsync();
//if (!flag) { break; }
}
} catch (Exception ex) {
System.out.println("commit async error: " + ex.getMessage());
} finally {
try {
//异步提交失败,再尝试手动同步提交
consumer.commitSync();
} finally {
consumer.close();
}
}
}
public static void main(String[] args) {
//自动提交位移
generalConsumeMessageAutoCommit();
//手动同步提交当前位移
//generalConsumeMessageSyncCommit();
//手动异步提交当前位移
//generalConsumeMessageAsyncCommit();
//手动异步提交当前位移带回调
//generalConsumeMessageAsyncCommitWithCallback()
//混合同步与异步提交位移
//mixSyncAndAsyncCommit();
}
}
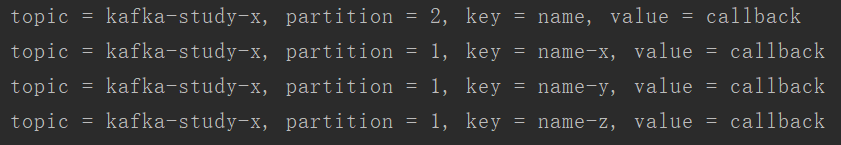
先启动消费者等待接收消息,再启动生产者发送消息,进行消费消息
————————————————
版权声明:本文为CSDN博主「陈晨辰~」的原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/weixin_38004638/article/details/91975123
Kafka的安装与使用(转)的更多相关文章
- Kafka的安装和部署及测试
1.简介 大数据分析处理平台包括数据的接入,数据的存储,数据的处理,以及后面的展示或者应用.今天我们连说一下数据的接入,数据的接入目前比较普遍的是采用kafka将前面的数据通过消息的方式,以数据流的形 ...
- Linux下Kafka单机安装配置方法(图文)
Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了普通消息系统的功能,但具有自己独特的设计.这个独特的设计是什么样的呢 介绍 Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了 ...
- kafka的安装以及基本用法
kafka的安装 kafka依赖于ZooKeeper,所以在运行kafka之前需要先部署ZooKeeper集群,ZooKeeper集群部署方式分为两种,一种是单独部署(推荐),另外一种是使用kafka ...
- kafka manager安装配置和使用
kafka manager安装配置和使用 .安装yum源 curl https://bintray.com/sbt/rpm/rpm | sudo tee /etc/yum.repos.d/bintra ...
- kafka 的安装部署
Kafka 的简介: Kafka 是一款分布式消息发布和订阅系统,具有高性能.高吞吐量的特点而被广泛应用与大数据传输场景.它是由 LinkedIn 公司开发,使用 Scala 语言编写,之后成为 Ap ...
- Kafka学习之路 (四)Kafka的安装
一.下载 下载地址: http://kafka.apache.org/downloads.html http://mirrors.hust.edu.cn/apache/ 二.安装前提(zookeepe ...
- centos php Zookeeper kafka扩展安装
如题,系统架构升级引入消息机制,php 安装还是挺麻烦的,网上各种文章有的东拼西凑这里记录下来做个备忘,有需要的同学可以自行参考安装亲测可行 1 zookeeper扩展安装 1.安装zookeeper ...
- Linux下Kafka单机安装配置方法
Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了普通消息系统的功能,但具有自己独特的设计.这个独特的设计是什么样的呢? 首先让我们看几个基本的消息系统术语: •Kafka将消息以topi ...
- Kafka Manager安装部署及使用
为了简化开发者和服务工程师维护Kafka集群的工作,yahoo构建了一个叫做Kafka管理器的基于Web工具,叫做 Kafka Manager.本文对其进行部署配置,并安装配置kafkatool对k ...
- 【kafka】安装部署kafka集群(kafka版本:kafka_2.12-2.3.0)
3.2.1 下载kafka并安装kafka_2.12-2.3.0.tgz tar -zxvf kafka_2.12-2.3.0.tgz 3.2.2 配置kafka集群 在config/server.p ...
随机推荐
- 【爬虫】随机获取UA
使用模块 fake-useragent https://github.com/hellysmile/fake-useragent 1.安装模块 2.配置 # settings.py '''下载器中间 ...
- C#和PHP加密结果一致的DES加密解密算法。php实现和c#一致的DES加密解密
DES加密算法 des对称加密,是一种比较传统的加密方式,其加密运算.解密运算使用的是同样的密钥,信息的发送者和信息的接收者在进行信息的传输与处理时,必须共同持有该密码(称为对称密码),是一种对称加密 ...
- httprunner学习6-参数化(引用外部csv数据)
前言 上一篇已经实现参数化,但是数据是放在.yml文件里面,当测试数据非常多的时候,我们希望把测试数据写到csv文件. httprunner==1.5.8 独立参数 对于已有参数列表,并且数据量比较大 ...
- 题解:UVa1025 A Spy in the Metro
原题链接 pdf 题目大意 给出一张无向图图,求该图的最小瓶颈生成树. 无向图的瓶颈生成树:无向图\(G\)的一颗瓶颈生成树是这样的一颗生成树:它最大的边权值在\(G\)的所有生成树中是最小的.瓶颈生 ...
- JSE,JEE,JME三者之间有什么区别
JAVA是一种面向对象语言由SUN公司出品 J针对不同的使用方向规划出J2SE,J2EE,J2ME三个版本 J2SE 指标准版一般用于用户学习JAVA语言的基础也是使用其他两个版本的基础主要用于编写C ...
- Error handling in Swift does not involve stack unwinding. What does it mean?
Stack unwinding is just the process of navigating up the stack looking for the handler. Wikipedia su ...
- SparkStreaming消费kafka中数据的方式
有两种:Direct直连方式.Receiver方式 1.Receiver方式: 使用kafka高层次的consumer API来实现,receiver从kafka中获取的数据都保存在spark exc ...
- CF1245F: Daniel and Spring Cleaning
CF1245F: Daniel and Spring Cleaning 题意描述: 给定区间\([L,R]\),其中 \((0\leq L,R\leq 10^9)\),问在区间内有多少数对\((x,y ...
- on bind live delegate的区别
bind()----直接绑定在元素上 live()----通过冒泡的方式绑定到元素上,更适合于列表类型的绑定,和bind()相比,支持动态数据 delegate()----精确的小范围的适用事件代理, ...
- SQL进阶-去重
一.去重的2种基本方法 1.DISTINCT ## 建表: CREATE TABLE teacher( teacher_id ), teacher_name ), id_no ) ); CREATE ...