
基础排序算法之快速排序(Quick Sort)
快速排序(Quick Sort)同样是使用了分治法的思想,相比于其他的排序方法,它所用到的空间更少,因为其可以实现原地排序。同时如果随机选取中心枢(pivot),它也是一个随机算法。最重要的是,快速排序(Quick sort)的算法分析的过程非常给力。
本文首先描述问题,再说明快速排序(Quick Sort)的基本思路并给出伪代码,之后贴出自己的Python代码。在验证完算法的正确性之后,给出如何选择好的中心枢(pivot)的方法,即随机快速排序(Randomized Quick sort),并贴代码。最后进行算法复杂度分析。
问题描述
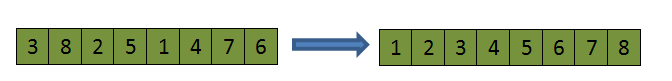
问题描述和其他排序算法一样,输入一组未排序的数组,如左边的数组,通过快速排序算法的计算,输出一组正确排序的数组,如右边的数组。
基本思路和伪代码
在给定的数组中选择一个元素作为中心枢(pivot),对数组重排列并分割(Partition),使得位于该中心枢(pivot)左边的元素都小于该元素,右边的元素都大于该元素,之后递归处理左右两组数。
这里值得注意的地方就是,每一次重排列之后,所选择的中心枢(pivot)元素所在的位置,就是最终排序结果中它应该在的位置。
 QuickSort(array A, length n)

     if n = 1 return

     p = choosePivot(A, n)

     Partition A around p

     recursively sort 1st part

     recursively sort 2st part
经过第4行的操作之后,位于左边的所有元素都小于p,而右边的数都大于p。下文中所有中心枢(pivot)元素都用p表示。
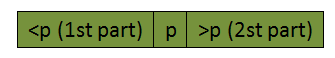
基于某一个p来对数组进行分块有两种实现的方法,第一种方法在内存在开辟新的数组,遍历元素组元素,小于p的从头插入数组,大于p的从尾部插入数组,给个例子:

而第二种方法是原地排序,比第一稍微复杂一点。假设p元素总在数组的最前端(不在最前端就让它和最前端的元素交换),将整个数组分为两部分,前半部分为已经和p比较过的元素集,后半部分为没有和p比较过的元素集。其中前半部分又分为小于p和大于p两部分。如图:
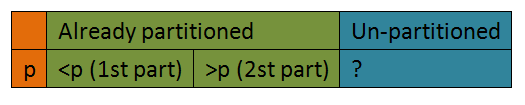
那么只要需要两个标记值i和j就可以所有部分分割开。i 标记小于p部分末端元素,j标记大于p部分的末端元素。如下例:
分割(Partition)的伪代码:
Partition(A, l, r)       [input=A[l.......r]]

    p=A[l]

    i=l+1

    for j=l+1 to r

        if A[j]<p

            swap A[i] and A[j]

            i=i+1

    swap A[l] and A[i-1]
假设处理的数组长度为N,从伪代码中可以比较容易算出,Partition的时间复杂度为O(N),而且也实现了原地排序。
Python代码
Pivot选取首元素的实现
 import random

 def quick_sort(datalist,l,r):

     if l<r-1:

         q=partition_first(datalist,l,r)

         datalist=quick_sort(datalist,l,q)

         datalist=quick_sort(datalist,q+1,r)

         return datalist

     else:

         return datalist

 def partition_first(datalist,l,r):

     p=datalist[l]

     i=l+1

     for j in range(l+1,r):

         if datalist[j]<p:

             datalist[i],datalist[j]=datalist[j],datalist[i]

             i=i+1

     datalist[l],datalist[i-1]=datalist[i-1],datalist[l]

     return i-1
验证算法的正确性
用数学归纳法来检验算法的正确性:
P(N)=快速排序(Quick sort)正确排序长度为N的数组。
Claim:无论选择什么p,在N>=1情况下,P(N)总能正确。
证明:
- 第一步:对于N=1时,返回该值。第一步完成。
- 第二步:第二步中只需要证明对于固定的n,如果∀k<n时,P(k)成立,那么P(n)也成立。
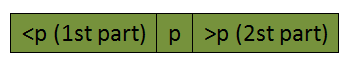
- 快速排序基于p进行分割数组时候,p在此次partition中之后,它所在所在的位置,就是最终排序结果中它应该在的位置。如上图所示,k1为1st part的数组长度,k2为2st part的数组长度。根据前面的假设∀k<n都递归成立,所以经过递归之后,整个数组正确排序。(QED!)
选择好的p值(随机快速排序)
首先先看两个例子:
情况1:对于已经排序好的一列数组,每次p值都选择第一个元素,那么算法的运行时间是多少?(n²)
情况2:对于已经排序号的一列数组,每次p值刚刚好是该数组元素的中位数,那么算法的运行时间是多少?Θ(nlgn)
可以看出,算法的性能取决于p值的选取,直觉上,选取随机的p值可以让算法有比较好的表现(这里我自己也没有完全想明白。)。后续的证明可以得出算法的平均时间复杂度为O(nlgn)。
Python代码
随机快速排序 (Randomized Quick sort)的实现
 import random

 def partition_random(datalist,l,r):

     index=random.randint(l,r-1)

     datalist[l],datalist[index]=datalist[index],datalist[l]

     p=datalist[l]

     i=l+1

     for j in range(l+1,r):

         if datalist[j]<p:

             datalist[i],datalist[j]=datalist[j],datalist[i]

             i=i+1

     datalist[l],datalist[i-1]=datalist[i-1],datalist[l]

     return i-1
算法分析
首先,我们先有如下定义:
- 输入数组的长度为定值N;
样本空间(Sample Space) Ω为在快速排序中选择中心枢(pivot)元素的所有可能性集合,其中每一个可能性其实就是一个p值的序列。
- 定义一个随即变量(Random Variable) C:对于∀σ∈Ω,C(σ)为在某个可能的p值序列,即某一σ情况下,输入元素相互比较的总次数。
为什么要设置这样一个随机变量?因为算法的运行时间其实主要取决于Partition函数中元素间比较的次数。所以要计算出快速排序(Quick sort)的时间复杂度,也就是要算出该随机变量C的期望值E(C)。
我们假设zi在一组数中,为第i小的数,如下图所示
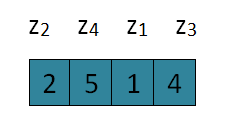
我们令xij为在某一个p值序列下,zi和zj相互比较的次数之和。那么在执行快速排序(Quick sort)的时候,任意两个元素的比较次数(xij)为多少次?0或1。因为任意两个元素能够比较的前提必须是其中某一个元素被选为中心轴元素(pivot)。不管是两个元素位于p值的同边或异边都将不会在发生比较事件(Event)。
因为 C(σ)=所有输入元素相互比较的次数;xij(σ)=任意两个元素相互比较的次数
所以 
根据期望的线性特性:
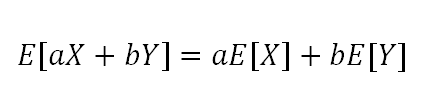 得出:
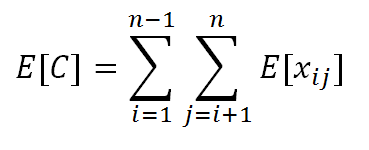
因为:
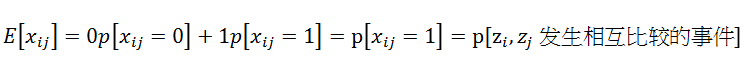
假定i<j,p[zi,zj发生相互比较的事件]=2/(j-i+1)。(之前已经说过两个数发生比较事件的情况只会在这两个数被选为pivot的时候发生,所以概率为头尾选中的次数除以i,j之间元素的个数)
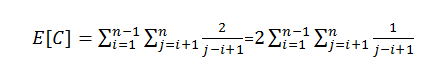
对于i值而言,并不会超过n种情况,而对于某一固定的i值,有
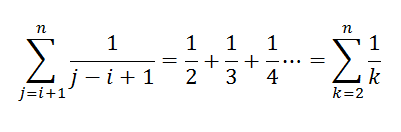
所以:
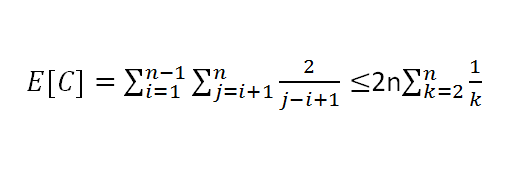
可以看出,后半项是一个调和级数,所以最后:
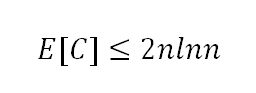 E[C]=O(nlgn) QED!
参考:算法导论以及Tim Roughgarden的讲义
基础排序算法之快速排序(Quick Sort)的更多相关文章
- Java中的经典算法之快速排序(Quick Sort)
Java中的经典算法之快速排序(Quick Sort) 快速排序的思想 基本思想是:通过一趟排序将要排序的数据分割成独立的两部分,其中一部分的所有数据都比另外一部分的所有数据都要小, 然后再按此方法对 ...
- 基础算法之快速排序Quick Sort
原理 快速排序(Quicksort)是对冒泡排序的一种改进. 从数列中挑出一个元素,称为"基准"(pivot); 排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的 ...
- [算法] 快速排序 Quick Sort
快速排序(Quick Sort)使用分治法策略. 它的基本思想是:选择一个基准数,通过一趟排序将要排序的数据分割成独立的两部分:其中一部分的所有数据都比另外一部分的所有数据都要小.然后,再按此方法对这 ...
- 6种基础排序算法java源码+图文解析[面试宝典]
一.概述 作为一个合格的程序员,算法是必备技能,特此总结6大基础算法.java版强烈推荐<算法第四版>非常适合入手,所有算法网上可以找到源码下载. PS:本文讲解算法分三步:1.思想2.图 ...
- 十大基础排序算法[java源码+动静双图解析+性能分析]
一.概述 作为一个合格的程序员,算法是必备技能,特此总结十大基础排序算法.java版源码实现,强烈推荐<算法第四版>非常适合入手,所有算法网上可以找到源码下载. PS:本文讲解算法分三步: ...
- Java面试宝典系列之基础排序算法
本文就是介绍一些常见的排序算法.排序是一个非常常见的应用场景,很多时候,我们需要根据自己需要排序的数据类型,来自定义排序算法,但是,在这里,我们只介绍这些基础排序算法,包括:插入排序.选择排序.冒泡排 ...
- Java基础系列--基础排序算法
原创作品,可以转载,但是请标注出处地址:https://www.cnblogs.com/V1haoge/p/9082138.html 一.概述 基础排序算法包括:桶排序.冒泡排序.选择排序.插入排序等 ...
- php四种基础排序算法的运行时间比较
/** * php四种基础排序算法的运行时间比较 * @authors Jesse (jesse152@163.com) * @date 2016-08-11 07:12:14 */ //冒泡排序法 ...
- Python之排序算法:快速排序与冒泡排序
Python之排序算法:快速排序与冒泡排序 转载请注明源地址:http://www.cnblogs.com/funnyzpc/p/7828610.html 入坑(简称IT)这一行也有些年头了,但自老师 ...
随机推荐
- C#当中的多线程_线程同步
第2章 线程同步 原来以为线程同步就是lock,monitor等呢,看了第二章真是大开眼界啊! 第一章中我们遇到了一个叫做竞争条件的问题.引起的原因是没有进行正确的线程同步.当一个线程在执行操作时候, ...
- Linked Server for SQL Server 2012(x64) to Oracle Database 12c(x64)
因为把两台数据库装了同一台机机器上,所以没有安装oracle Client的部分,Oracle部分使用netca创建的Net Service Name,使用tnsping以及登入方式的确认用户权限的以 ...
- while loading persisted sessions 异常解决方法
一直用tomcat一段时间都正常无事,最近一次启动tomcat就发生以下异常: 严重: IOException while loading persisted sessions: java.io.EO ...
- cocos2dx系列笔记(1)- windows环境配置前篇
cocos2dx升级之旅,请多指教~ 本篇是本人搭建cocos2dx-Windows 64位环境的配置说明,仅供参考. 开发准备 搭建环境肯定需要准备好所有工具,只有把工具都准备好了,才能撸起袖子干活 ...
- ios专题 - GCD(2)
何为Dispatch Sources 简单来说,dispatch source是一个监视某些类型事件的对象.当这些事件发生时,它自动将一个block放入一个dispatch queue的执行例程中. ...
- JSP三个指令及9个内置对象
注:本文编写方便自己以后用到时查阅 三大指令:include. page.taglib include指令: 作用: 在当前页面用于包含其他页面 语法: <%@include file=&qu ...
- 问题:Maven: missing net.sf.json-lib
问题:Maven: missing net.sf.json-lib 解决: pom.xml里加入json-lib依赖,注意要添加classifier一行,如下: 这里maven地址:http://re ...
- 问题:Bringing up interface eth0: Device eth0 does not seem to be present,delaying initialization. [FAILED]—— 找不到网卡。
克隆虚拟机的时候或其他情况出现以下问题(命令service network restart): Bringing up interface eth0: Device eth0 does not ...
- js 之 json
/*JSON语法数据在名称/值对中数据由逗号分隔花括号保存对象方括号保存数组 JSON 数据的书写格式是:名称/值对名称/值对包括字段名称(在双引号中),后面写一个冒号,然后是值;如"myw ...
- python中跟字符串相关的一些操作
公司让用python自动生成代码,以前没看过python.所以匆匆的看了两天python就连猜带蒙就上马开干了..因此好多操作可能看的时候看懂了,用的时候知道有这么个东西,具体用法就忘记了..用到了就 ...