
Python encode和decode
今天在写一个StringIO.write(int)示例时思维那么一发散就拐到了字符集的问题上,顺手搜索一发,除了极少数以外,绝大多数中文博客都解释的惨不忍睹,再鉴于被此问题在oracle的字符集体系中蹂躏过,因此在过往笔记的基础上增删了几个示例贴出来。
Python2:
首先清楚两个Python 2中的概念:str和unicode 这是python2中的两种用于表示文本的类型,一般来说你直接打出的字符都属于前者,加了u前缀的字符则属于后者。
str is text representation in bytes, unicode is text representation in characters.
此观点来自stackoverflow,是得票最多的一个回答,也是我认为最好的一个,但是从我个人的角度来看这个表述依然不足,最适合的表述应当是:
str is text representation in bytes, unicode is text representation in unicode characters(or unicode bytes).
貌似没多大区别......可能会被人打,但我的意思是python2里的unicode是字符和编码绑定的,只要是unicode类型那么他的编码和字符都已经固定了,但是str类型却只有编码,只有最初打出它的人才知道他的字符是什么(或者说才能通过适当的字符集解码为人眼可懂的字符)。
Python2里的str是十六进制表示的二进制编码,unicode是一个字符:

通俗点来说就是Python2里的str类型是一堆二进制编码,如果不知道是什么字符集那么你除了一堆十六进制

数什么都看不出来(当然平时你使用的工具都是能看到的,因为工具已经做了转码),通过decode可以将其按固定的字符集解码,生成unicode字符。

例如下例(python2环境下的windows cmd窗口):

>>> a='你好'

>>> a.decode('utf-8')

Traceback (most recent call last):

  File "<stdin>", line 1, in <module>

  File "C:\Python27\lib\encodings\utf_8.py", line 16, in decode

    return codecs.utf_8_decode(input, errors, True)

UnicodeDecodeError: 'utf8' codec can't decode byte 0xc4 in position 0: invalid continuation byte

错误的原因是这里的“你好”字符是cp936编码(相当于gbk),utf-8属于非ANSI体系的编码,“你好”的gbk二进制码不符合unicode体系的编码规则因此报错。

>>> print a.decode('gbk'),type(a.decode('gbk'))

你好 <type 'unicode'>

这样就可以啦,既然a是gbk编码的str那么按gbk进行decode解码,自然能得到unicode的你好字符。
decode: str to unicode,decode的输入必须是str类型,输出一定是unicode类型
str.decode(encoding='UTF-8',errors='strict')
encode: unicode to str,encode的输入必须是unicode类型,输出一定是str类型
unicode_char.encode(encoding='gbk',errors='strict')
Python3:
在Python3中str调用decode()方法会遇到: AttributeError: 'str' object has no attribute 'decode' .
why?
这是因为python3中表示文本的只有一种类型了,那就是str,你以为这是python2里的那个str吗?No! 这个str是python2中的unicode类型......
那么原来的str哪里去了?被命名为bytes类型了,decode方法也随之给了bytes类型,encode给了str类型。
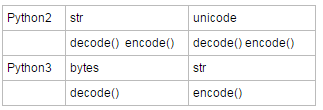
这样做的好处是:
在Python2中str和unicode都有decode,encode两种方法,但是字符集参数不设置正确的话,函数经常报错,文本能否正确流通取决于大家是否清楚输入编码的字符集,这对于全球化的网站来说是个巨坑,而在Python3中无论你输入什么字符,统一都是str类型的(也就是python2里的unicode类型),通过bytes和str类型的分离将decode,encode这两种方法分离,encode函数不会出错,因为编码与字符集是绑定的,你可以随意将unicode字符转化为任意ANSI体系字符集的bytes类型,此时在已知ANSI字符集的情况下,你对bytes类型的decode转码一定不会出错。通过这种方式就避免了python2中输入str类型带来的编码混乱问题。
[root@python ~]# python3

Python 3.6.5 (default, Apr  9 2018, 17:15:34)

[GCC 4.4.7 20120313 (Red Hat 4.4.7-4)] on linux

Type "help", "copyright", "credits" or "license" for more information.

>>> a='你好'

>>> type(a)

<class 'str'>

>>> a.encode('gbk')

b'\xc4\xe3\xba\xc3'

>>> type(a.encode('gbk'))

<class 'bytes'>

通过encode方式我们可以把unicode字符转为任意字符集的bytes类型,这种bytes类型可以通过decode()来重新转为unicode。
使用相似的观点来表述Python3中的bytes和str的区别就是:
bytes is text representation in bytes only if you know the charset, str is text representation in unicode characters(or unicode bytes).
Python encode和decode的更多相关文章
- python encode和decode函数说明【转载】
python encode和decode函数说明 字符串编码常用类型:utf-8,gb2312,cp936,gbk等. python中,我们使用decode()和encode()来进行解码和编码 在p ...
- python encode和decode函数说明
字符串编码常用类型:utf-8,gb2312,cp936,gbk等. Python中,我们使用decode()和encode()来进行解码和编码 在python中,使用unicode类型作为编码的基础 ...
- 【python】python新手必碰到的问题---encode与decode,中文乱码[转]
转自:http://blog.csdn.net/a921800467b/article/details/8579510 为什么会报错“UnicodeEncodeError:'ascii' codec ...
- 【python】浅谈encode和decode
对于encode和decode,笔者也是根据自己的理解,有不对的地方还请多多指点. 编码的理解: 1.编码:utf-8,utf-16,gbk,gb2312,gb18030等,编码为了便于理解,可以把它 ...
- python的str,unicode对象的encode和decode方法
python的str,unicode对象的encode和decode方法 python中的str对象其实就是"8-bit string" ,字节字符串,本质上类似java中的byt ...
- Python字符串的encode与decode研究心得——解决乱码问题
转~Python字符串的encode与decode研究心得——解决乱码问题 为什么Python使用过程中会出现各式各样的乱码问题,明明是中文字符却显示成“/xe4/xb8/xad/xe6/x96/x8 ...
- 【Python】关于decode和encode
#-*-coding:utf-8 import sys ''' *首先要搞清楚,字符串在Python内部的表示是unicode编码,因此,在做编码转换时,通常需要以unicode作为中间编码, 即先将 ...
- Python 关于 encode与decode 中文乱码问题
字符串在Python内部的表示是unicode编码,因此,在做编码转换时,通常需要以unicode作为中间编码,即先将其他编码的字符串解码(decode)成unicode,再从unicode编码(en ...
- [转]python新手必碰到的问题---encode与decode,中文乱码--转载
edu.codepub.com/2009/1029/17037.php 这个问题在python3.0里已经解决了. 这有篇很好的文章,可以明白这个问题: 为什么会报错“UnicodeEncodeErr ...
随机推荐
- 外呼系统APP外呼软件手机电销软件拨号销售软件功能设计
外呼系统APP外呼软件 1 系统概述 该软件系统设计功能主要为贷款.投资.资产管理等金融中介公司提供方便快捷的线上管理各类资源的一款应用软件工具. 可根据不同职位的账号登录APP来管理电话营销.客户签 ...
- psql 关于主键自增的问题
在psql中往往我们需要设置一个自增的主键id字段,psql中不像SQL Server那样点选 打钩傻瓜式就能设置好的,是需要创建序列的:CREATE SEQUENCE,关键字SEQUENCE. 我们 ...
- JNA 备注
最近写JNA调用DLL的代码比较多.应该这样说,C的精华在于对指针的灵活运用,而用JNA调用C/C++最痛苦的也在于此.你不知道该用什么样的方式去对应C/C++的方法,特别是遇到指针.结构体指针.指针 ...
- nginx部署静态网站
实验环境 服务器:centos7.5 1核1G Nginx版本:nginx-1.14.2 主题 部署静态文件 根据不同url请求路径,定向到不同的系统文件夹 部署静态文件 假设nginx安装在“/us ...
- 自己整理的所有java知识点(不断迭代中)
1. 自己整理的所有java知识点(不断迭代中) 画图工具注册 https://www.processon.com/i/599d35fae4b00d97d7f9bb17 1.1. Java整体知识架构 ...
- 合肥.NET技术社区首次线下聚会全程回顾【多图】
2019年3月16日对于合肥.NET来说是一个特别的日子,因为这是合肥.NET技术社区首次非正式线下聚会!这次聚会受场地限制(毕竟是聚餐的形式),即使换成了小椅子后,最多也只能容纳24个人,所以还有一 ...
- 【朝花夕拾】四大组件之(二)Service篇
一.Service是什么 对于这个问题,想必大家都能说出一二,如“它是四大组件之一”.“在后台处理一些操作”等.咱们这里看看官方文档中的描述,官方语言一般都是准确且言简意赅的,这里可以体验一下其风格. ...
- 【Android Studio安装部署系列】十六、Android studio在layout目录下新建子目录
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 一般用于分类显示不同模块的layout布局文件. 在res/layout文件夹下创建子目录 res/layout鼠标右键——New— ...
- spring里的三大拦截器
Filter 新建 TimeFilter @Component public class TimeFilter implements Filter { @Override public void in ...
- .net4.5部署到docker容器
.net4.5部署到docker容器 部署到windows容器 部署到linux容器 部署到windows容器 由于.net本身就是运行在windows平台的,所以它与windows容器也是更加适合, ...