
将爬取的数据保存到mysql中
为了把数据保存到mysql费了很多周折,早上再来折腾,终于折腾好了
安装数据库
1、pip install pymysql(根据版本来装)
2、创建数据
打开终端 键入mysql -u root -p 回车输入密码
create database scrapy (我新建的数据库名称为scrapy)
3、创建表
use scrapy;
create table xiaohua (name varchar(200) ,url varchar(100));
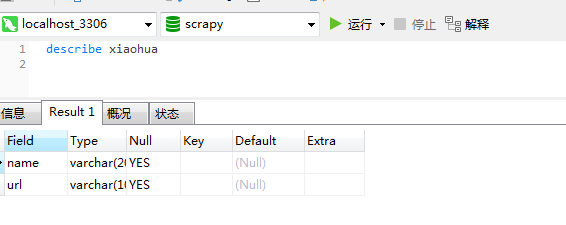
数据库部分就酱紫啦
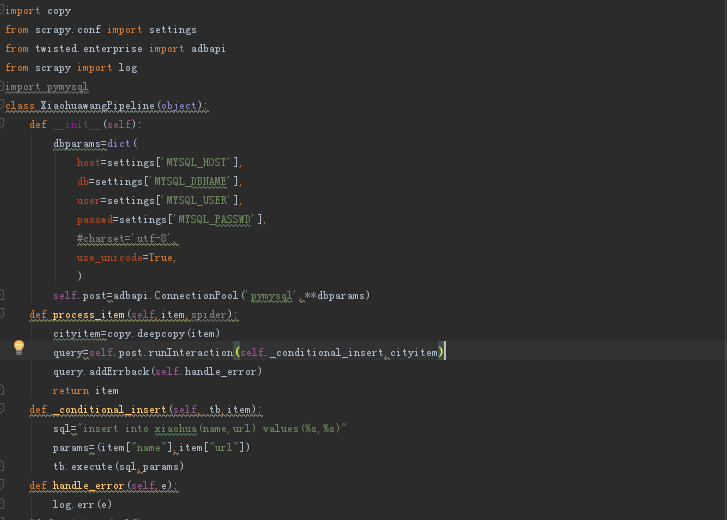
4、编写pipeline
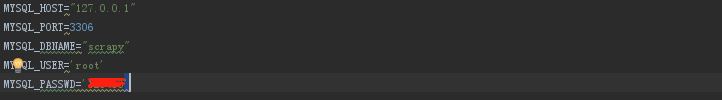
5、编写setting
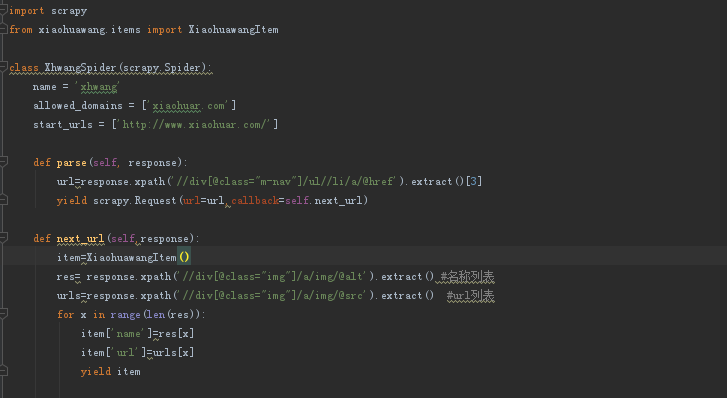
6、编写spider文件
7、爬取数据保存到mysql
scrapy crawl xhwang
之前报错为2018-10-18 09:05:50 [scrapy.log] ERROR: (1241, 'Operand should contain 1 column(s)')
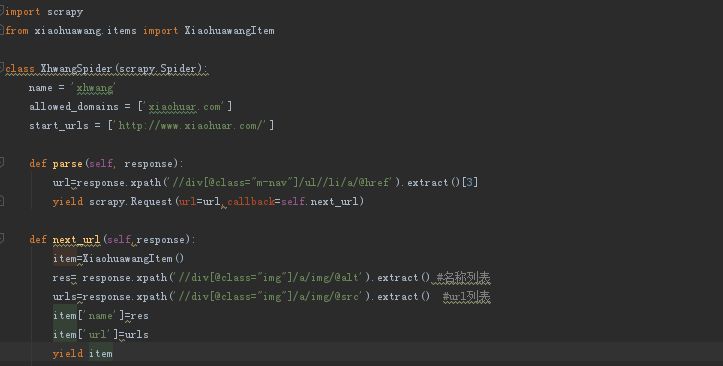
因为我的spider代码中是这样
附一张网上找到的答案
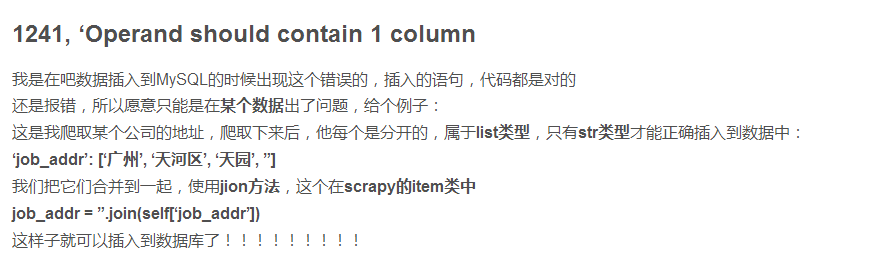
错误原因:item中的结果为{'name':[xxx,xxxx,xxxx,xxx,xxxxxxx,xxxxx],'url':[yyy,yyy,yy,y,yy,y,y,y,y,]},这种类型的数据
更正为6下面代码后出现如下会有重复

然后又查了下原因终于解决问题之所在
在图上可以看出,爬取的数据结果是没有错的,但是在保存数据的时候出错了,出现重复数据。那为什么会造成这种结果呢?
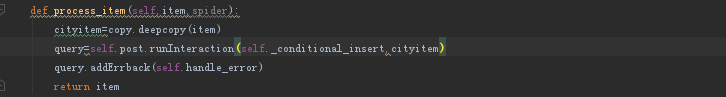
其原因是由于spider的速率比较快,scrapy操作数据库相对较慢,导致pipeline中的方法调用较慢,当一个变量正在处理的时候
一个新的变量过来,之前的变量值就会被覆盖了,解决方法是对变量进行保存,在保存的变量进行操作,通过互斥确保变量不被修改。
在pipeline中修改如下代码
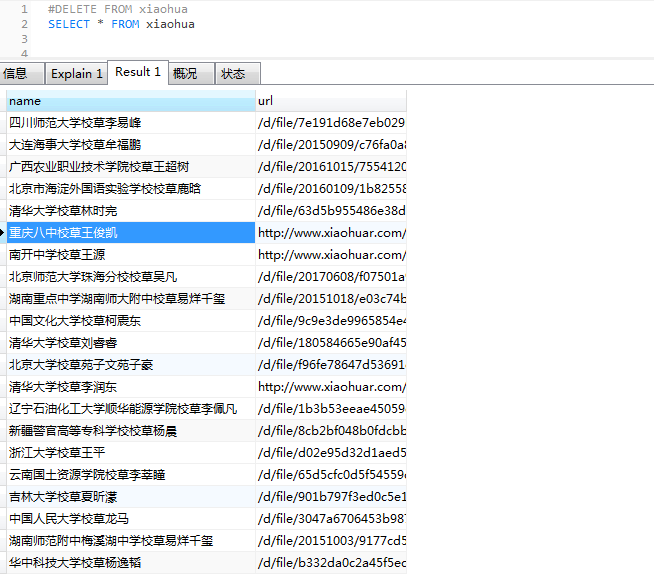
完成以上设定再来爬取,OK 大功告成(截取部分)
将爬取的数据保存到mysql中的更多相关文章
- 1.scrapy爬取的数据保存到es中
先建立es的mapping,也就是建立在es中建立一个空的Index,代码如下:执行后就会在es建lagou 这个index. from datetime import datetime fr ...
- 使用scrapy爬取的数据保存到CSV文件中,不使用命令
pipelines.py文件中 import codecs import csv # 保存到CSV文件中 class CsvPipeline(object): def __init__(self): ...
- 顺企网 爬取16W数据保存到Mongodb
import requests from bs4 import BeautifulSoup import pymongo from multiprocessing.dummy import Pool ...
- Asp.net Session 保存到MySql中
一 网站项目引入"mysql.web.dll" 二 web.config配置中添加mysql数据库连接字符串 <connectionStrings> <remov ...
- Python scrapy爬虫数据保存到MySQL数据库
除将爬取到的信息写入文件中之外,程序也可通过修改 Pipeline 文件将数据保存到数据库中.为了使用数据库来保存爬取到的信息,在 MySQL 的 python 数据库中执行如下 SQL 语句来创建 ...
- c# 抓取和解析网页,并将table数据保存到datatable中(其他格式也可以,自己去修改)
使用HtmlAgilityPack 基础请参考这篇博客:https://www.cnblogs.com/fishyues/p/10232822.html 下面是根据抓取的页面string 来解析并保存 ...
- Excel文件数据保存到SQL中
1.获取DataTable /// <summary> /// 查询Excel文件中的数据 /// </summary> /// <param name="st ...
- Redis使用场景一,查询出的数据保存到Redis中,下次查询的时候直接从Redis中拿到数据。不用和数据库进行交互。
maven使用: <!--redis jar包--> <dependency> <groupId>redis.clients</groupId> < ...
- python之scrapy爬取数据保存到mysql数据库
1.创建工程 scrapy startproject tencent 2.创建项目 scrapy genspider mahuateng 3.既然保存到数据库,自然要安装pymsql pip inst ...
随机推荐
- php 判断客户端是否为手机端访问
function is_mobile_request() { $_SERVER['ALL_HTTP'] = isset($_SERVER['ALL_HTTP'])?$_SERVER['ALL_HTTP ...
- android 代码混淆示例
参考其它资料为项目代码做了一下混淆 项目中使用了 slidingmenu actionbarsherlock fastjson volley httpclient 等第三方库, 并使用了 ...
- 从零开始学 Web 之 HTML5(一)HTML5概述,语义化标签
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- 从零开始学 Web 之 HTML5(三)网络监听,全屏,文件读取,地理定位接口,应用程序缓存
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- Mysql 5.7 基于组复制(MySQL Group Replication) - 运维小结
之前介绍了Mysq主从同步的异步复制(默认模式).半同步复制.基于GTID复制.基于组提交和并行复制 (解决同步延迟),下面简单说下Mysql基于组复制(MySQL Group Replication ...
- 使用go语言编写IOS和Android程序
go语言目前已可以用来开发android和ios手机app.相关资料: 1.IOS https://groups.google.com/forum/?utm_medium=email&utm_ ...
- R语言实战(四)—— 基本数据管理
一.基础操作 1.根据数据信息,创建数据框 > manager <- c(1,2,3,4,5) > date <- c("10/24/08","1 ...
- webpack打包去除map文件及其他一些配置
一.vue-cli(3.x)搭建的项目,webpack(3.x)打包时,生成的map文件很大,目前又不知道是干嘛用的,所以就直接去掉了. 方法: 修改sourceMap配置成为false. 1:在bu ...
- elasticsearch6.7 05. Document APIs(10)Reindex API
9.REINDEX API Reindex要求为源索引中的所有文档启用_source. reindex 不会配置目标索引,不会复制源索引的设置.你需要在reindex之前先指定mapping,分片数量 ...
- 【Java基础】4、java中的内部类
内部类的分类:常规内部类.静态内部类.私有内部类.局部内部类.匿名内部类. 实例1:常规内部类 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 2 ...