
CUDA学习(六)之使用共享内存(shared memory)进行归约求和(M个包含N个线程的线程块)
在https://www.cnblogs.com/xiaoxiaoyibu/p/11402607.html中介绍了使用一个包含N个线程的线程块和共享内存进行数组归约求和,
基本思路:
定义M个包含N个线程的线程块时(NThreadX = ((NX + ThreadX - 1) / ThreadX)),全局线程索引需使用tid = blockIdx.x * blockDim.x + threadIdx.x,而在每个线程块中局部线程索引是i = threadIdx.x,
每个线程块只计算一部分求和,求和结果保存在该线程块中的共享内存数组0号元素中,线程结束后将该值赋给对应全局数组(blockIdx.x * blockDim.x)元素中,最后在CPU端使用循环将每个线程块所求和相加,即得到最后结果。
代码如下:
#pragma once

#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include "device_functions.h"

#include <iostream>

using namespace std;

const int NX = ;            //数组长度

const int ThreadX = ;        //线程块大小

//使用shared memory和多个线程块

__global__ void d_SharedMemoryTest(double *para)

{

    int i = threadIdx.x;                                    //该线程块中线程索引

    int tid = blockIdx.x * blockDim.x + threadIdx.x;        //M个包含N个线程的线程块中相对应全局内存数组的索引(全局线程)

    __shared__ double s_Para[ThreadX];                        //定义固定长度(线程块长度)的共享内存数组

    if (tid < NX)                                            //判断全局线程小于整个数组长度NX,防止数组越界

        s_Para[i] = para[tid];                                //将对应全局内存数组中一段元素的值赋给共享内存数组

    __syncthreads();                                         //(红色下波浪线提示由于VS不识别,不影响运行)同步,等待所有线程把自己负责的元素载入到共享内存再执行下面代码

    for (int index = ; index < blockDim.x; index *= )        //归约求和

    {

        __syncthreads();

        if (i % ( * index) == )

        {

            s_Para[i] += s_Para[i + index];

        }

    }

    if (i == )                                                //求和完成,总和保存在共享内存数组的0号元素中

        para[blockIdx.x * blockDim.x + i] = s_Para[i];        //在每个线程块中,将共享内存数组的0号元素赋给全局内存数组的对应元素,即线程块索引*线程块维度+i(blockIdx.x * blockDim.x + i)

}

//使用shared memory和多个线程块

void s_ParallelTest()

{

    double *Para;

    cudaMallocManaged((void **)&Para, sizeof(double) * NX);        //统一内存寻址,CPU和GPU都可以使用

    double ParaSum = ;

    for (int i = ; i<NX; i++)

    {

        Para[i] = (i + ) * 0.01;                        //数组赋值

        ParaSum += Para[i];                                //CPU端数组累加

    }

    cout << " CPU result = " << ParaSum << endl;        //显示CPU端结果

    double d_ParaSum;

    int NThreadX = ((NX + ThreadX - ) / ThreadX);

    cout << " 线程块大小 :" << ThreadX << "                线程块数量 :" << NThreadX << endl;

    d_SharedMemoryTest << < NThreadX, ThreadX >> > (Para);                //调用核函数(M个包含N个线程的线程块)

    cudaDeviceSynchronize();                            //同步

    for (int i=; i<NThreadX; i++)

    {

        d_ParaSum += Para[i*ThreadX];                    //将每个线程块相加求的和(保存在对应全局内存数组中)相加求和

    }

    cout << " GPU result = " << d_ParaSum << endl;        //显示GPU端结果

}

int main() {

    s_ParallelTest();

    system("pause");

    return ;

}
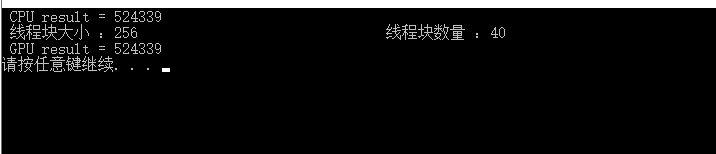
结果如下(CPU和GPU结果一致):
CUDA学习(六)之使用共享内存(shared memory)进行归约求和(M个包含N个线程的线程块)的更多相关文章
- linux内核剖析(十一)进程间通信之-共享内存Shared Memory
共享内存 共享内存是进程间通信中最简单的方式之一. 共享内存是系统出于多个进程之间通讯的考虑,而预留的的一块内存区. 共享内存允许两个或更多进程访问同一块内存,就如同 malloc() 函数向不同进程 ...
- 进程间通信之-共享内存Shared Memory--linux内核剖析(十一)
共享内存 共享内存是进程间通信中最简单的方式之中的一个. 共享内存是系统出于多个进程之间通讯的考虑,而预留的的一块内存区. 共享内存同意两个或很多其他进程訪问同一块内存,就如同 malloc() 函数 ...
- CUDA学习(五)之使用共享内存(shared memory)进行归约求和(一个包含N个线程的线程块)
共享内存(shared memory)是位于SM上的on-chip(片上)一块内存,每个SM都有,就是内存比较小,早期的GPU只有16K(16384),现在生产的GPU一般都是48K(49152). ...
- Linux进程间通信(六):共享内存 shmget()、shmat()、shmdt()、shmctl()
下面将讲解进程间通信的另一种方式,使用共享内存. 一.什么是共享内存 顾名思义,共享内存就是允许两个不相关的进程访问同一个逻辑内存.共享内存是在两个正在运行的进程之间共享和传递数据的一种非常有效的方式 ...
- 【CUDA 基础】5.2 共享内存的数据布局
title: [CUDA 基础]5.2 共享内存的数据布局 categories: - CUDA - Freshman tags: - 行主序 - 列主序 toc: true date: 2018-0 ...
- 【CUDA 基础】5.0 共享内存和常量内存
title: [CUDA 基础]5.0 共享内存和常量内存 categories: - CUDA - Freshman tags: - 共享内存 - 常量内存 toc: true date: 2018 ...
- 【转载】Linux进程间通信(六):共享内存 shmget()、shmat()、shmdt()、shmctl()
来源:https://www.cnblogs.com/52php/p/5861372.html 下面将讲解进程间通信的另一种方式,使用共享内存. 一.什么是共享内存 顾名思义,共享内存就是允许两个不相 ...
- 共享内存shared pool (3):Library cache
Shared pool物理层面上由许多内存块(chunck)组成.从逻辑功能划分,Shared pool主要由三部分组成:Library cache,Dictionary cache和Control ...
- python学习笔记——多进程中共享内存Value & Array
1 共享内存 基本特点: (1)共享内存是一种最为高效的进程间通信方式,进程可以直接读写内存,而不需要任何数据的拷贝. (2)为了在多个进程间交换信息,内核专门留出了一块内存区,可以由需要访问的进程将 ...
- CUDA学习(四)之使用全局内存进行归约求和(一个包含N个线程的线程块)
问题:使用CUDA进行数组元素归约求和,归约求和的思想是每次循环取半. 详细过程如下: 假设有一个包含8个元素的数组,索引下标从0到7,现通过3次循环相加得到这8个元素的和,使用一个间隔变量,该间隔变 ...
随机推荐
- $HDU$ 4352 ${XHXJ}'s LIS$ 数位$dp$
正解:数位$dp$+状压$dp$ 解题报告: 传送门! 题意大概就是港,给定$[l,r]$,求区间内满足$LIS$长度为$k$的数的数量,其中$LIS$的定义并不要求连续$QwQ$ 思路还算有新意辣$ ...
- $[NOIp2017]$ 逛公园 $dp$/记搜
\(Des\) 给定一个有向图,起点为\(1\),终点为\(n\),求和最短路相差不超过\(k\)的路径数量.有\(0\)边.如果有无数条,则输出\(-1\). \(n\leq 10^5,k\leq ...
- 【自建gitlab服务器】gitlab内存持续增大,出现502错误的解决办法
首先说明笔者的服务器环境,阿里云服务器:8G内存,2核.自从团队运维小伙伴搭建了gitlab之后,git push 代码时不时的就很卡,也经常出现 gitlab 反应超时,返回502错误,严重阻塞了团 ...
- C++ | C++ 概览 基础知识 | 01
一.基本概念 1.1 类型.变量和算术运算 1.2 常量 1.3 检验和循环 1.4 指针,数组和循环 二.用户自定义类型 2.1 结构 2.2 类 2.3 枚举 三.模块化 3.1 分离编译 3.2 ...
- Win7计划任务命令
计划任务命令 schtasks C:\Users\Administrator>schtasks /? SCHTASKS /parameter [arguments] 描述: 允许管理员创建.删除 ...
- python报错: invalid syntax
invalid syntax: 无效的语法. 解决办法:查看当前语句中的 , 如果当前行没找到错误,依次往上找,往上找时可以利用是否有输出进行快速查找. 原因:python语法很严格,少了左括号.右 ...
- 重拾c++第一天(3):数据处理
1.short至少16位:int至少与short一样长:long至少32位,且至少与int一样长:long long至少64位,且至少与long一样长 2.sizeof 变量 返回变量长度 或者s ...
- 七彩线段 - 装压dp (牛客网)
题目描述听说彩虹有七种颜色?一维坐标轴上n条线段,每条线段左端点l,右端点r,颜色为c,从中选m种颜色的互不接触的线段,每种颜色可选多条,所选线段的总长度最长为多少?输入描述: 第一行2个整数 n, ...
- Ansible配合Virtualenv安装配置
Ansible的两种安装模式(Centos7) 1.Yum包管理安装 #yum -y install ansible 2.Git源代码安装[推荐] git clone https://github.c ...
- Flash 上下文管理
1.Local() 作用:为每个协程或线程创建一个独立的内存空间 储存格式: { 唯一标识: {'stack': []} } 代码 try: from greenlet import getcurre ...