
想买保时捷的运维李先生学Java性能之 垃圾收集器
前言
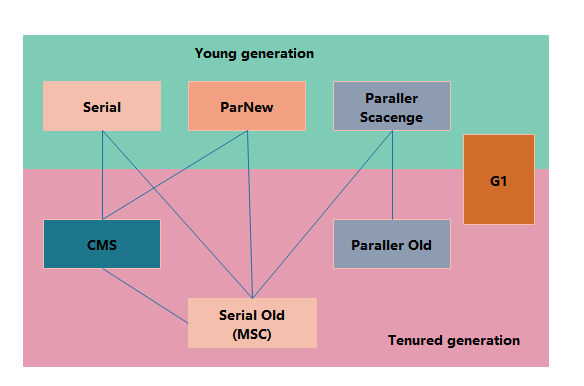
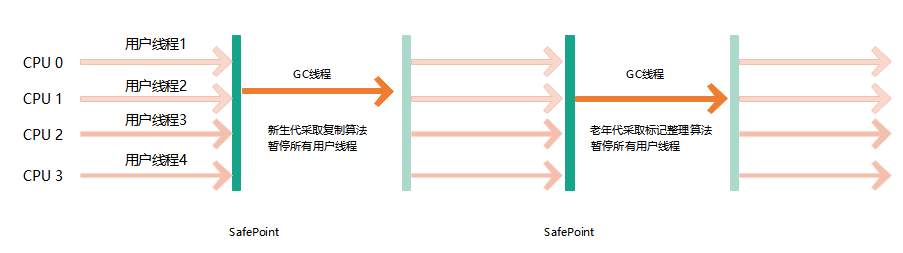
一、Serial收集器
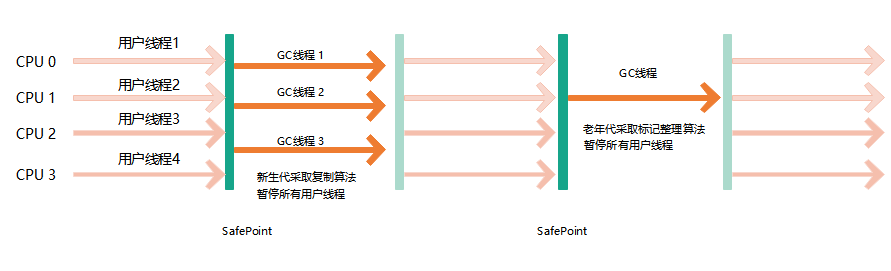
二、ParNew收集器
三、Paraller Scanvenge收集器
4、Serial Old收集器

五、parallel Old 收集器
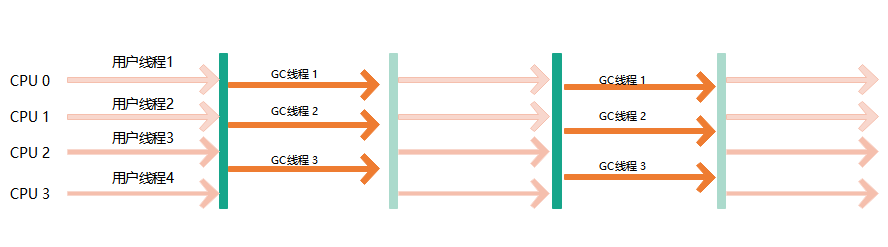
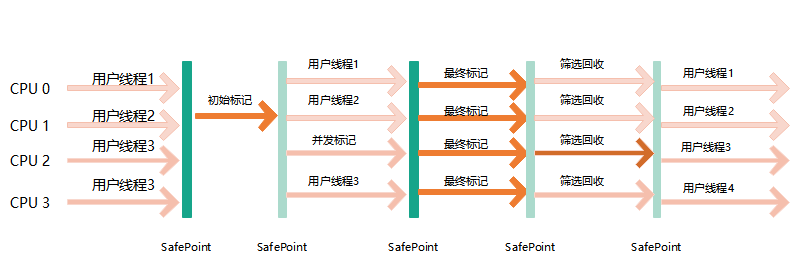
6、CMS收集器

七、G1(Garbage-First)收集器
想买保时捷的运维李先生学Java性能之 垃圾收集器的更多相关文章
- 想买保时捷的运维李先生学Java性能之 垃圾收集算法
前言 从原来只知道-Xms.-Xmx是设置内存的,到现在稍微理解了一些堆内存等Java虚拟机的一些知识.明白了技术这一个东西还是得要有输入才能实践,原理与实践要相辅相成,后续把JVM的监控好好总结一下 ...
- 想买保时捷的运维李先生学Java性能之 运行时数据区域
前言 不知道自己不知道,不知道自己知道,知道自己不知道,知道自己知道,目前处于知道自己不知道这个阶段,很痛苦啊,干了4年了运维,是一个坎.越来越发觉想要走得远,还是得扎根底. 一.运行时数据区域 ...
- 想买保时捷的运维李先生学Java性能之 生存与毁灭
一.判断对象是否存活 1.引用计数算法 给对象中添加一个引用计数器,每当有一个地方引用它时,计数器就加1:当引用失效时,计数器的值就减1:任何时刻计数器为0的对象是不可能再被使用的.引用计 ...
- 想买保时捷的运维李先生学Java性能之 JIT即时编译器
前言 本文记录日常学习<深入理解Java虚拟机>,不知道为啥感觉看一遍也就过了,喜欢动动手理解理解,这样才有点感觉,静不下心来的时候,看书抄书也可以用这个办法. 一.什么是JIT(Just ...
- Linux运维不可不知的性能监控和调试工具
Linux运维不可不知的性能监控和调试工具 1 nagios Nagios是一个开源监控解决方案,我觉得他可以监控一切 ,可以看一下我以前的文章:NAGIOS 2 ps #用来查看程序的运行情况 ps ...
- Python_oldboy_自动化运维之路_函数,装饰器,模块,包(六)
本节内容 上节内容回顾(函数) 装饰器 模块 包 1.上节内容回顾(函数) 函数 1.为什么要用函数? 使用函数之模块化程序设计,定义一个函数就相当于定义了一个工具,需要用的话直接拿过来调用.不使用模 ...
- 从零开始学 Java - Spring AOP 拦截器的基本实现
一个程序猿在梦中解决的 Bug 没有人是不做梦的,在所有梦的排行中,白日梦最令人伤感.不知道身为程序猿的大家,有没有睡了一觉,然后在梦中把睡之前代码中怎么也搞不定的 Bug 给解决的经历?反正我是有过 ...
- 从零起步做到Linux运维经理, 你必须管好的23个细节
“不想成为将军的士兵,不是好士兵”-拿破仑 如何成为运维经理? 一般来说,运维经理大概有两种出身:一种是从底层最基础的维护做起,通过出色的维护工作,让公司领导对这个人非常认可,同时对Linux运维工作 ...
- 从零起步做到Linux运维经理,你必须管好的23个细节
不想成为将军的士兵,不是好士兵-拿破仑 如何成为运维经理?成为运维经理需要什么样的能力?我想很多运维工程师都会有这样的思考和问题. 如何成为运维经理.一般来说,运维经理大概有两种出身,一种是从底层最基 ...
随机推荐
- xss利用——BeEF#stage4(其余功能介绍)
目录 信息收集 => 社会工程 =>网络扫描 => 结合metasploit => tunneling => xss => 维持权限 功能介绍 #1 - 信息收集 ...
- Alink漫谈(二十二) :源码分析之聚类评估
Alink漫谈(二十二) :源码分析之聚类评估 目录 Alink漫谈(二十二) :源码分析之聚类评估 0x00 摘要 0x01 背景概念 1.1 什么是聚类 1.2 聚类分析的方法 1.3 聚类评估 ...
- 基于python的webUI自动化-小白基础篇
最近打算研究一下基于python的webUI自动化,先自学了一下相关基础知识,大概用了一个多月的时间,主要是找视频,一边看视频或者文档一边对照着敲代码运行. 重点强调:一定要一边看一边对照着敲代码运行 ...
- mysql-11-DML
#DML语言 /* 数据操作语言 插入:insert 修改:update 删除:delete */ #一.插入语句 /* 语法: insert into 表名(列名...) values(新值...) ...
- Python练习题 002:奖金计算
[Python练习题 002]企业发放的奖金根据利润提成.利润(I)低于或等于10万元时,奖金可提10%:利润高于10万元,低于20万元时,低于10万元的部分按10%提成,高于10万元的部分,可可提成 ...
- Python练习题 001:4个数字求不重复的3位数
听说做练习是掌握一门编程语言的最佳途径,那就争取先做满100道题吧. ----------------------------------------------------------------- ...
- centos7中nfs共享的配置方法
NFS是Network File System的缩写,即网络文件系统.客户端通过挂载的方式将NFS服务器端共享的数据目录挂载到本地目录下. 一.nfs为什么需要RPC? 因为NFS支持的功能很多,不同 ...
- Java知识系统回顾整理01基础01第一个程序03Eclipse下载安装
Eclipse是最流行的java 集成开发环境IDE(Integrated Development Environment) 下载安装Eclipse两种方式 一.方式1:Eclipse官网下载安装 链 ...
- C++库文件解析(conio.h)
转载:https://blog.csdn.net/ykmzy/article/details/51276596 Conio.h 控制台输入输出库该文内容部分参照百度百科 Conio.h 在C stan ...
- STM32之旅3——时钟数
STM32之旅3--时钟数 STM32F1是M3内核,它的时钟数很庞大,让一个初学者去看,估计会很吃力,和我们入门的8051单片机的时钟不同,这里又倍频.又分频,而且还分成好多个时钟,不同的外设时钟不 ...