
Mixed Precision Training —— caffe-float16
简介
最近有了突如其来的想法,如何把caffe的变得更小更快。后来翻到Nvidia开发caffe-float16,同时也看到它的论文。看完大致了解一番后,就做一下记录。
该工作的目标是,减少网络的所需的内存大小和提升网络的 inference(推理)速度。nvidia通过才用自己开发的 float16 半精度 cuda_fp16.h 数据类型,在forward和backward propagation中代替 float 32 bits的单精度数据类型。因此,在降低网络的数据的 precision 时候,导致产生了网络 accuracy 降低和 gradient 消失无法收敛的问题。当然,我在这里并不想重复的写出文中所有的点(因为其中总体的idea在量化quantization 方面是“general” 的),仅对该工作我觉得特有的点或感兴趣的点进行简述。
Mixed Precision
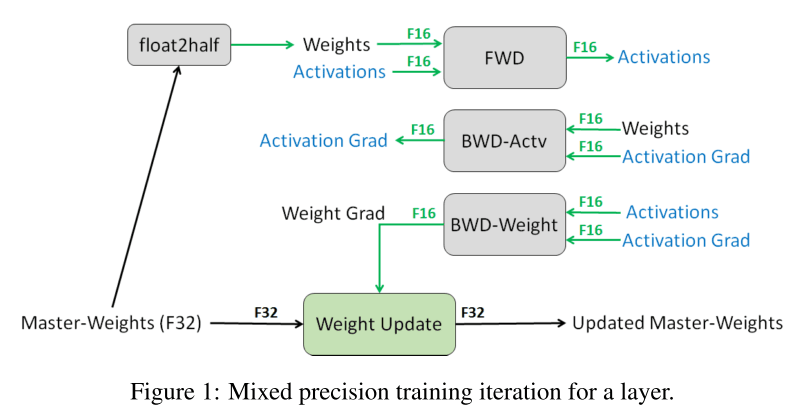
在caffe-float16 中的Blob重写,改为data和diff分别用不同的数据类型表示,这可以选着你所需的精确的数据类型:
//blob.hpp

 protected:

  Blob(Type data_type, Type diff_type)

      : data_tensor_(make_shared<Tensor>(data_type)),

        diff_tensor_(make_shared<Tensor>(diff_type)),

        count_(0) {}
而Master-Weights(F32)-->float2half的实现就是每次this->blobs_[0]->template gpu_data<Ftype>(); 中做一次类型转换:
//conv_layer.cu

const Ftype* weight = this->blobs_[0]->template gpu_data<Ftype>();
//blob.hpp

  template<typename Dtype>

  const Dtype* gpu_data() const {

    convert_data(tp<Dtype>());

    return static_cast<const Dtype*>(data_tensor_->synced_mem()->gpu_data());

  }

  void convert_data(Type new_data_type) const {

    data_tensor_->convert(new_data_type);

  }
//tensor.cpp

void Tensor::convert(Type new_type) {

  if (new_type == type_) {

    return;

  }

  const shared_ptr<SyncedMemory>& current_mem = synced_mem();

  shared_ptr<SyncedMemory>& new_mem = synced_arrays_->at(new_type);

  if (!new_mem || !new_mem->is_valid()) {

    const std::size_t new_cap = even(count_) * tsize(new_type);

    if (!new_mem || new_mem->size() != new_cap) {

      new_mem = make_shared<SyncedMemory>(new_cap);

    }

    const bool data_gpu = Caffe::mode() == Caffe::GPU;

    if (current_mem->head() != SyncedMemory::UNINITIALIZED) {

      copy_helper(data_gpu, count_,

          data_gpu ? current_mem->gpu_data() : current_mem->cpu_data(),

          type_,

          data_gpu ? new_mem->mutable_gpu_data() : new_mem->mutable_cpu_data(),

          new_type);

    }

  } // we just trust its current status otherwise

  type_ = new_type;

  new_mem->validate();

}
神经网络的 quantization 一般可分 activation、weight 部分,当然也存在继续对不同类型 layer 的 weghit 进行 quantization 的。而 Nvidia 则提出了 gradient 也是要 quantization 。上图是文中的整个方法的流程图,为了防止用无法拟合,采用全精度的 flaot32 来保存完整的权重信息(其他文章又叫 full precision shadow weight ),每次 forward 是都做copy 和 round/quantization 。 这是有两个原因:
- 因为 gradient x learning rate < \(2^{-24}\) ,小于float16 范围,导致梯度消失无法更新。
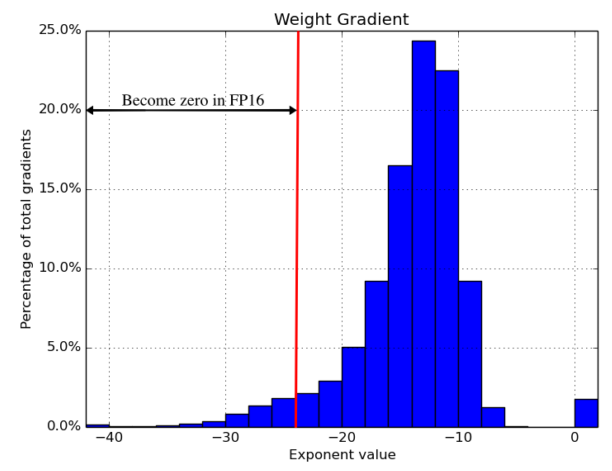
2.由于浮点型的特性,相加时会进行小数点对齐(即对其 exponent)。由于float16 表示的weight 与 float16表示的 gradient 相差2048倍(因为float16 的 mantissa 只有 10bits,有右移超过11bits ,即2048倍),则 gradient 变成0。float16 各个部分:
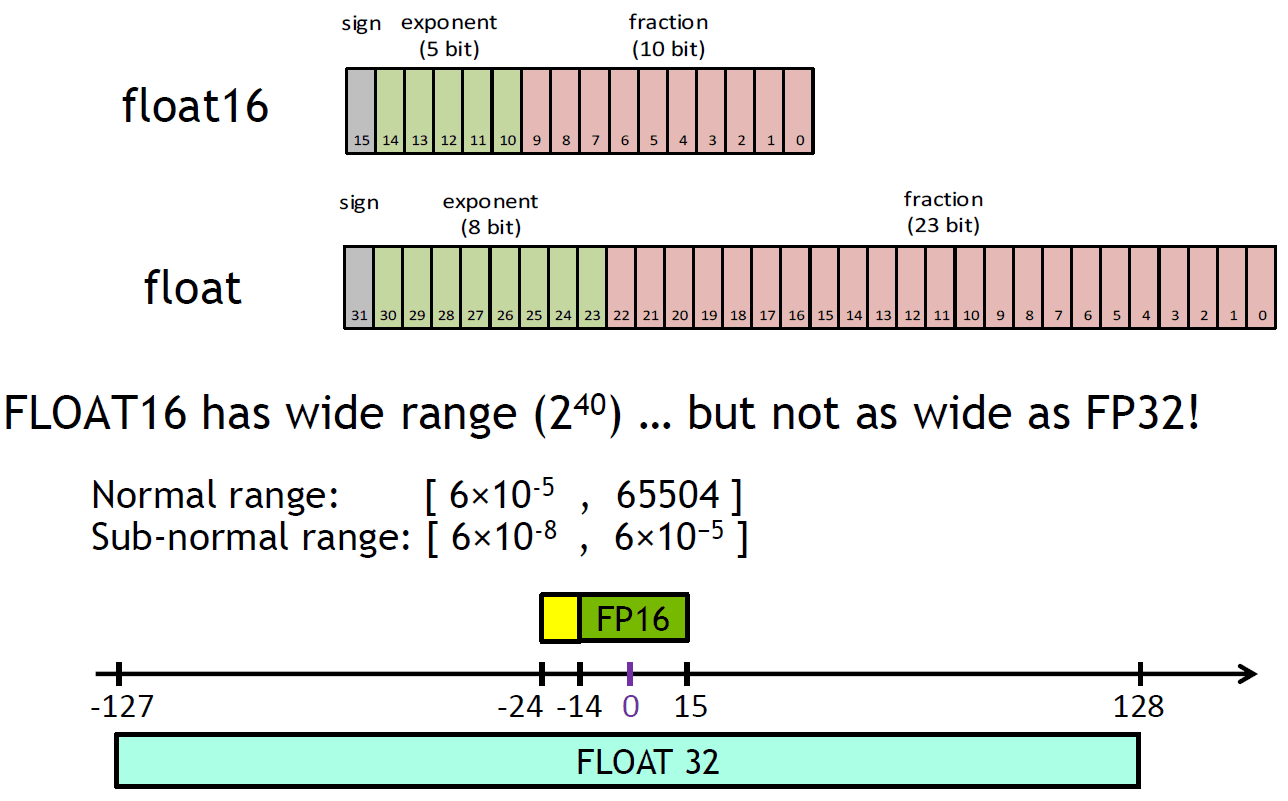
除非指数位全是0,否则就会假定隐藏的起始位是1。因此只有10位 mantissa在内存中被显示出来,而总精度是11位。据IEEE 754的说法,虽然尾数只有10位,但是尾数精度是11位的(log10(211) ≈ 3.311 十进制数).
而Weight Update,会对diff进行类型转换
//blob.hpp

// The "update" method is used for parameter blobs in a Net, which are stored

// as TBlob<float> or TBlob<double> -- hence we do not define it for

// TBlob<int> or TBlob<unsigned int>.

void Blob::Update() {

  convert_diff(data_type());  // align data&diff types

  shared_ptr<SyncedMemory>& data_mem = data_tensor_->mutable_synced_mem();

  const shared_ptr<SyncedMemory>& diff_mem = diff_tensor_->synced_mem();

  // We will perform update based on where the data is located.

  switch (data_mem->head()) {

  case SyncedMemory::HEAD_AT_CPU:

    // perform computation on CPU

    cpu_axpy(count_, data_type(), -1.F,

        diff_mem->cpu_data(), data_mem->mutable_cpu_data());

    break;

  case SyncedMemory::HEAD_AT_GPU:

  case SyncedMemory::SYNCED:

#ifndef CPU_ONLY

    gpu_axpy(count_, data_type(), -1.F,

        diff_mem->gpu_data(), data_mem->mutable_gpu_data());

#else

    NO_GPU;

#endif

    break;

    default:

    LOG(FATAL) << "Syncedmem not initialized.";

  }

  CHECK(is_current_data_valid());

  CHECK(is_current_diff_valid());

}
Lose Scaling
从上面float16 各个部分位宽可以得到,float16 可以表示的范围是\([2^{-24},2^{15}]\)(exponent表示范围是\([2^{-14},2^{15}]\),其中 mantissa是10bits)。但是 activation的 gradient的分布却在 \([2^{-60},2^{-10}]\),在float16 中有非常大的表示范围并没用,同时导致大多数的activation gradient变成0。因此,对activation gradient在forward后,backward propagation前做scaling/shift 。并且,在链式法则backward propagation 中的所有activation gradient按想用的量进行scaling。
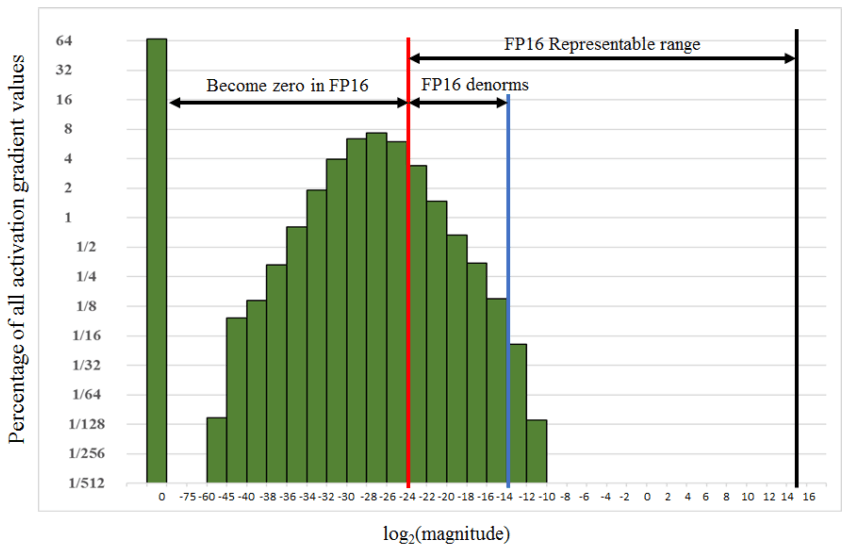
具体操作(因为activation gradient做scaling,那么也要对learning rate和weight_decay做scaling):
#caffe train_val.prototxt

#To sfift gradients dE/dX we will scale up the loss function by constant (e.g. by 1000):

layer {

	type: "SoftMaxWithLoss"

	loo_weight: 1000.

}

#and adjust learning rate and weights decay accordingly

base_lr: 0.00001 #(original value is 0.01, 0.01 / 1000)

weight_decay: 0.5  #(original value is 0.0005, 0.5 * 1000)
其中decay_weight公式为:
\]
而在softmax_loss_layer.cu的实现为:
template <typename Ftype, typename Btype>

void SoftmaxWithLossLayer<Ftype, Btype>::Backward_gpu(const vector<Blob*>& top,

    const vector<bool>& propagate_down, const vector<Blob*>& bottom) {

	...

    float loss_weight = float(top[0]->cpu_diff<Btype>()[0]) /

                              get_normalizer(normalization_, valid_count);

    if (this->parent_net() != NULL) {

      loss_weight *= this->parent_net()->global_grad_scale();

    }

    caffe_gpu_scal<Btype>(prob_->count(), loss_weight , bottom_diff);

  }

}
FP16 Master Weight Storage
在该论文之外,Nvidia还考虑避免每次foward都复制权重,用float16进行权重更新的问题。
- 最核心一点就是避免gradient \(\eta{{\partial E}\over \partial \omega_i}=\eta\Delta \omega_i\)消失。
那么Nvidia提出对momentum SGD 进行改进
- Compute momentum \(H\) : \(H(t+1)=m*H(t)-\lambda \Delta W(t)\)
- Update wights with \(H\): \(W(t+1)=W(t)+H(t+1)\)
假设\(\lambda\)为常数,把式①展开:
\]
\]
因此新的公式:
- Compute momentum \(H\) : \(H(t+1)=m*H(t)-\color{#F00}{\cancel{\lambda}}\Delta W(t)\)
- Update wights with \(H\): \(W(t+1)=W(t)+\color{#F00}{\lambda} H(t+1)\)
这样可以避免\(H\)在\(\lambda \Delta W(t)\)消失时,momentum不断的消失。因为新的公式避免了\(\Delta W(t)\)的消失,而且momentum会不断更新。
ps:这里Nvidia解释是 Moment works as average of gradients.
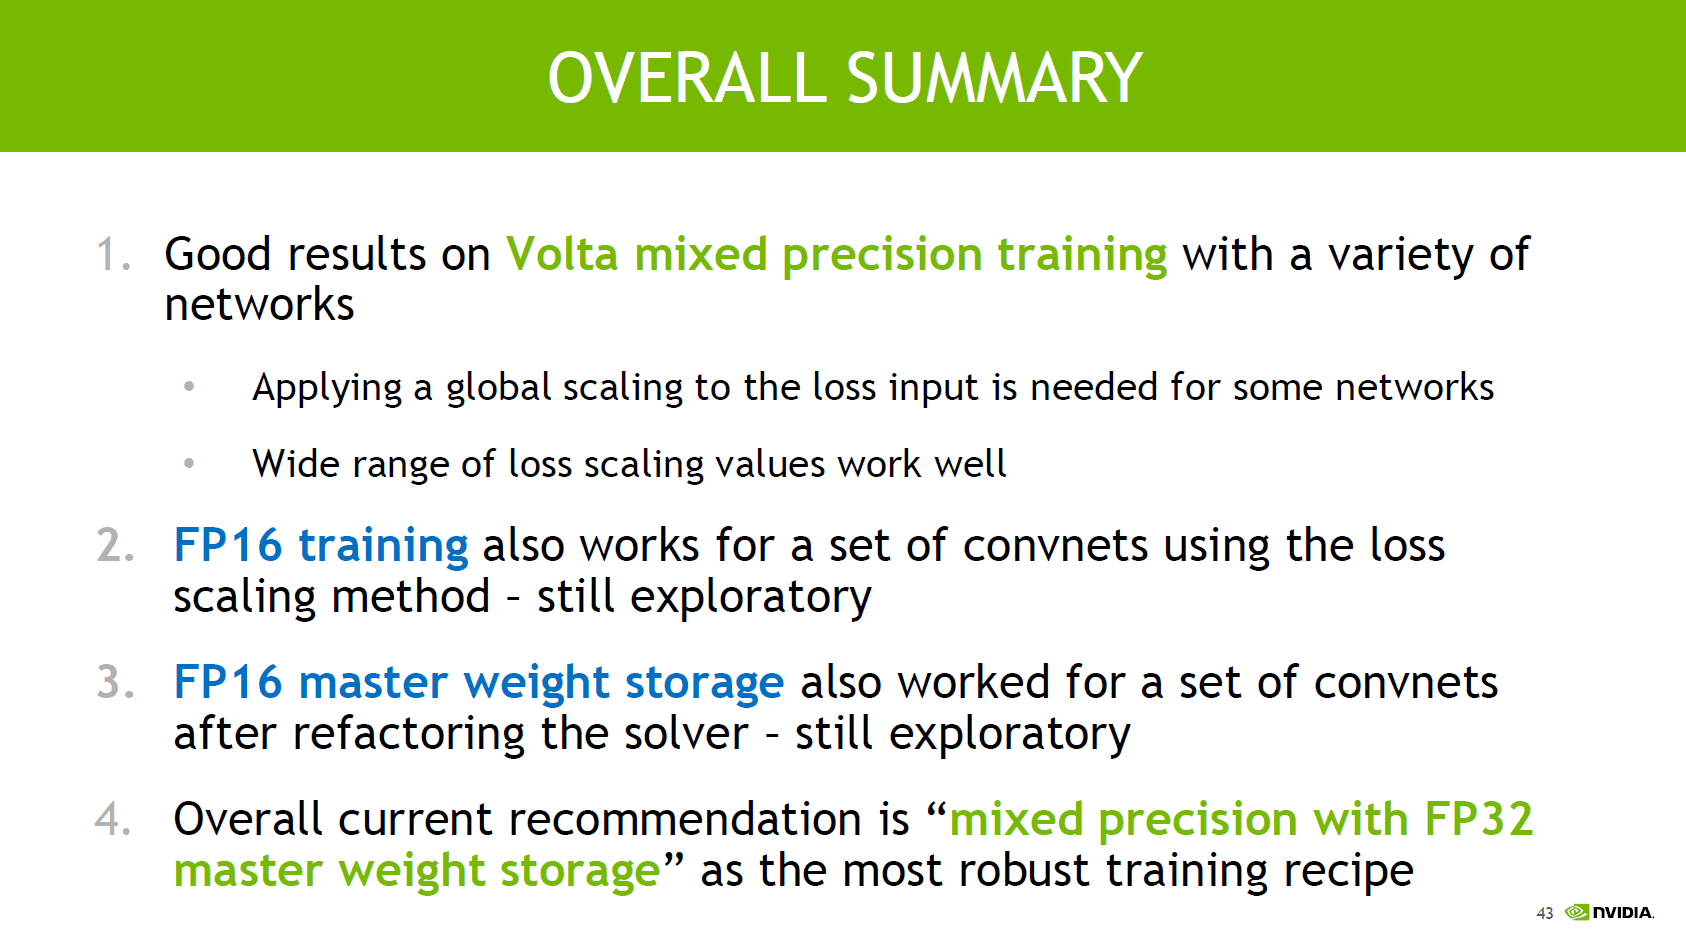
Nvidia的总结
懒癌犯了- -!!
Mixed Precision Training —— caffe-float16的更多相关文章
- [源码解析] 深度学习分布式训练框架 horovod (5) --- 融合框架
[源码解析] 深度学习分布式训练框架 horovod (5) --- 融合框架 目录 [源码解析] 深度学习分布式训练框架 horovod (5) --- 融合框架 0x00 摘要 0x01 架构图 ...
- [源码解析] 深度学习分布式训练框架 horovod (6) --- 后台线程架构
[源码解析] 深度学习分布式训练框架 horovod (6) --- 后台线程架构 目录 [源码解析] 深度学习分布式训练框架 horovod (6) --- 后台线程架构 0x00 摘要 0x01 ...
- 使用 PyTorch Lightning 将深度学习管道速度提高 10 倍
前言 本文介绍了如何使用 PyTorch Lightning 构建高效且快速的深度学习管道,主要包括有为什么优化深度学习管道很重要.使用 PyTorch Lightning 加快实验周期的六种 ...
- Bag of Tricks for Image Classification with Convolutional Neural Networks笔记
以下内容摘自<Bag of Tricks for Image Classification with Convolutional Neural Networks>. 1 高效训练 1.1 ...
- Pytorch原生AMP支持使用方法(1.6版本)
AMP:Automatic mixed precision,自动混合精度,可以在神经网络推理过程中,针对不同的层,采用不同的数据精度进行计算,从而实现节省显存和加快速度的目的. 在Pytorch 1. ...
- [源码解析] 深度学习分布式训练框架 Horovod (1) --- 基础知识
[源码解析] 深度学习分布式训练框架 Horovod --- (1) 基础知识 目录 [源码解析] 深度学习分布式训练框架 Horovod --- (1) 基础知识 0x00 摘要 0x01 分布式并 ...
- 用NVIDIA A100 GPUs提高计算机视觉
用NVIDIA A100 GPUs提高计算机视觉 Improving Computer Vision with NVIDIA A100 GPUs 在2020年英伟达GPU技术会议的主题演讲中,英伟达创 ...
- 基于OpenSeq2Seq的NLP与语音识别混合精度训练
基于OpenSeq2Seq的NLP与语音识别混合精度训练 Mixed Precision Training for NLP and Speech Recognition with OpenSeq2Se ...
- 用NVIDIA Tensor Cores和TensorFlow 2加速医学图像分割
用NVIDIA Tensor Cores和TensorFlow 2加速医学图像分割 Accelerating Medical Image Segmentation with NVIDIA Tensor ...
随机推荐
- keyring源码加密解密函数分析
Encrypt the page data contents. Page type can't be FIL_PAGE_ENCRYPTED, FIL_PAGE_COMPRESSED_AND_ENCRY ...
- Show information of directory or disk
There are so many commands of Ubuntu, we just need to know useful and high-frequency commands. I hav ...
- redis入门指南(四)—— redis如何节省空间
写在前面 学习<redis入门指南>笔记,结合实践,只记录重要,明确,属于新知的相关内容. 节省空间 1.redis对于它所支持的五种数据类型,每种都提供了两种及以上的编码方式去存储(具体 ...
- Spirngboot-自定义Starter
一.Spring Boot Starter简介 Starter是Spring Boot中的一个非常重要的概念,Starter相当于模块,它能将模块所需的依赖整合起来并对模块内的Bean根据环境( 条件 ...
- 关于在JSP页面识别不了EL表达式的情况
今天在JSP页面接收Controller返回的数据user_nickname,使用EL表达式显示数据发现在页面输出的始终是字符串${user_nickname} 经过查阅资料,问题在于使用的web.x ...
- Illegal instant due to time zone offset transition (Asia/Shanghai)_夏令时问题
项目报错信息: Connot parse "1991-04-14",illegal instant due to time zone offset transition(Asia/ ...
- DEX文件解析--4、dex类的类型解析
一.前言 前几篇系列文章链接: DEX文件解析---1.dex文件头解析 DEX文件解析---2.Dex文件checksum(校验和)解析 DEX文件解析--3.dex文件 ...
- Java数组最大值和最小值
package com.mybatis.demo.exercise; /** * @author yinsenxin */ public class ArrayMaxAndMin { public s ...
- Ethical Hacking - NETWORK PENETRATION TESTING(7)
Gaining Access to encrypted networks Three main encryption types: 1. WEP 2.WPA 3.WPA2 WEP Cracking W ...
- Oracle常见错误以及解决方法
前言: 本博客为博主在开发中遇到的问题,为大家提供解决方法,如需转载,请注明来源,谢谢! 问题一: 第一次用PLSQL Developer连接数据库,若用sys用户登录并操作则正常,若用普通用户比如x ...