
Jmeter阶梯式压测
https://www.cnblogs.com/Zfc-Cjk/p/11639219.html
什么是阶梯式压测?
阶梯式压测,就是对系统的压力呈现阶梯性增加的过程,每个阶段压力值都要增加一个数量值,最终达到一个预期值。然后保持该压力值,持续运行一段时间。实际上,阶梯式压测,是负载测试的一种通用方法。
为什么要阶梯式压测?
原因与负载测试是相同的。其目标是测试在一定负载情况下的系统性能,测试系统的不同负载情况下的性能指标。这种方法可以帮助我们,在最初无法预知服务器性能的情况下,迅速的得到一个极限值。在执行中,如果某个阶梯时间内Error率突然增加,那么这个阶段就是服务器的某个极限值。这种方法,要比我们不断地循环“设定并发值->执行->查看结果->调整并发值”这样一个迭代过程要方便的多。
Jmeter阶梯式压测方法
首先,安装相关插件,该插件可以在插件管理中找到。插件安装可参考:https://jmeter-plugins.org/downloads/all/ 。我们用到的就是这个Concurrency Thread Group。这个插件替代了之前的一个插件:Stepping Thread Group(已废弃),功能类似,不过使用上要更简单。安装步骤如图:
第一步:打开插件管理器

第二步:选择左侧Custom Thread Groups
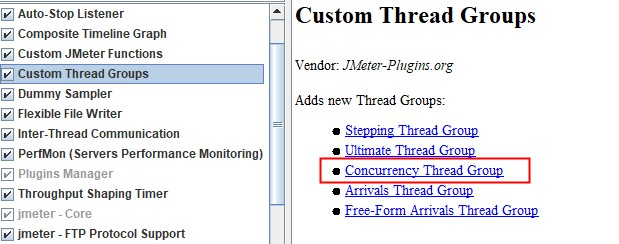
第三步:点击右下的按钮进行安装

安装完成后,我们开始创建测试计划,并选择Concurrency Thread Group:
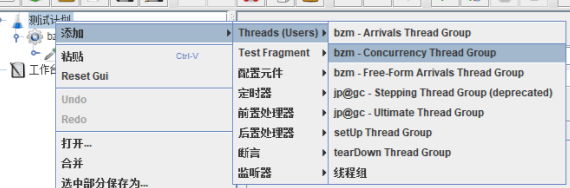
得到下图:

上部分,是对遇到错误时的判断操作,停止或继续测试,可以根据需要进行选择使用。

下部分,是该压测的并发数据输入框。来看下各个参数的含义:
Target Concurrency:目标并发数
Ramp Up Time:加速时间
Ramp-Up Steps Count:加速次数
Hold Target Rate Time:保持目标速率时间
Time Unit:时间单位
Thread Iterations Limit:线程迭代次数限制,即循环次数(空,即为一次)
Log Threads Status into File:将线程状态记录到文件中(保存日志文件);
以图中所示为例,首先Time Unit选择的是min(分),输入的数据为:
Target Concurrency: 50
Ramp up Time(min): 1
Ramp-up Steps Count: 5
Hold Target Rate Time(min): 1
Thread Iterations Limit: (空)
此用例场景为 ,在“Ramp up Time(min): ”1分钟的时间内,一共产生目标线程“Target Concurrency: ”50个;并且,分成“Ramp-up Steps Count: ”5个阶段来完成;在目标线程产生结束后,维持该线程生产速度“Hold Target Rate Time(min): ”1分钟;并且循环执行“Thread Iterations Limit: ”1次。over。
图中红色线条显示了单个循环内线程的产生概况,X轴为时间,共2min;Y轴为线程数,最高50条。5个阶梯显示出了线程的阶梯状分布。
现在对某个主页进行压测实验,并发参数就是上面输入的参数。
聚合报告如下:

Active Threads Over Time如:

从“Active Threads Over Time”这个图里可以清楚看到,并发线程数量呈现出明显的阶梯形状。在不同的时间段内,服务器处在不同的压力级别当中。
那么阶梯式压测与普通的压测有什么区别呢?
先按照普通压测方式执行一次,查看结果。并发数据输入:

聚合报告如:

Active Threads Over Time如:

第一点不同,普通的压测方式,并发的线程数是可预知的;而阶梯压测是未知的。
普通压测,只要参数不变,每次结束后,#Samples一定是50x30=1500。而阶梯式压测,每次的并发数是变化的。我们现在依照上面给的参数,再进行2次压测。
第二次阶梯压测的聚合报告如:

第三次阶梯压测的聚合报告如:

第二点不同,”Active Threads Over Time”是不一样的。普通压测,线程只定义了初始产生的时间(50/秒,循环30次),而没有定义后续线程。每个线程在完成了自己的生命周期后,就结束了。而阶梯压测,会保持活跃线程在一个数值上,后续线程会持续产生。因此,在图中会出现不同。
可以得知:阶梯压测的方式与普通线程产生的方式是不一样的。
普通的压测方式,线程产生是固定的按照每秒X个线程的方式来产生,只在线程发出端做了限制。而阶梯压测的方式,是根据实际运行情况产生线程。一个线程,从请求发出,到服务器端处理,再到返回结果接收,才算完成一个完整的生命周期。阶梯压测方式,可以控制每个单位时间内的线程数。就像我们在Active Threads Over Time表格中看到的,在一段时间内,活跃的线程数量基本保持不变。可以这样想,当一个线程结束,总线程数-1,为保持活跃度,jmeter会立刻再产生一个线程上来维持数量,此时总线程数+1。
产生线程的间隔时间是根据压测中的实际运行状态来决定的。旧的线程结束的快,新的线程产生的就快。因此,每次阶梯压测的结果,总线程数都不一样,因为每次压测负载机和服务器机的状态都不一样。
以上,就是对Jmeter工具阶梯压测方式的简单总结。欢迎补充。
Jmeter阶梯式压测的更多相关文章
- jmeter 插件安装之阶梯式压测(五)
一.Jmeter插件安装 jmeter-plugins-manager-1.4.jar 下载地址:https://jmeter-plugins.org/install/Install/ 下载之后将插件 ...
- Jmeter(十三)阶梯式压测
阶梯式压测,就是对系统的压力呈现阶梯性增加的过程,每个阶段压力值都要增加一个数量值,最终达到一个预期值.然后保持该压力值,持续运行一段时间. Jmeter中有个插件可以实现这个场景,这个插件就是:Co ...
- lesson5:利用jmeter来压测消息队列(activemq)
本文讲述了利用jmeter来压测消息队列,其中消息队列采用apache的activemq,jmeter本身是支持符合jms标准消息队列的压测,由于jmeter的官方sampler配置比较复杂,本文直接 ...
- lesson4:利用jmeter来压测数据库
本文讲述了如何利用jmeter来压测数据库,事例中选取了mysql作为测试数据库,其它的数据库也是一样,只需要更换驱动程序即可. 准备工作:a.mysql数据库安装,请自行百度:b.jdbc驱动包,请 ...
- jmeter 分布式压测(windows)
单台压测机通常会遇到客户端瓶颈,受制于客户机的性能.可能由于网络带宽,CPU,内存的限制不能给到服务器足够的压力,这个时候你就需要用到分布式方案来解决客户机的瓶颈,压测的结果也会更加接近于真实情况. ...
- jmeter简单压测设置
参数化 随机参数 时间参数 顺序自增函数 文件读取 直接引用 响应断言 用来查看sessionid 关联 关联引用 jmeter操作数据库 安装连接程序包 ip 端口号 哪个数据库 可以执行多条s ...
- jmeter接口压测的反思
jmeter接口压测的反思 1.keepalive的坑:连接数满了,导致发起的请求失败. 2.token关联?是数据库取做参数化,还是随机数生成(需要改代码) 3.签名问题如何处理? 4.压测负载机端 ...
- 压力测试(八)-多节点JMeter分布式压测实战
1.Jmeter4.0分布式压测准备工作 简介:讲解Linux服务器上jmeter进行分布式压测的相关准备工作 1.压测注意事项 the firewalls on the systems are tu ...
- JMeter分布式压测实战(2020年清明假期学习笔记)
一.常用压力测试工具对比 简介:目前用的常用测试工具对比 1.loadrunner 性能稳定,压测结果及颗粒度大,可以自定义脚本进行压测,但是太过于重大,功能比较繁多. 2.Apache ab(单接口 ...
随机推荐
- vue/cli创建项目过程
①vue create demo vue版本:3.9.3,node版本:12.8.0 ②Manually select features ③Bab ...
- swoole怎么连接数据库
异步连接到MySQL服务器. $serverConfig为MySQL服务器的配置,必须为关联索引数组 $callback连接完成后回调此函数 swoole连接数据库实例: 推荐学习:swoole教程 ...
- 干货|CVE-2019-11043: PHP-FPM在Nginx特定配置下任意代码执行漏洞分析
近期,国外安全研究员Andrew Danau,在参加夺旗赛(CTF: Capture the Flag)期间,偶然发现php-fpm组件处理特定请求时存在缺陷:在特定Nginx配置下,特定构造的请求会 ...
- bash字符串处理
将movie目录下的文件名写到markdown文件中 , 再转html rm index.md ; for f in `find . *.* | sort`; do [ -f $f ] &&a ...
- Linux无法连接网络解决方案
上次在VM中装好Linux以后,用xshell可以连接上Linux,可是今天在启动虚拟机打开Linux以后,发现又没有网络连接了,因为要用xshell连接的话首先要知道Linux的ipv4地址,在li ...
- Spark核心算子
Spark RDD: Transformation Meaning map(func) 返回一个新的分布式数据集,该数据集是通过将源的每个元素传递给函数func处理形成的. filter(func) ...
- docker安装宝塔面板
1.下载centos docker docker pull centos:7.2.1511 2.运行镜像设置端口 docker run -d -it -p 4001:8888 -p 4000:80 - ...
- OpenMP笔记(二)
原文:https://www.bearoom.xyz/2019/02/18/openmp2/ OpenMP是由三部分组成的:指令.库函数和环境变量. 一.指令 在C/C++中使用OpenMP需要用到的 ...
- mysql not in 或 in 优化
在MySQL 中,not in 或in 优化思路, 利用left join 来优化,类似如下的查询方式: select id from a where id in (select id from b ...
- 【MySQL参数】-innodb_flush_method
innodb_flush_method这个参数控制着innodb数据文件及redo log的打开.刷写模式,对于这个参数,文档上是这样描述的:有三个值:fdatasync(默认),O_DSYNC,O_ ...