
搜狗微信采集 —— python爬虫系列一
前言:一觉睡醒,发现原有的搜狗微信爬虫失效了,网上查找一翻发现10月29日搜狗微信改版了,无法通过搜索公众号名字获取对应文章了,不过通过搜索主题获取对应文章还是可以的,问题不大,开搞!
目的:获取搜狗微信中搜索主题返回的文章。
涉及反爬机制:cookie设置,js加密。
完整代码已上传本人github,仅供参考。如果对您有帮助,劳烦看客大人给个星星!
进入正题。
流程一:正常套路流程
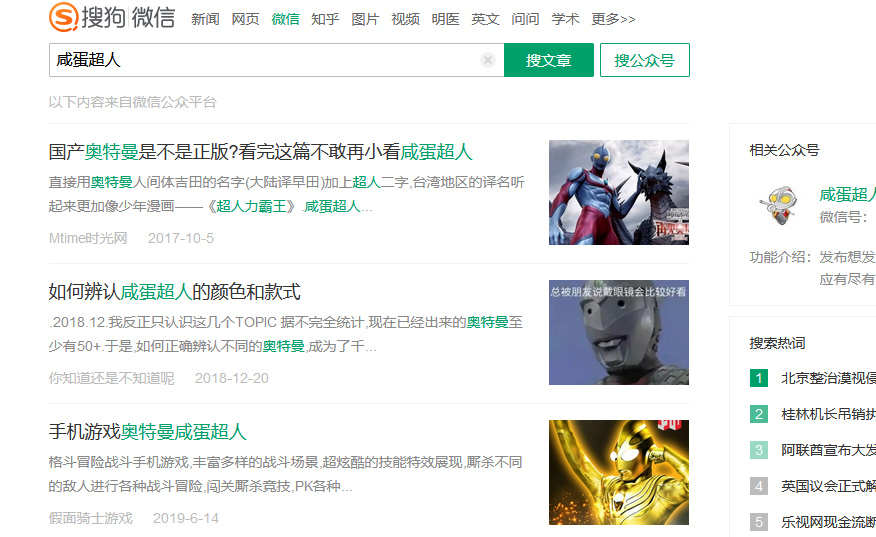
打开搜狗微信,在搜索框输入“咸蛋超人”,这里搜索出来的就是有关“咸蛋超人”主题的各个公众号的文章列表:
按照正常的采集流程,此时按F12打开浏览器的开发者工具,利用选择工具点击列表中文章标题,查看源码中列表中文章url的所在位置,再用xpath获取文章url的值,也就是这个href的值,为避免混乱,我们称之为“列表页面的文章url”。
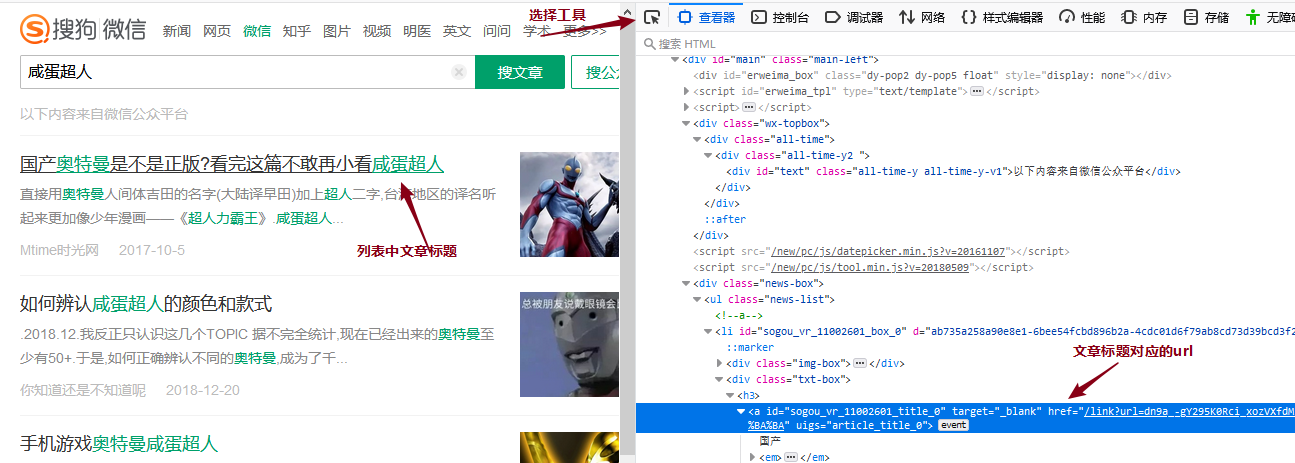
可以看到“列表页面的文章url”需要拼接,一般这种情况需要在浏览器中正常访问一下这篇文章,对比观察跳转后的url(我们称之为“真实的文章url”),再缺头补头缺脚补脚即可。下面是两个url的对比:
列表页面的文章url:
/link?url=dn9a_-gY295K0Rci_xozVXfdMkSQTLW6cwJThYulHEtVjXrGTiVgSwqn5HZrcjUNFzn4G2S0Yt3MduzuCU92ulqXa8Fplpd9CqUiLuEm9hLLvBiu5ziMS196rgHYb-GzQfleG917OgwN_VAAdAZHKryCeU9lIxtWTKnLsDcsuPIjLhLEK3tbGSa3_pkMzadQg75Zhmxb9YI0psZvVepKtN4hpzQgtGa2iOlKKLwV_oxooGE6sxg1qinKxTb5VwJUcLBM1RgkzAPRtmyIGw2VAg..&type=2&query=%E5%92%B8%E8%9B%8B%E8%B6%85%E4%BA%BA&k=92&h=z 真实的文章url:
https://mp.weixin.qq.com/s?src=11×tamp=1573092595&ver=1959&signature=FjD709D-0vHSyVgQyXCS-TUAcnT0M9Gx6JljQEb6O55zpuyyDaTHqgkRCxNDtt5ZDifDRUUBOemzxcz71FMOmO88m6RWfR0r4fFBe0VefAsjFu0pl-M0frYOnXPF5JD8&new=1
这里很明显两个url的路径不一致,应该是中间经过了一些调转,python的requests库是带自动调转功能,我们先把域名https://mp.weixin.qq.com补上试一下访问
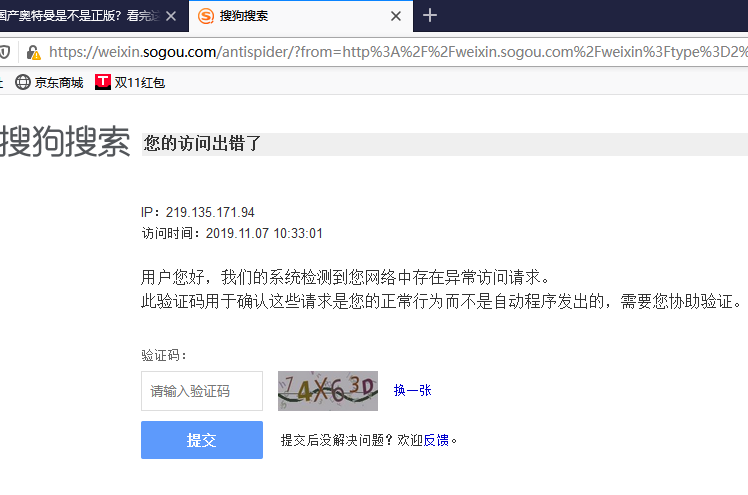
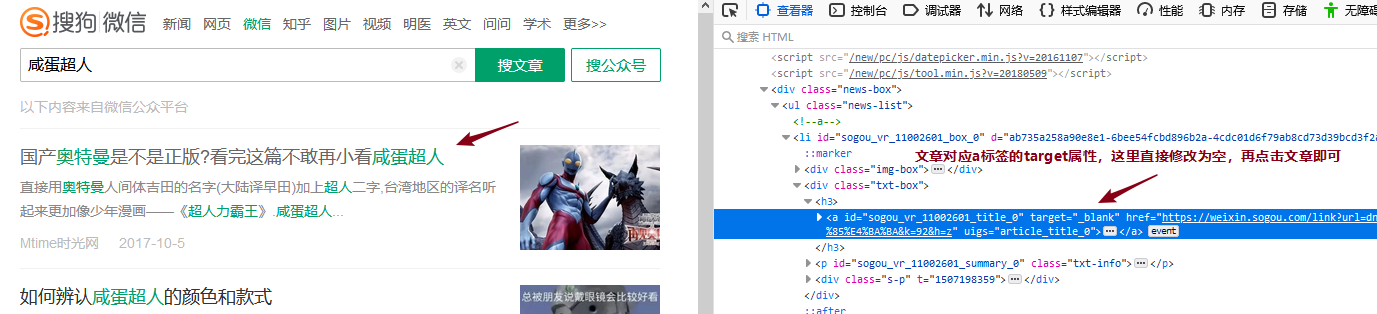
明显这里做了反爬限制,那么这里开始,我们就需要抓包分析了。这里用到的工具是Firefox浏览器的开发者工具。抓包观察的是从搜索结果页面列表文章点击跳转到文章页面的过程,这里点击文章超链接会在新窗口打开,我们只需要在网页源码中把对应a标签的target属性改为空,就可以在一个窗口中观察整个流程的数据包了。
流程二:抓包分析之跳转实现
抓包分析:

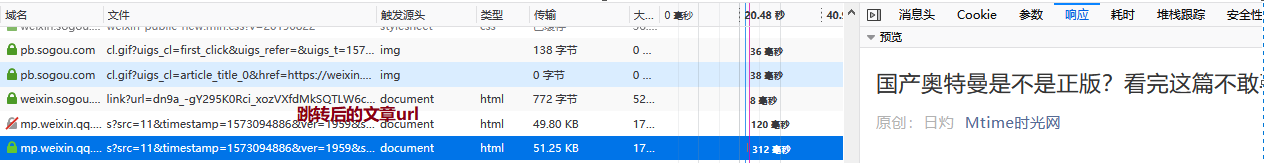
通过抓包我们可以找到搜索结果页面跳转到文章页面的过程,这里观察发现,“列表页面的文章url”返回的结果中就包含了“真实的文章url”的信息,这意味着我们只需要正确访问到“列表页面的文章url”,根据返回的数据就能拼接出“真实的文章url”并访问了,这样我们就实现从“列表页面的文章url”到“真实的文章url”的跳转了!
流程三:抓包分析之手动获取的“列表页面的文章url”无法访问分析
此时我们的目标就从获取“真实的文章url”转变到正确的访问“列表页面的文章url”了,继续分析抓包数据中的“列表页面的文章url”信息:
抓包数据:

  url:https://weixin.sogou.com/link?url=dn9a_-gY295K0Rci_xozVXfdMkSQTLW6cwJThYulHEtVjXrGTiVgSwqn5HZrcjUNEnNekGBXt9LMduzuCU92ulqXa8Fplpd9CqUiLuEm9hLLvBiu5ziMS196rgHYb-GzQfleG917OgwN_VAAdAZHKryCeU9lIxtWTKnLsDcsuPIjLhLEK3tbGaBLLLEV3E0vo604DcwbvX2VNudQZNnBemevd34BJP94ZL5zUiA49LgzIjRlpGxccVxTTaLhHZKstaeqw41upSVAe0f8bRARvQ..&type=2&query=%E5%92%B8%E8%9B%8B%E8%B6%85%E4%BA%BA&k=60&h=U

  method:GET

  请求参数:{"url":"dn9a_-gY295K0Rci_xozVXfdMkSQTLW6cwJThYulHEtVjXrGTiVgSwqn5HZrcjUNEnNekGBXt9LMduzuCU92ulqXa8Fplpd9CqUiLuEm9hLLvBiu5ziMS196rgHYb-GzQfleG917OgwN_VAAdAZHKryCeU9lIxtWTKnLsDcsuPIjLhLEK3tbGaBLLLEV3E0vo604DcwbvX2VNudQZNnBemevd34BJP94ZL5zUiA49LgzIjRlpGxccVxTTaLhHZKstaeqw41upSVAe0f8bRARvQ..","type":"2","query":"咸蛋超人","k":"60","h":"U"}

  headers:

    Host: weixin.sogou.com

    User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:70.0) Gecko/20100101 Firefox/70.0

    Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8

    Accept-Language: zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2

    Accept-Encoding: gzip, deflate, br

    Connection: keep-alive

    Referer: https://weixin.sogou.com/weixin?type=2&query=%E5%92%B8%E8%9B%8B%E8%B6%85%E4%BA%BA&ie=utf8&s_from=input&_sug_=n&_sug_type_=1&w=01015002&oq=&ri=1&sourceid=sugg&sut=750912&sst0=1573092594229&lkt=0%2C0%2C0&p=40040108

    Cookie: 见下

  Cookie:{"ABTEST":"4|1573094886|v1","IPLOC":"CN4401","JSESSIONID":"aaa3VBk4eXnIf8d4bdx4w","SNUID":"57A28ED20A0F9FB2BBE3E0180AF00D25","SUID":"5EAB87DB2613910A000000005DC385E6","SUV":"00F221C2DB87AB5E5DC385E7BC43F633"}
这里的重点有三个:
- 请求参数:对比我们获取的“列表页面的文章url”分析可以发现,这里多了两个参数“k”、“h”,这是需要我们设法获取的。
- headers:经过测试该网站对User-Agent敏感,一次访问前后User-Agent需要一致。
- Cookie:Cookie中参数需要获取才能正确访问该url。这些参数分别是:ABTEST、IPLOC、JSESSIONID、SNUID、SUID、SUV。
3.1:获取参数“k”、“h”
按照经验,从一个url转变成另一个url有两种情况:跳转和javascript字符串处理。经过多次抓包分析发现,搜索结果页面点击文章超链接到我们现在的目标url并没有存在跳转情况,抓包数据中的“列表页面的文章url”和我们获取的“列表页面的文章url”可以判定为同一个url,所以猜测为javascript字符串处理。经过一番搜寻,发现搜索结果页面的源码中有一段非常可疑的代码:
<script>

    (function(){$("a").on("mousedown click contextmenu",function(){var b=Math.floor(100*Math.random())+1,a=this.href.indexOf("url="),c=this.href.indexOf("&k=");-1!==a&&-1===c&&(a=this.href.substr(a+4+parseInt("21")+b,1),this.href+="&k="+b+"&h="+a)})})();

</script>
这其中最重要的代码就是:this.href+="&k="+b+"&h="+a,这代码就是在点击事件发生时给a标签href属性的内容添加"&k="、"&h=",正是用这段代码对该url的参数进行js加密和添加的。我们只需要把这段代码用python实现就可以解决这个问题了,下面是实现python实现代码:
def get_k_h(url):
  b = int(random.random() * 100) + 1

   a = url.find("url=")

   url = url + "&k=" + str(b) + "&h=" + url[a + 4 + 21 + b: a + 4 + 21 + b + 1]
  reuturn url
3.2:获取Cookie的参数
观察抓包数据可以发现,当我们一开始访问时并没有带任何cookie,但经过一系列请求,到我们的目标请求时候,浏览器已经通过前面请求的返回数据包的Set-Cookie属性把Cookie构造出来了,而我们要做的就是在Cookie构造从无到有这个过程中找到所有ResponseHeaders中带SetCookie属性的而且参数是我们需要的参数的请求,并模拟访问一遍,就能得到所有参数并构建出我们需要的Cookie了。
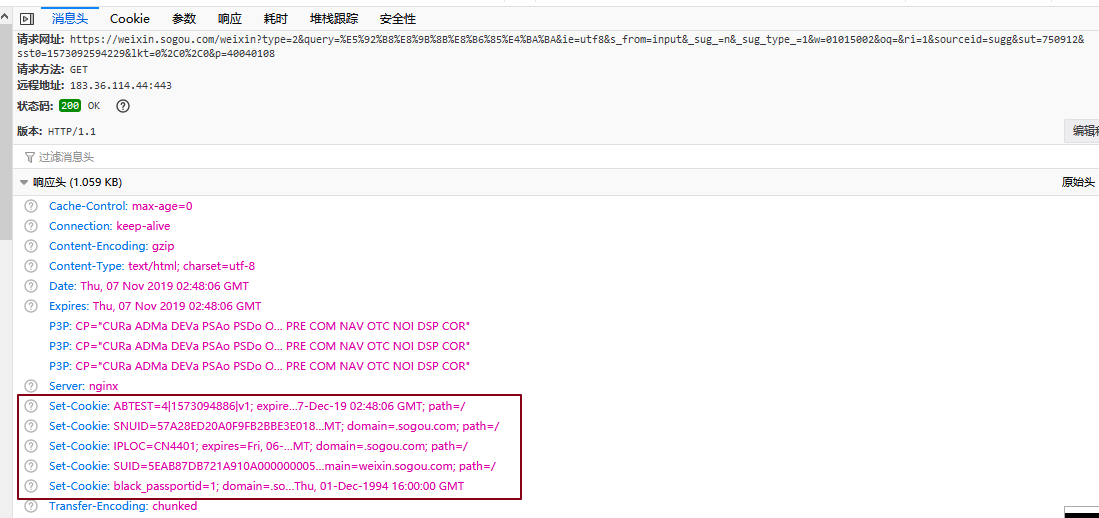
例如搜狗微信搜索接口的请求的ResponseHeaders就有5个Set-Cookie字段,其中ABTEST、SNUID、IPLOC、SUID都是我们最终构造Cookie所需的参数(和最后的Cookie值对比可以发现,这里的SUID值还不是我们最终需要的,要在后面的数据包中继续发掘)。
经过分析,经过四个请求获取到的ResponseHeaders后我们就能正确构建Cookie了:
1. 得到ABTEST、SNUID、IPLOC、SUID:
  https://weixin.sogou.com/weixin?type=2&query=%E5%92%B8%E8%9B%8B%E8%B6%85%E4%BA%BA&ie=utf8&s_from=input&_sug_=n&_sug_type_=1&w=01015002&oq=&ri=1&sourceid=sugg&sut=750912&sst0=1573092594229&lkt=0%2C0%2C0&p=40040108
2. 需要IPLOC、SNUID,得到SUID:
  https://www.sogou.com/sug/css/m3.min.v.7.css
3. 需要ABTEST、IPLOC、SNUID、SUID,得到JSESSIONID:
  https://weixin.sogou.com/websearch/wexinurlenc_sogou_profile.jsp
4. 需要IPLOC、SNUID、SUID,得到SUV
  https://pb.sogou.com/pv.gif
这四个请求都能根据前面请求获取到的Cookie参数来构造自己需要的Cookie去正确访问。值得注意的是最后一个请求,除了需要正确拼接Cookie外,还需要获取正确的请求参数才能正常访问:
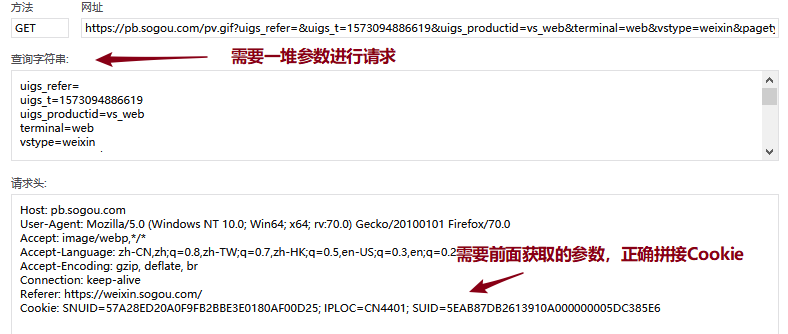
这种找参数的活可以利用浏览器的全局搜索功能,一番搜寻后,就会发现在搜索结果页面的源代码中已经返回了这里所需的所有参数,用正则把这些参数解析出来即可:
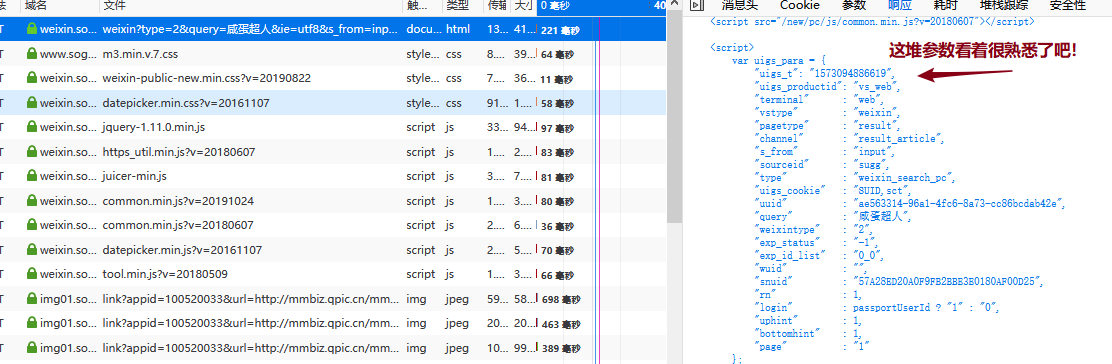
那么根据这些解析出来的参数和前面三个请求得到的Cookie参数就能正确访问第四个请求并得到所需的所有Cookie参数啦!
流程四:构造正确的请求信息
此时,我们已经分析出所有正确模拟请求的流程了,梳理一下:
- 获取“k”、“h”参数,传入搜索结果页面得到的“列表页面的文章ur”,调用get_k_h()即可。
- 获取所需Cookie参数,构造正确的Cookie,按照流程三给出的4个url,分别构造请求获取ResponseHeaders中的SetCookie即可。
- 构造正确的请求访问“列表页面的文章url”。
- 根据3中请求返回的数据,拼接出“真实的文章url”,也就是流程二。
- 请求“真实的文章url”,得到真正的文章页面数据。
至此,所有分析结束,可以愉快的码代码啦!
结语:此次采集涉及到的反爬技术是Cookie构造和简答的js加密,难度不大,最重要的是耐心和细心。此外提醒各位看客大人遵循爬虫道德,不要对他人网站造成伤害,peace!
搜狗微信采集 —— python爬虫系列一的更多相关文章
- python 爬虫系列教程方法总结及推荐
爬虫,是我学习的比较多的,也是比较了解的.打算写一个系列教程,网上搜罗一下,感觉别人写的已经很好了,我没必要重复造轮子了. 爬虫不过就是访问一个页面然后用一些匹配方式把自己需要的东西摘出来. 而访问页 ...
- $python爬虫系列(2)—— requests和BeautifulSoup库的基本用法
本文主要介绍python爬虫的两大利器:requests和BeautifulSoup库的基本用法. 1. 安装requests和BeautifulSoup库 可以通过3种方式安装: easy_inst ...
- Python爬虫系列 - 初探:爬取旅游评论
Python爬虫目前是基于requests包,下面是该包的文档,查一些资料还是比较方便. http://docs.python-requests.org/en/master/ POST发送内容格式 爬 ...
- python爬虫系列(2)—— requests和BeautifulSoup
本文主要介绍python爬虫的两大利器:requests和BeautifulSoup库的基本用法. 1. 安装requests和BeautifulSoup库 可以通过3种方式安装: easy_inst ...
- Python爬虫系列(七):提高解析效率
如果仅仅因为想要查找文档中的<a>标签而将整片文档进行解析,实在是浪费内存和时间.最快的方法是从一开始就把<a>标签以外的东西都忽略掉. SoupStrainer 类可以定义文 ...
- 【数量技术宅 | Python爬虫系列分享】实时监控股市重大公告的Python爬虫
实时监控股市重大公告的Python爬虫小技巧 精力有限的我们,如何更加有效率地监控信息? 很多时候特别是交易时,我们需要想办法监控一些信息,比如股市的公告.如果现有的软件没有办法实现我们的需求,那么就 ...
- Python爬虫系列(三):requests高级耍法
昨天,我们更多的讨论了request的基础API,让我们对它有了基础的认知.学会上一课程,我们已经能写点基本的爬虫了.但是还不够,因为,很多站点是需要登录的,在站点的各个请求之间,是需要保持回话状态的 ...
- Python爬虫系列(一):从零开始,安装环境
在上一个系列,我们学会使用rabbitmq.本来接着是把公司的celery分享出来,但是定睛一看,celery4.0已经不再支持Windows.公司也逐步放弃了服役多年的celery项目.恰好,公司找 ...
- python爬虫系列之初识爬虫
前言 我们这里主要是利用requests模块和bs4模块进行简单的爬虫的讲解,让大家可以对爬虫有了初步的认识,我们通过爬几个简单网站,让大家循序渐进的掌握爬虫的基础知识,做网络爬虫还是需要基本的前端的 ...
随机推荐
- Linux集群之间配置NTP时间同步ntp
NTP时间同步 注意事项 要注意的是,ntpd 有一个自我保护设置: 如果本机与上源时间相差太大, ntpd 不运行. 所以新设置的时间服务器一定要先 ntpdate 从上源取得时间初值, 然后启动 ...
- 修改Docker0网桥默认网段
Docker--修改Docker0网桥默认网段 修改文件 /etc/docker/daemon.json 添加内容 "bip": "ip/netmask" [ ...
- Oracle 查看 impdp 正在执行的内容
1. 今天进行数据库备份恢复 一直卡住 找了一下 公司另外一个部门的方神提供了一个方法连查看 具体在做什么操作: 2. 现象. impdp 到一个地方直接卡住不动 具体位置 view 这个地方足足卡 ...
- 详解Vue 如何监听Array的变化
详解Vue 如何监听Array的变化:https://www.jb51.net/article/162584.htm
- springboot笔记-thymeleaf
简介:Thymeleaf 是⾯向 Web 和独⽴环境的现代服务器端 Java 模板引擎,能够处理 HTML.XML.JavaScript.CSS 甚至纯文本.Thymeleaf 的作用域在 HTML ...
- 洛谷 P1972 HH的项链 题解
题面 本题其实主要就这几点: 1.离线,以右端点排序(从小到大); 2.建立树状数组c[],c[i]表示从1~i中有多少种不同的数字: 3.对于每次查询的答案就是sum(r)-sum(l-1); 4. ...
- C++中的数据类模板
1,预备知识: 1,模板参数可以是数值型参数(非类型参数): 1,代码示例: template <typename T, int N> void func() { T a[N]; // 使 ...
- go相关资料
1.go的调度2.go struct能不能比较 因为是强类型语言,所以不同类型的结构不能作比较,但是同一类型的实例值是可以比较的,实例不可以比较,因为是指针类型 3.go defer(for defe ...
- Linux学习--第十一天--source、环境变量目录、欢迎信息、正则、cut、awk、sed、sort、判断表达式、if、for、case、一些脚本
source source /root/.bashrc #让修改后的配置文件在不重启系统的情况下生效.source等同于. 环境变量目录 /etc/profile /etc/profile.d/*.s ...
- adb shell命令模拟按键/输入input使用keycode 列表详解
在adb shell里有一个非常使用的命令,模拟按键输入,这里首先不要理解为是键盘的模拟按键,下面命令的使用和键值做一个详解. input命令格式 adb shell input keyevent & ...