
kettle大数据量读写mysql性能优化
修改kettleDB连接设置
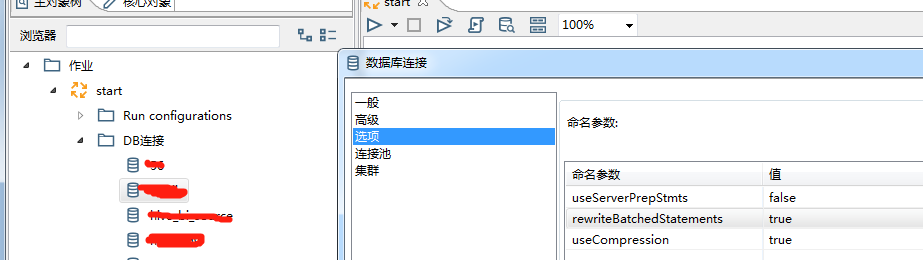
1. 增加批量写的速度:
useServerPrepStmts=false
rewriteBatchedStatements=true
useCompression=true
2. 增加读的速度:
useServerPrepStmts=true
cachePrepStmts=true
参数说明:
1)useCompression=true,压缩数据传输,优化客户端和MySQL服务器之间的通信性能。
2)rewriteBatchedStatements=true ,开启批量写功能
将会使大批量单条插入语句:
INSERT INTO t (c1,c2) VALUES ('One',1);
INSERT INTO t (c1,c2) VALUES ('Two',2);
INSERT INTO t (c1,c2) VALUES ('Three',3);
改写成真正的批量插入语句:
INSERT INTO t (c1,c2) VALUES ('One',1),('Two',2),('Three',3);
3)useServerPrepStmts=false 关闭服务器端编译,sql语句在客户端编译好再发送给服务器端,发送语句如上。
如果为true,sql会采用占位符方式发送到服务器端,在服务器端再组装sql语句。
占位符方式:INSERT INTO t (c1,c2) VALUES (?,?),(?,?),(?,?);
此方式就会产生一个问题,当列数*提交记录数>65535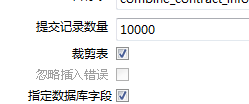
时就会报错:Prepared statement contains too many placeholders,
这是由于我把“提交记录数量”设为10000,而要插入记录的表字段有30个,所以要进行批量插入时需要30*10000=300000 > 65535 ,故而报错。
解决方案:
方案1:把DB连接中的 rewriteBatchedStatements 给设置为false(或者去掉),不过这个操作会影响数据的插入速度。
方案2:更改表输出的设计。确保30个输出字段的和提交记录数量的乘积不超过65535。比如把提交记录数量由10000更改为450(30*2000=60000< 65535)
当然我们的目的是为了提高数据库写速度,所以当rewriteBatchedStatements =true时useServerPrepStmts=false必须配合使用。
mysql参数调优可以参考如下文档
https://dev.mysql.com/doc/connectors/en/connector-j-reference-configuration-properties.html
数据丢失问题:
性能提升后,遇到另外个问题,86万数据丢失了130多条,kettle无报错,各种mysql参数设置之后都无效果,耗时近一天,最终查到是重复数据导致。
估计是因为重复数据在mysql写不进去导致该批次数据写失败,但是kettle无报错这个就比较坑。
解决办法就是:1)取消数据表主键或者唯一索引 ,当然这是治标不治本的做法。2)根本的做法就是排查重复数据,从源头杜绝重复数据
参考文档:
https://blog.csdn.net/smooth00/article/details/69389424?utm_source=itdadao&utm_medium=referral
http://www.jackieathome.net/archives/169.html
kettle大数据量读写mysql性能优化的更多相关文章
- 大数据量时Mysql的优化
(转自网络) 如今随着互联网的发展,数据的量级也是撑指数的增长,从GB到TB到PB.对数据的各种操作也是愈加的困难,传统的关系性数据库已经无法满足快速查询与插入数据的需求.这个时候NoSQL的出现暂时 ...
- spring Batch实现数据库大数据量读写
spring Batch实现数据库大数据量读写 博客分类: spring springBatchquartz定时调度批处理 1. data-source-context.xml <?xml v ...
- 大数据量数据库设计与优化方案(SQL优化)
转自:http://blog.sina.com.cn/s/blog_6c0541d50102wxen.html 一.数据库结构的设计 如果不能设计一个合理的数据库模型,不仅会增加客户端和服务器段程序的 ...
- java excel大数据量导入导出与优化
package com.hundsun.ta.utils; import java.io.File; import java.io.FileOutputStream; import java.io.I ...
- 总结MySQL大数据量下如何进行优化
写在建库前: 在确定数据库业务后.建立数据库表格时,就应对一些常见问题有所考虑,以避免在数据增长一段时间后再做应对,可能造成时间及维护成本增加: 数据的月增量,年增量 数据的快速增长点 是否需要触发器 ...
- 大数据量时 Mysql LIMIT如何正确对其进行优化(转载)
以下的文章主要是对Mysql LIMIT简单介绍,我们大家都知道LIMIT子句一般是用来限制SELECT语句返回的实际行数.LIMIT取1个或是2个数字参数,如果给定的是2个参数,第一个指定要返回的第 ...
- 大数据量下MySQL插入方法的性能比较
不管是日常业务数据处理中,还是数据库的导入导出,都可能遇到需要处理大量数据的插入.插入的方式和数据库引擎都会对插入速度造成影响,这篇文章旨在从理论和实践上对各种方法进行分析和比较,方便以后应用中插入方 ...
- 一文总结高并发大数据量下MySQL开发规范【军规】
在互联网公司中,MySQL是使用最多的数据库,那么在并发量大.数据量大的互联网业务中,如果高效的使用MySQL才能保证服务的稳定呢?根据本人多年运维管理经验的总结,梳理了一些核心的开发规范,希望能给大 ...
- JAVA JDBC大数据量导入Mysql
转自https://blog.csdn.net/q6834850/article/details/73726707?tdsourcetag=s_pctim_aiomsg 采用JDBC批处理(开启事务. ...
随机推荐
- 第三视角Beta答辩总结
第三视角Beta答辩总结 博客链接以及团队信息 组长博客链接 成员信息(按拼音排序) 姓名 学号 备注 张扬 031602345 组长 陈加伟 031602204 郭俊彦 031602213 洪泽波 ...
- linux基本网络配置
-- linux基本网络配置管理 rhel6开始有一个networkmanger的网络配置服务(可以图形配置网络,拔号,无线连接,vpn等)但此服务开启会造成你的ip不固定(会dhcp获取),而且后期 ...
- Java容器解析系列(6) Queue Deque AbstractQueue 详解
首先我们来看一下Queue接口: /** * @since 1.5 */ public interface Queue<E> extends Collection<E> { / ...
- nginx下运行php的程序时返回200访问却是空白页问题的解决方法
由于nginx与php-fpm之间的一个小bug,会导致这样的现象: 网站中的静态页面 *.html 都能正常访问,而 *.php 文件虽然会返回200状态码, 但实际输出给浏览器的页面内容却是空白. ...
- angular5理解生命周期
先来看下文档: 按照顺序有八个: 1.ngOnChanges()=>简单理解为当数据绑定输入属性的值发生变化时调用: 2.ngOnInit() => 在调用完构造函数.初始化完所有输入属性 ...
- Beta周王者荣耀交流协会第四次Scrum会议
1.立会照片 成员王超,高远博,冉华,王磊,王玉玲,任思佳,袁玥全部到齐. master:任思佳 2.时间跨度: 2017年11月13日 11:40 — 12:10 ,总计30分钟. 3.地点: 一食 ...
- 有人WIFI ble101配置
新买来的模块,默认为slave模式,波特率57600,8位数据位,无检验位,1位停止位. 发送+++a,进入命令模式. 需要加回车符 1.设置模块名称 AT+NAME=BT_Shining 2.设置发 ...
- 解决插值表达式闪烁问题 - v-cloak
v-cloak页面在js没有加载出来的时候,不显示该部分 linux可以通过响应式设计模式,来模拟2,3G网络 <!DOCTYPE html><html><head> ...
- 11.python描述符---类的装饰器---@property
描述符1.描述符是什么:描述符本质就是一个新式类,在这个新式类中,至少实现了__get__(),__set__(),__delete__()这三个内置方法中的一个,描述符也被称为描述符协议(1):__ ...
- PTA寒假三
抓老鼠啊~亏了还是赚了? (20 分) 某地老鼠成灾,现悬赏抓老鼠,每抓到一只奖励10元,于是开始跟老鼠斗智斗勇:每天在墙角可选择以下三个操作:放置一个带有一块奶酪的捕鼠夹(T),或者放置一块奶酪(C ...