
Python - 模块(一)
Python - 模块(一)
模块的引用方式
- import 语句
执行对应文件
引入变量名
import time #导入时间模块,也可以同时导入多个模块,用逗号隔开
from ... import 模块名
from my_model import main
from ... import *
引入一切,即导入模块中所有的项目,不推荐使用。因为引入的其它来源的命名,很可能覆盖了已有的定义。
常用模块
### time ###
时间相关的操作, 时间有三种表示方法:
时间戳(timestamp): 时间戳使用的是从1970年1月1日00点00分00秒得到现在一共经过了多少秒..用float表示.
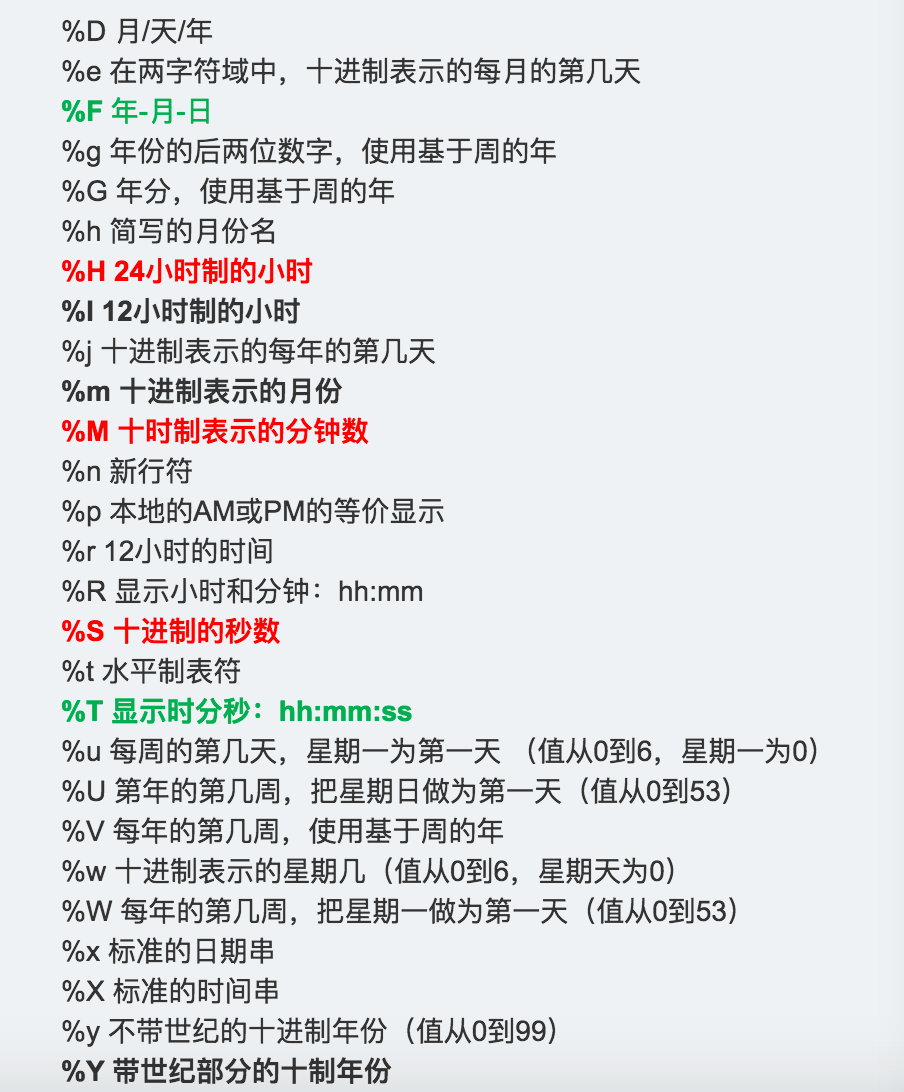
格式化的字符串(strftime): 这个时间可以根据我们的需要对时间进行任意的格式化.
结构化时间(struct_time): 这个时间主要可以把时间进行分类规划,比如,1970年01月01日 00点00分00秒 这个时间可以被细分为年,月,日..
生成时间戳
1. time.time()

输出 1515137389.69163
生成格式化的时间字符串
1. time.ctime()

输出 Fri Jan  5 15:34:00 2018

=============================

2. time.strftime("%Y-%m-%d %H:%M:%S")

输出 2018-01-05 15:34:27

========================
生成结构化时间
1. time.gmtime()

输出 time.struct_time(tm_year=2018, tm_mon=1, tm_mday=5, tm_hour=7, tm_min=34, tm_sec=57, tm_wday=4, tm_yday=5, tm_isdst=0)

===========================================================================================================================

2. time.localtime()

输出 time.struct_time(tm_year=2018, tm_mon=1, tm_mday=5, tm_hour=15, tm_min=35, tm_sec=59, tm_wday=4, tm_yday=5, tm_isdst=0)

============================================================================================================================
时间戳转格式化时间
t = time.localtime(188888888)	# 结构化时间

s = time.strftime("%Y-%m-%d %H:%M:%S", t)	# 格式化这个时间

print(s)
格式化时间转化为时间戳
s = "2020-10-01 12:18:12"

t = time.strptime(s, "%Y-%m-%d %H:%M:%S")	# 转化成结构化时间

print(time.mktime(t))	# 转化成时间戳
计算时间差
import time

ture_time=time.mktime(time.strptime('2017-09-11 08:30:00'), "%Y-%m-%d %H:%M:%S")

time_now=time.mktime(time.strptime('2017-11-11 08:30:00'), "%Y-%m-%d %H:%M:%S")

dif_time=time_now-treu_time

stuct_time=time.localtime(dif_time)
datetime
import datetime

'''

datetime.date:表示日期的类。常用的属性有year, month, day

datetime.time:表示时间的类。常用的属性有hour, minute, second, microsecond

datetime.datetime:表示日期时间

datetime.timedelta:表示时间间隔,即两个时间点之间的长度

timedelta([days[, seconds[, microseconds[, milliseconds[, minutes[, hours[, weeks]]]]]]])

strftime("%Y-%m-%d")

'''

import datetime

print datetime.datetime.now()

print datetime.datetime.now() - datetime.timedelta(days=5)
random(随机模块)
import random

print(random.random())         # 0到1的随机浮点数

print(random.randint(1,3))     # 整形 闭区间 [1,3]

print(random.randrange(1,3))   # 整形,开区间 [1,3)

li = [11,22,33,44,55]

print(random.choice(li))       # 基于可迭代对象随机

print(random.sample(li,2))     # 随机选定多个

print(random.uniform(1,2))     # 任意范围的浮点型

random.shuffle(li)             # 随机打乱次序

print(li)
通过随机模块制作随机验证码
def v_code():

	checkcode = ''  # 定义一个空字符串

	for i in range(4): # 遍历四次

		num = random.randint(0,9) # 随机选择0到9

		alf = chr(random.randint(65,90)) # 随机选择chr对应的字母

		add = random.choise([num, alf]) # 基于上面的可迭代对象选择一个

		checkcode += str(add) # 将他们变成字符串,加到空字符串里面

	return checkcode

if __name__ == "__main__":

	print(v_code())
os模块
用于提供系统级别的操作
os.getcwd()                 获取当前工作目录,即当前python脚本工作的目录路径

os.chdir("dirname")         改变当前脚本工作目录;相当于shell下cd

os.curdir                   返回当前目录: ('.')

os.pardir                   获取当前目录的父目录字符串名:('..')

os.makedirs('dir1/dir2')    可生成多层递归目录

os.removedirs('dirname1')   若目录为空,则删除,并递归到上一级目录,如若也为空,则删除,依此类推

os.mkdir('dirname')         生成单级目录;相当于shell中mkdir dirname

os.rmdir('dirname')         删除单级空目录,若目录不为空则无法删除,报错;相当于shell中rmdir dirname

os.listdir('dirname')       列出指定目录下的所有文件和子目录,包括隐藏文件,并以列表方式打印 ***

os.remove()                 删除一个文件

os.rename("oldname","new")  重命名文件/目录 ***

os.stat('path/filename')    获取文件/目录信息,相关信息的介绍 size 文件大小 atime 上次访问时间 mtime 上次修改时间 ctime 查看创建时间

os.sep                      操作系统特定的路径分隔符,win下为"\\",Linux下为"/"

os.linesep                  当前平台使用的行终止符,win下为"\t\n",Linux下为"\n"

os.pathsep                  用于分割文件路径的字符串

os.name                     字符串指示当前使用平台。win->'nt'; Linux->'posix'

os.system("bash command")   运行shell命令,直接显示

os.environ                  获取系统环境变量

os.path.abspath(path)       返回path规范化的绝对路径

os.path.split(path)         将path分割成目录和文件名二元组返回

os.path.dirname(path)       返回path的目录。其实就是os.path.split(path)的第一个元素

os.path.basename(path)      返回path最后的文件名。如何path以/或\结尾,那么就会返回空值。即os.path.split(path)的第二个元素

os.path.exists(path)        如果path存在,返回True;如果path不存在,返回False

os.path.isabs(path)         如果path是绝对路径,返回True

os.path.isfile(path)        如果path是一个存在的文件,返回True。否则返回False

os.path.isdir(path)         如果path是一个存在的目录,则返回True。否则返回False

os.path.join(path1[, path2[, ...]])  将多个路径组合后返回,第一个绝对路径之前的参数将被忽略,涉及文件路径拼接就用它

os.path.getatime(path)      返回path所指向的文件或者目录的最后存取时间

os.path.getmtime(path)      返回path所指向的文件或者目录的最后修改时间
sys
提供对Python解释器相关的操作
sys.argv           命令行参数List,第一个元素是程序本身路径  *****

sys.exit(n)        退出程序,正常退出时exit(0)

sys.version        获取Python解释程序的版本信息

sys.maxint         最大的Int值

sys.path           返回模块的搜索路径,初始化时使用PYTHONPATH环境变量的值

sys.platform       返回操作系统平台名称

sys.stdin          输入相关

sys.stdout         输出相关

sys.stderror       错误相关
简单的进度条
	import sys

import time

def view_bar(num, total):

    rate = float(num) / float(total)

    rate_num = int(rate * 100)

    r = '\r%d%%' % (rate_num, )

    sys.stdout.write(r)

    sys.stdout.flush()

if __name__ == '__main__':

    for i in range(0, 101):

        time.sleep(0.1)

        view_bar(i, 100)

# 未研究

import sys

import time

for i in range(10):

    sys.stdout.write("#")

    sys.stdout.flush()

    time.sleep(1)
序列化模块
这两个也都是用于序列化的模块, 古老的程序员都用json
json: 用于【字符串】和 【python基本数据类型】 间进行转换,
(数据交互),可以进行多种语言的数据交互
pickle: 用于【python特有的类型】 和 【python基本数据类型】间进行转换
json用法
import json
字典 -> 字符串 系列化
 dic = {"a":"模特", "b":"萝莉", "c": "小清新"}

 json.dumps(dic, ensure_ascii=False)
字符串 -> 字典 反序列化
 str = {"a":"模特", "b":"萝莉", "c": "小清新"}

 json .loads(str)
把序列化的结果写入到文件中
 dic = {"a":"模特", "b":"萝莉", "c": "小清新"}

 f = open("test.json", mode="w", encoding="utf-8")

 json.dump(dic, f, ensure_ascii=False) # 把对象打散成json写入到文件中

 f.close()
从文件件中读取一个json
f = open("test.json", mode="w", encoding="utf-8")
dic = json.load(f)
f.close()
pickle用法
import pickle                # 和json的方法的相同,序列化对象

dic = {"name":"alex"}

# data = pickle.dumps(dic)   # 转化为字节类型

# print(data)                # ---><class 'bytes'>

f = open("hello","wb")

f.write(pickle.dumps(dic))   #

f.close()

f = open("hello","rb")      # 反序列化

data = pickle.loads(f.read())# 相当于data = pickle.load(f)

print(data)

f.close()
shelve
shelve模块比pickle模块简单,只有一个open函数,返回类似字典的对象,可读可写;key必须为字符串,而值可以是python所支持的数据类型,会生成三个文件
import shelve

f = shelve.open(r'shelve.txt')

# f['stu1_info']={'name':'alex','age':'18'}

# f['stu2_info']={'name':'alvin','age':'20'}

# f['school_info']={'website':'oldboyedu.com','city':'beijing'}

#

#

# f.close()

print(f.get('stu_info')['age'])k
hashlib
用于加密相关的操作,代替了md5模块和sha模块,主要提供 SHA1, SHA224, SHA256, SHA384, SHA512 ,MD5 算法
import hashlib

hash = hashlib.md5(bytes("bingdu",encoding="utf8")) # 创建md5对象,并额外加密

hash.update(bytes("123",encoding="utf8")) # 对字符串加密

print(hash.hexdigest()) # 取到密文
subprocess
可以执行shell命令的相关模块和函数有
- os.system
- os.spawn*
- os.popen* —废弃
- popen2.* —废弃
- commands.* —废弃,3.x中被移除
以上执行shell命令的相关的模块和函数的功能均在 subprocess 模块中实现,并提供了更丰富的功能。
subprocess.Popen(...)
用于执行复杂的系统命令
参数:
args:shell命令,可以是字符串或者序列类型(如:list,元组)
bufsize:指定缓冲。0 无缓冲,1 行缓冲,其他 缓冲区大小,负值 系统缓冲
stdin, stdout, stderr:分别表示程序的标准输入、输出、错误句柄
preexec_fn:只在Unix平台下有效,用于指定一个可执行对象(callable object),它将在子进程运行之前被调用
close_sfs:在windows平台下,如果close_fds被设置为True,则新创建的子进程将不会继承父进程的输入、输出、错误管道。
所以不能将close_fds设置为True同时重定向子进程的标准输入、输出与错误(stdin, stdout, stderr)。shell:同上
cwd:用于设置子进程的当前目录
env:用于指定子进程的环境变量。如果env = None,子进程的环境变量将从父进程中继承。
universal_newlines:不同系统的换行符不同,True -> 同意使用 \n
startupinfo与createionflags只在windows下有效
将被传递给底层的CreateProcess()函数,用于设置子进程的一些属性,如:主窗口的外观,进程的优先级等等shell=True: 指定的命令行会通过shell来执行
stdin : 标准输入
stdout : 标准输出
stderr : 标准错误的文件句柄
PIPE : 管道 ,默认值 为: None, 表示不做重定向,管道可以用来接收数据。
  把标准输出放入管道中,屏幕上就不会输出内容。

  res=subprocess.Popen("dir", shell=True,stdout=subprocess.PIPE,stdin=subprocess.PIPE,stderr=subprocess.PIPE)   #执行dir命令,交给shell解释器执行,通过标准类型和subprocess.PIPE放入管道中。

  >>> res.stdout.read()  #读取管道里面的数据,在程序中,读取也不会输出到屏幕上。

  >>> res.stdout.read()   #再read一次,内容就为空,说明读取完成.

  b''  #显示为:bytes类型
optparse
Python 有两个内建的模块用于处理命令行参数:
一个是 getopt,《Deep in python》一书中也有提到,只能简单处理 命令行参数;
另一个是 optparse,它功能强大,而且易于使用,可以方便地生成标准的、符合Unix/Posix 规范的命令行说明。
简单流程
首先必须导入模块optparse(这个不多说)
import optparse

# 创建OptionParser类对象

parser = optparse.OptionParser()

# 然后,使用add_option来定义命令行参数(伪代码)

# parser.add_option(opt_str, ...

#                   attr= value,...)

# 每个命令行参数就是由参数名字符串和参数属性组成的。如 -f 或者 –file 分别是长短参数名:

parser.add_option("-f","--file",dest = "filename")

# 最后,一旦你已经定义好了所有的命令行参数,调用 parse_args() 来解析程序的命令行:

options,args = parser.parse_args()

注: 你也可以传递一个命令行参数列表到 parse_args();否则,默认使用 sys.argv[:1]。

parse_args() 返回的两个值:

options,它是一个对象(optpars.Values),保存有命令行参数值。只要知道命令行参数名,如 file,就可以访问其对应的值: options.file 。

args,它是一个由 positional arguments 组成的列表。
struct
学习到socket网络编程这里,对struct有了认识,现在对它进行一些阐释,也可以较为有效的解决粘包问题
struct模块作用:解决bytes和其他二进制数据类型的转换
示例用法:
struct.pack('i',12)
参数说明:
pack函数作用:把任意数据类型变成bytes
i 表示4字节无符号整数。
import struct

struct.pack('i',12) # 用方法pack进行打包,把后面的整形数据,封装成一个bytes类型

b'\x0c\x00\x00\x00' # 长度就是4

l=struct.pack('i',12313123)

len(l)

4 #长度就是4
unpack
# 反解

struct.unpack('i',l)

(12313123,)

# 查看类型

l=struct.pack('i',1)

type(l)

<class 'bytes'>  # bytes类型
Python - 模块(一)的更多相关文章
- 使用C/C++写Python模块
最近看开源项目时学习了一下用C/C++写python模块,顺便把学习进行一下总结,废话少说直接开始: 环境:windows.python2.78.VS2010或MingW 1 创建VC工程 (1) 打 ...
- Python模块之configpraser
Python模块之configpraser 一. configpraser简介 用于处理特定格式的文件,其本质还是利用open来操作文件. 配置文件的格式: 使用"[]"内包含 ...
- Python模块之"prettytable"
Python模块之"prettytable" 摘要: Python通过prettytable模块可以将输出内容如表格方式整齐的输出.(对于用Python操作数据库会经常用到) 1. ...
- python 学习第五天,python模块
一,Python的模块导入 1,在写python的模块导入之前,先来讲一些Python中的概念性的问题 (1)模块:用来从逻辑上组织Python代码(变量,函数,类,逻辑:实现一个功能),本质是.py ...
- windows下安装python模块
如何在windows下安装python模块 1. 官网下载安装包,比如(pip : https://pypi.python.org/pypi/pip#downloads) pip-9.0.1.tar. ...
- 安装第三方Python模块,增加InfoPi的健壮性
这3个第三方Python模块是可选的,不安装的话InfoPi也可以运行. 但是如果安装了,会增加InfoPi的健壮性. 目录 1.cchardet 自动检测文本编码 2.lxml 用于解析 ...
- Python基础篇【第5篇】: Python模块基础(一)
模块 简介 在计算机程序的开发过程中,随着程序代码越写越多,在一个文件里代码就会越来越长,越来越不容易维护. 为了编写可维护的代码,我们把很多函数分组,分别放到不同的文件里,这样,每个文件包含的代码就 ...
- python 模块加载
python 模块加载 本文主要介绍python模块加载的过程. module的组成 所有的module都是由对象和对象之间的关系组成. type和object python中所有的东西都是对象,分为 ...
- pycharm安装python模块
这个工具真的好好,真的很喜欢,它很方便,很漂亮,各种好 pycharm安装python模块:file-setting-搜索project inte OK
- Python模块常用的几种安装方式
Python模块安装方法 一.方法1: 单文件模块直接把文件拷贝到 $python_dir/Lib 二.方法2: 多文件模块,带setup.py 下载模块包,进行解压,进入模块文件夹,执行:pytho ...
随机推荐
- oracle 存储过程使用动态sql
Oracle存储过程使用动态SQL 有两种写法:用 DBMS_SQL 或 execute immediate,建议使用后者. DDL和DML (注意DDL中可以用拼接字符串的方法用来create ta ...
- sed 之 模式空间 & 保持空间
模式空间:容纳当前输入行的缓冲区: 保持空间:作为辅助的一个缓冲区,可以和模式空间进行交互,但是命令不能直接作用于保持空间. 由上面定义可以知道,模式空间和保持空间是两个独立的缓冲区,可以进行交互,命 ...
- Execution Order In a Test Plan
1.Config Element 2.Pre Processors 3.Timer 4.Sampler 5.Post Processors 6.Assertions 7.Listener
- 重启标志log
01) fatal error : 如下: [ >.()[:swapper/][name:disp_lcm&][DISP]disp_lcm_probe [ >.()[:swappe ...
- bzoj3663
几何+lis 很巧妙.直接做很困难,那么我们转化一下,把每个点能看见的圆弧画出来.只有这些圆弧相交时才满足条件. 那么也就是找出圆上尽量多两两相交的区间. 所以我们先按左端点极角排序,然后固定一个必须 ...
- bzoj2648
http://www.lydsy.com/JudgeOnline/problem.php?id=2648 kdtree裸题... 抄板子一边抄对了... 挺好理解的,就是说我们先找出中间的元素,然后小 ...
- 02_jni_hello_c函数介绍
介绍NDK平台都有哪些工具.通过NDK这套工具做安卓下的JNI开发. 可能有一些需求更适合通过C去做,有一些功能要通过C去实现.一个安卓程序,它本身还是一个Java应用.有一些功能/方法不通过Java ...
- android api level对应表(copy)
Platform Version API Level VERSION_CODE Notes Android 4.4 19 KITKAT Platform Highlights Android 4.3 ...
- PCB WebAPI跨域访问 实现方式
我们写WebAPI不仅自己系统调用,也需要给其它系统调用,那么如何实现跨域访问了,在这里介绍2种方法实现 方法一.修改Web.Config文件 实现 此方法是全局实现跨域,如果仅想某个方法实现跨域 ...
- codevs地鼠游戏(贪心)
1052 地鼠游戏 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 钻石 Diamond 题目描述 Description 王钢是一名学习成绩优异的学生,在平时的学习中,他 ...