
python爬虫解析库学习
一、xpath库使用:
1、基本规则:
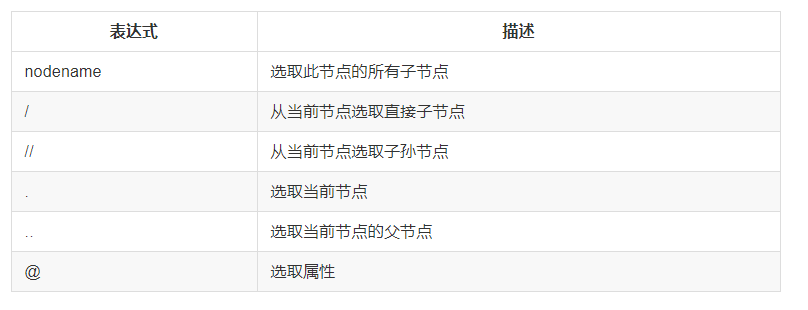
2、将文件转为HTML对象:
 html = etree.parse('./test.html', etree.HTMLParser())

 result = etree.tostring(html)

 print(result.decode('utf-8'))
3、属性多值匹配:
//a[contains(@class,'li')]
4、多属性匹配:
//a[@class="a" and @font="red"]
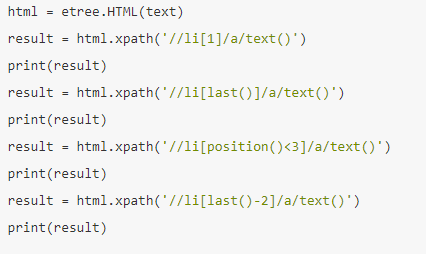
5、按序选择:
二、beautifulsoup库学习:
1、基本初始化:
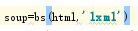
将HTML字符串用lxml格式来解析,并补全标签,创建html处理对象。
2、获取信息:
(1)获取title的name属性:
soup.title.name
(2)获取多属性:
(3)children返回孩子节点:
(4)find_all函数:查找所有的节点。
·通过节点名称来查找:
soup.find_all(name='li')
·通过属性名来查找:
soup.find_all(attrs={'id':'link1'})
··通过文本来查找:
soup.find_all(text='') 用来匹配网页节点中的文本内容。
3、css选择器:
.select() 方法。参数内容和jquery相似。
返回内容为列表,类型是tag类型。
三、pyquery库:
1、初始化:
·通过HTML字符串
·通过url
·通过文件名。需要指出文件名。
2、常用函数:
(1)find() 方法
(2)children()查找子结点
(3)查找父节点: parent()
(4)查找祖先节点:
parents()
(5)兄弟节点:
siblings() 方法
(6)对查找结果进行遍历:
.items()返回每一个节点。
(7) 获取节点信息:
·获取属性:
.attrs(‘属性名’)
python爬虫解析库学习的更多相关文章
- Python 爬虫 解析库的使用 --- XPath
一.使用XPath XPath ,全称XML Path Language,即XML路径语言,它是一门在XML文档中查找信息的语言.它最初是用来搜寻XML文档的,但是它同样适用于HTML文档的搜索. 所 ...
- Python 爬虫 解析库的使用 --- Beautiful Soup
知道了正则表达式的相关用法,但是一旦正则表达式写的有问题,得到的可能就不是我们想要的结果了.而且对于一个网页来说,都有一定的特殊结构和层级关系,而且有很多节点都有id或class来做区分,所以借助它们 ...
- python爬虫解析库之Beautifulsoup模块
一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会 ...
- python爬虫解析库之re模块
re模块 一:什么是正则? 正则就是用一些具有特殊含义的符号组合到一起(称为正则表达式)来描述字符或者字符串的方法.或者说:正则就是用来描述一类事物的规则.(在Python中)它内嵌在Python中, ...
- python爬虫---selenium库的用法
python爬虫---selenium库的用法 selenium是一个自动化测试工具,支持Firefox,Chrome等众多浏览器 在爬虫中的应用主要是用来解决JS渲染的问题. 1.使用前需要安装这个 ...
- Python爬虫Urllib库的高级用法
Python爬虫Urllib库的高级用法 设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Head ...
- Python网页解析库:用requests-html爬取网页
Python网页解析库:用requests-html爬取网页 1. 开始 Python 中可以进行网页解析的库有很多,常见的有 BeautifulSoup 和 lxml 等.在网上玩爬虫的文章通常都是 ...
- Python爬虫Urllib库的基本使用
Python爬虫Urllib库的基本使用 深入理解urllib.urllib2及requests 请访问: http://www.mamicode.com/info-detail-1224080.h ...
- Python爬虫—requests库get和post方法使用
目录 Python爬虫-requests库get和post方法使用 1. 安装requests库 2.requests.get()方法使用 3.requests.post()方法使用-构造formda ...
随机推荐
- css小demo
span{ color: #ccc; float: right; font-weight: bold; display: inline-block; border-right: solid 1px # ...
- Angular 过滤器
<!DOCTYPE html><html ng-app="myApp"><head lang="en"> <meta ...
- centos 6.5 查看时区和设置时区
centos6.x 和centos7.x在时区方面有点差距,本文是针对centos6.x进行介绍. 其实在我的一个博文里,在安装系统的时候就可以进行时区的设置,本文介绍的是用命令进行时区查看和设置. ...
- png8、16、24、32位的区别
我们都知道一张图片可以保存为很多种不同的格式,比如bmp/png/jpeg/gif等等.这个是从文件格式的角度看,我们抛开文件格式,看图片本身,我们可以分为8位, 16位, 24位, 32位等. 单击 ...
- 为linux主机增加file description
在benchmarked写的服务器的时候就遇到了too many file open 这个报错. 由于遇到过很多次了,所以知道应该是单机fd打满了. 首先来看看 机器最多支持多少fd cat /pro ...
- javascript中 json数据的解析与序列化
首先明确一下概念: json格式数据本质上就是字符串: js对象:JavaScript 中的几乎所有事务都是对象:字符串.数字.数组.日期.函数,等等. json数据的解析: 就是把后端传来的json ...
- 使用JAVA获取JSON报文
基本JSON格式: { "name": "liming", "age": "13", "array" ...
- 二、core abp 数据库迁移
一.数据库迁移-ABP(库) 1.配置链接数据库: 贴以下代码: { "ConnectionStrings": { "Default": "Serv ...
- How to remove unwant Explorer Context Menu
HKEY_LOCAL_MACHINE\SOFTWARE\Classes\Folder\shell HKEY_LOCAL_MACHINE\SOFTWARE\Classes\Directory\shell
- hdu—3861(tarjan+二分图)
题意:给你n个城市,每个城市之间有一条有向边,将城市划分为几个区域,问你最小的划分方法, 划分规则为:能相互到达的放在一个区域:然后区域内的a,b两点肯定存在某种方式,使得a能到b或者b能到a(注意, ...