
数据特征分析:1.基础分析概述& 分布分析
基础分析概述
几个基础分析思路:
分布分析

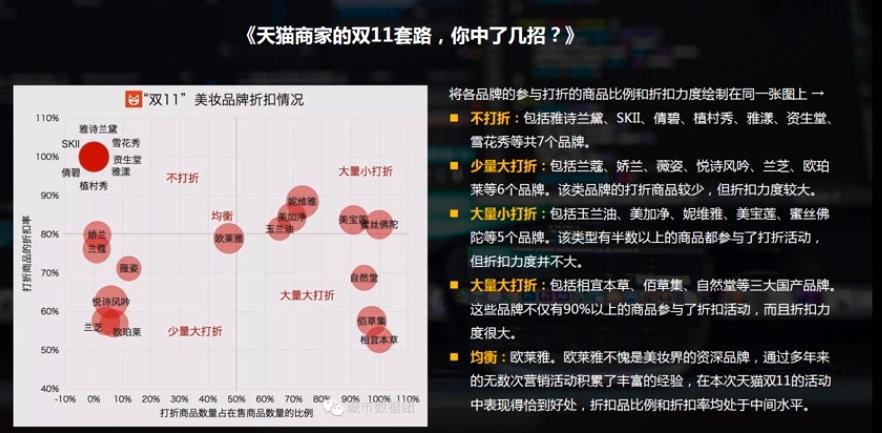
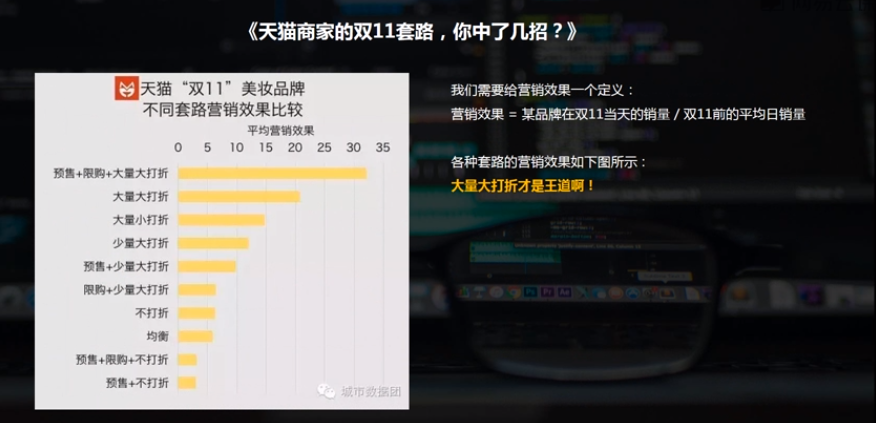
分布分析是研究数据的分布特征和分布类型,分定量数据、定性数据区分基本统计量。
import numpy as np

import pandas as pd

import matplotlib.pyplot as plt

% matplotlib inline
#读取数据

data = pd.read_csv(r'C:\Users\Administrator\Desktop\python数据分析\深圳罗湖二手房信息.csv',

                   engine = 'python')

data.head()

plt.scatter()散点图
plt.scatter(data['经度'], data['纬度'], #做个简单的三角图,按照经纬度作为它的X Y轴

                s = data['房屋单价']/500, #按照房屋的单价来控制图形的大小

                c = data['参考总价'], cmap = 'Reds',#按照参考总价来显示颜色

                alpha = 0.4)        #########plt.scatter()散点图
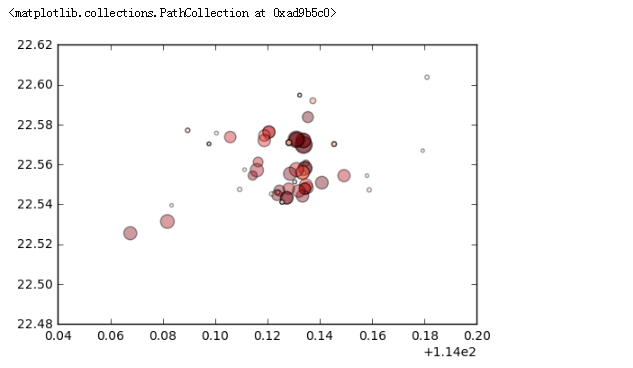
plt.scatter() 散点图
如果有底图就可以把它的位置给分布出来;点越大代表房屋的单价越高,颜色越深代表总价越高;
通过数据可见,一共8个字段
定量字段:房屋单价,参考首付,参考总价,*经度,*纬度,*房屋编码
定性字段:小区,朝向
1.极差
#极差

def d_range(df, *cols):

    krange = [] #空列表,为了保持它的值

    for col in cols:

        crange = df[col].max() - df[col].min()

        krange.append(crange)

    return (krange)  ##创建函数求极差

key1 = "参考总价"

key2 = "参考首付"

dr = d_range(data, key1, key2)

print("%s极差为:%f \n%s极差为:%f"% ( key1, dr[0], key2, dr[1])) #求出数据对应列的极差
参考总价极差为:175.000000

参考首付极差为:52.500000
从极差中看到销售的稳定程度
2. 频率分布情况:定量字段
(① 通过直方图直接判断分组组数)
.hist(bins = 8) 直方图
#频率分布情况(通过直方图直接判断分组组数)

data[key1].hist(bins = 8) #参考总价 简单查看数据分组,确定分组组数 --->>一般8-16组,这里按照8组为参考

可以看出主要集中在160万以上,60万以下。
频率分布的划分方式:直方图可以快速的看到它的排列情况,把它拆分:分组划分
(②求出分组区间)
pd.cut(data[key1], 10, right = False).value_count(sort=True) sort=True <-等价-> ascending=True
#频率分布情况,分组区间 ;对参考总价进行分组。

gcut = pd.cut(data[key1], 10, right = False) #分成10份,是否包含末端值选False

gcut  #type(gcut)-->>Series

gcut_count = gcut.value_counts(sort = False) #做一个统计,不排序

gcut_count
# pd.cut(x, bins, right):按照组数对x分组,且返回一个和x同样长度的分组dataframe,right → 是否右边包含,默认True
# 通过groupby查看不同组的数据频率分布

data['%s分组区间'% key1] = gcut.values

data.head()

(③ 求出目标字段下频率分布的其他统计量 --->>> 频数,频率,累计频率)
分组情况,做累计频率的分组情况
r_zj = pd.DataFrame(gcut_count)

r_zj
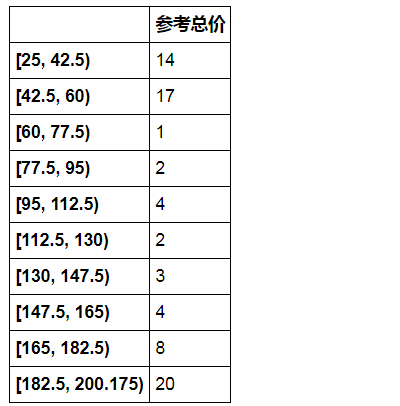
.apply(lambda x:"%.2f%%"% (x*100)) 以百分比显示
.style.bar(subset = ['频率', '累计频率']) 在格子中的条形图
#区间出现频率

r_zj = pd.DataFrame(gcut_count)

r_zj.rename(columns = {gcut_count.name:'频数'}, inplace = True) #重命名下,修改频数字段名

r_zj['频率'] = r_zj['频数']/r_zj['频数'].sum()       #计算频率

r_zj['累计频率'] = r_zj['频率'].cumsum()     #计算累计频率

r_zj['频率%'] = r_zj['频率'].apply(lambda x:"%.2f%%"% (x*100)) #以百分比显示频率

r_zj['累计频率%'] = r_zj['累计频率'].apply(lambda x:"%.2f%%"% (x*100)) #以百分比显示累计频率

r_zj.style.bar(subset = ['频率', '累计频率']) #可视化显示

(④ 绘制频率直方图)
r_zj['频率'].plot(kind = 'bar',figsize = (12, 2),grid = True,color = 'k',alpha = 0.4 ) 直方图
for i, j, k in zip(range(x), y, m): plt.text(i - 0.1, j + 0.01, '%i'% k, color = 'k')
#直方图

r_zj['频率'].plot(kind = 'bar',

                figsize = (12, 2),

                grid = True,

                color = 'k',

                alpha = 0.4 ) #plt.title('参考总价分布频率直方图')

x = len(r_zj)

y = r_zj['频率']

m = r_zj['频数']

for i, j, k in zip(range(x), y, m):

    plt.text(i - 0.1, j + 0.01, '%i'% k, color = 'k')  #-0.1 、+0.01是调整它的位置的

#添加频率标签

频率分布情况 - 定性字段
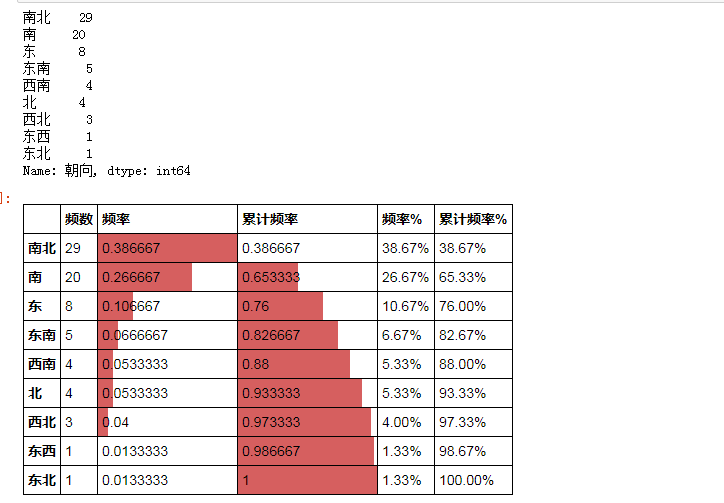
( ① 通过计数统计判断不同类别的频率)
# 频率分布情况 - 定性字段 -->> ① 通过计数统计判断不同类别的频率

cx_g = data['朝向'].value_counts(sort = True)

print(cx_g)

# 可视化显示

r_cx = pd.DataFrame(cx_g)

r_cx.rename(columns ={cx_g.name:'频数'}, inplace = True)  # 修改频数字段名

r_cx['频率'] = r_cx / r_cx['频数'].sum()  # 计算频率

r_cx['累计频率'] = r_cx['频率'].cumsum()  # 计算累计频率

r_cx['频率%'] = r_cx['频率'].apply(lambda x: "%.2f%%" % (x*100))  # 以百分比显示频率

r_cx['累计频率%'] = r_cx['累计频率'].apply(lambda x: "%.2f%%" % (x*100))  # 以百分比显示累计频率

r_cx.style.bar(subset=['频率','累计频率'], color='#d65f5f',width=100)
( ② 绘制频率直方图、饼图)
.plot 由Series、DataFrame直接绘制图表; plt.pie() 绘制饼图
# 频率分布情况 - 定量字段

# ② 绘制频率直方图、饼图

plt.figure(num = 1,figsize = (12,2))

r_cx['频率'].plot(kind = 'bar',

                 width = 0.8,

                 rot = 0,

                 color = 'k',

                 grid = True,

                 alpha = 0.5)

plt.title('参考总价分布频率直方图')

# 绘制直方图

plt.figure(num = 2)

plt.pie(r_cx['频数'],

       labels = r_cx.index,

       autopct='%.2f%%',

       shadow = True)

plt.axis('equal') #调整它的形状

# 绘制饼图

数据特征分析:1.基础分析概述& 分布分析的更多相关文章
- R语言|数据特征分析
对数据进行质量分析以后,接下来可通过绘制图表.计算某些特征量等手段进行数据的特征分析. 主要通过分布分析.对比分析.统计量分析.周期性分析.贡献度分析.相关性分析等角度进行展开. 2.1 分布分析 分 ...
- .NET 并行(多核)编程系列之七 共享数据问题和解决概述
原文:.NET 并行(多核)编程系列之七 共享数据问题和解决概述 .NET 并行(多核)编程系列之七 共享数据问题和解决概述 前言:之前的文章介绍了了并行编程的一些基础的知识,从本篇开始,将会讲述并行 ...
- 判断数据是否服从某一分布(二)——简单易用fitdistrplus包
一.对数据的分布进行初步判断 1.1 原理 对于不同的分布,有特定的偏度(skewness)和峰度(kurtosis),正态分布.均匀分布.逻辑斯谛分布.指数分布的偏度和峰度都是特定的值,在偏 ...
- SQL SERVER大话存储结构(1)_数据页类型及页面指令分析
如果转载,请注明博文来源: www.cnblogs.com/xinysu/ ,版权归 博客园 苏家小萝卜 所有.望各位支持! SQLServer的数据页大 ...
- 数据分析与展示——Pandas数据特征分析
Pandas数据特征分析 数据的排序 将一组数据通过摘要(有损地提取数据特征的过程)的方式,可以获得基本统计(含排序).分布/累计统计.数据特征(相关性.周期性等).数据挖掘(形成知识). .sort ...
- 基于TILE-GX实现快速数据包处理框架-netlib实现分析【转】
最近在研究suricata源码,在匹配模式的时候,有tilegx mpipe mode,转载下文,了解一下. 原文地址:http://blog.csdn.net/lhl_blog/article/de ...
- 开源大数据引擎:Greenplum 数据库架构分析
Greenplum 数据库是最先进的分布式开源数据库技术,主要用来处理大规模的数据分析任务,包括数据仓库.商务智能(OLAP)和数据挖掘等.自2015年10月正式开源以来,受到国内外业内人士的广泛关注 ...
- Python学习笔记三:数据特征分析
完成数据清理后,下面通过图表展开对数据的分析. 1.前期初判(分布分析): 1)判断分组区间: # a.散点图:plt.scatter(data[字段1],data['字段2'], s = data[ ...
- 数据挖掘(data mining),机器学习(machine learning),和人工智能(AI)的区别是什么? 数据科学(data science)和商业分析(business analytics)之间有什么关系?
本来我以为不需要解释这个问题的,到底数据挖掘(data mining),机器学习(machine learning),和人工智能(AI)有什么区别,但是前几天因为有个学弟问我,我想了想发现我竟然也回答 ...
随机推荐
- 安装v2ray+SwitchyOmega使用谷歌***
系统环境:ubuntu18.04 1.安装v2ray 在root用户下执行命令:bash < (curl -L -s https://install.direct/go.sh) $ cd /e ...
- url分发(二级分发)
from django.shortcuts import HttpResponsedef test(request): return HttpResponse('test') from django. ...
- JavaScript 删除某个数组中指定的对象
返回对象在数组中的下标: _arr表示一个Array数组,里面包括了很多的对象如下图: _obj表示某一个数组对象 function getIndex (_arr,_obj) { var le ...
- 表单,table的css
table{table_layout:fixed;border-collapse: collapse;border-spacing: 0}border-collapse: collapse 边框合并在 ...
- PID控制器开发笔记之四:梯形积分PID控制器的实现
从微积分的基本原理看,积分的实现是在无限细分的情况下进行的矩形加和计算.但是在离散状态下,时间间隔已经足够大,矩形积分在某些时候显得精度要低了一些,于是梯形积分被提出来以提升积分精度. 1.梯形积分基 ...
- java基础编程题练习(一)
1.编程实现用户输入4个整数,按从大到小的顺序排列输出. 思路:将输入的数据存入数组,使用冒泡排序对数组数据进行排序后输出数组 冒泡排序的代码如下: import java.util.Scanner; ...
- LeetCode(84): 柱状图中最大的矩形
Hard! 题目描述: 给定 n 个非负整数,用来表示柱状图中各个柱子的高度.每个柱子彼此相邻,且宽度为 1 . 求在该柱状图中,能够勾勒出来的矩形的最大面积. 以上是柱状图的示例,其中每个柱子的宽度 ...
- django----注意事项
不用带参数 必须要带参数:
- JMeter 提供了六种定时器
JMeter提供了六种定时器,下面让我们一起来学习下JMeter的定时器. 先明确一些概念: 1)定时器是在每个sampler(采样器)之前执行的,而不是之后: 是的,你没有看错,不管这个定时器的位置 ...
- const 和 const_cast
对于const变量,我们不能修改它的值,这是这个限定符最直接的表现.但是我们就是想违背它的限定希望修改其内容怎么办呢?下边的代码显然是达不到目的的: ; int modifier = constant ...