
统计--VARCHAR与NVARCHAR在统计预估上的区别
最近遇到一个问题,当查询使用到模糊查询时,由于预估返回行数过高,执行计划认为索引查找+Key Lookup的成本过高,因此采用Clustered Index Scan的方式,消耗大量逻辑IO,执行计划较差。
经过测试,发现对于模糊查询,NVARCHAR和VARCHAR的预估返回行数差距很大,因此拿出来供大家一起测试。
首先生成测试数据,分别创建TB101和TB102的表,表上有相同的聚集索引和非聚集索引,表中有100w数据,创建测试数据脚本如下:
DROP TABLE TB101

GO

DROP TABLE TB102

GO

SELECT

CAST(NCHAR(19968+20902*RAND(RID))+NCHAR(19968+20902/2*RAND(RID))+NCHAR(19968+20902/3*RAND(RID)) AS varchar(40)) AS RName

,*

INTO TB101

FROM(

SELECT ROW_NUMBER()OVER(ORDER BY T1.OBJECT_ID DESC) AS RID,T1.* FROM sys.all_objects T2

CROSS JOIN sys.all_columns T1

) AS T

WHERE T.RID<1000000

GO

SELECT * INTO TB102 FROM TB101

GO

ALTER TABLE TB102

ALTER COLUMN RName NVARCHAR(40)

GO

CREATE UNIQUE CLUSTERED INDEX IDX_RID ON TB101(RID)

GO

CREATE UNIQUE CLUSTERED INDEX IDX_RID ON TB102(RID)

GO

CREATE INDEX IDX_Name ON TB101(RName)

GO

CREATE INDEX IDX_Name ON TB102(RName)

GO

EXEC sp_spaceused 'TB101'

EXEC sp_spaceused 'TB102'

GO
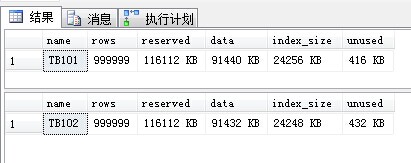
两表使用空间相同,数据相同。
测试前先更新下统计:
--更新统计

UPDATE STATISTICS TB101 WITH FULLSCAN

GO

UPDATE STATISTICS TB102 WITH FULLSCAN
开始测试1
SELECT RName FROM TB101

WHERE RName LIKE '你好%'
其执行计划为: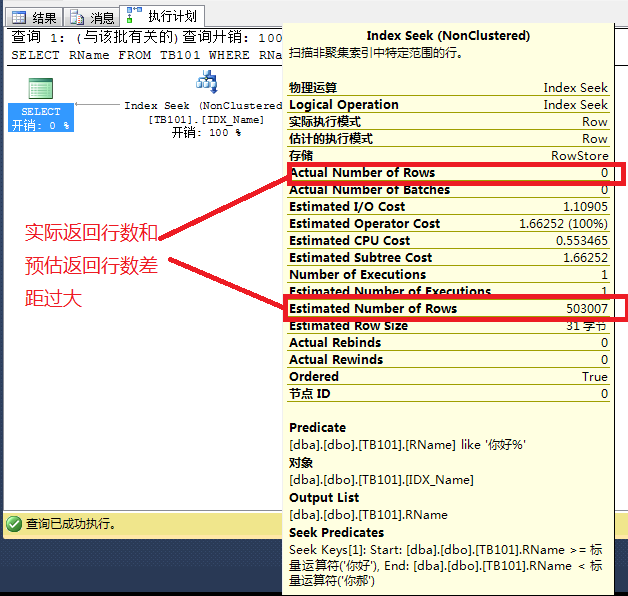
测试2:
SELECT RName FROM TB102

WHERE RName LIKE N'你好%'

感谢网友“ 害怕飞的鸟”的提醒,我们测试了以中文开头的模糊查询,需要测试以字母开头的模糊查询。
因此重新创建测试用例(生成新的测试数据目的为了避免查询值落在统计的两端,原理请参考大神高继伟的SQL Server 统计信息(Statistics)-概念,原理,应用,维护)
准备测试数据:
SELECT

CAST(NCHAR(65+25*RAND(RID))+NCHAR(24*RAND(RID))+NCHAR(19968+20902/2*RAND(RID))+NCHAR(19968+20902/3*RAND(RID)) AS varchar(40)) AS RName

,*

INTO TB103

FROM(

SELECT ROW_NUMBER()OVER(ORDER BY T1.OBJECT_ID DESC) AS RID,T1.* FROM sys.all_objects T2

CROSS JOIN sys.all_columns T1

) AS T

WHERE T.RID<1000000

GO

SELECT * INTO TB104 FROM TB103

GO

ALTER TABLE TB104

ALTER COLUMN RName NVARCHAR(40)

GO

CREATE UNIQUE CLUSTERED INDEX IDX_RID ON TB103(RID)

GO

CREATE UNIQUE CLUSTERED INDEX IDX_RID ON TB104(RID)

GO

CREATE INDEX IDX_Name ON TB103(RName)

GO

CREATE INDEX IDX_Name ON TB104(RName)

GO
测试1:
SELECT RName FROM TB103

WHERE RName LIKE 'A你好%'

测试2:
SELECT RName FROM TB104

WHERE RName LIKE N'A你好%'

通过上面四个测试,可以得出以下结论:
1. 当字段的数据类型为NVARCHAR时,无论模糊查询以中文还是英文字母开头,预估返回行数和实际返回行数相差不多
2. 当字段的数据类型为VARCHAR且模糊查询以英文字母开头,预估返回行数和实际返回行数相差不多
3. 当字段的数据类型为VARCHAR且模糊查询以中文开头,预估返回行数和实际返回行数相差较大。
--==============================================================
当预估返回行数与实际返回行数相差较大时,就很容易生成较差的执行计划,如对于查询:
SELECT * FROM TB101

WHERE RName LIKE '你好%'
由于预估索引查找会返回50w的数据,查询优化器引擎认为如果使用索引查找+Key Lookup就会消耗上200W+的逻辑IO, 效率会远低于表扫描,因此有了下面的执行计划:
而实际上,经过索引查找后,只会返回少量的数据行,这些行做Key Lookup也只会消耗少量的逻辑IO,因此索引查找+Key Lookup是最高效的。
解决办法:
对于这种问题,可以有几种办法处理:
1. 强制索引查找
SELECT * FROM TB101 WITH(FORCESEEK)

WHERE RName LIKE '你好%'
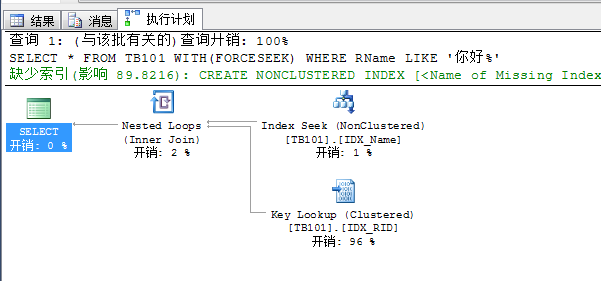
2. 使用隐式转化
SELECT * FROM TB101

WHERE RName LIKE N'你好%'

经过一次隐式转换后,预估返回行数出奇地下降下来,生成了正确的执行计划(看来隐式转换也是有存在价值地哦)
3. 如果不想修改程序的话,可以考虑使用参数化和执行计划指南来实现
--=========================================================================================
总结(以下结论未经过大神认证,请自行组鉴别正确性):
1. 当字段的数据类型为NVARCHAR时,无论模糊查询以中文还是英文字母开头,预估返回行数和实际返回行数相差不多
2. 当字段的数据类型为VARCHAR且模糊查询以英文字母开头,预估返回行数和实际返回行数相差不多
3. 当字段的数据类型为VARCHAR且模糊查询以中文开头,预估返回行数和实际返回行数相差较大。
4. 隐式转换未必会导致表扫描或索引扫描,也未必会导致执行计划质量不优。
--===========================================================
统计--VARCHAR与NVARCHAR在统计预估上的区别的更多相关文章
- SQL Server 执行计划利用统计信息对数据行的预估原理二(为什么复合索引列顺序会影响到执行计划对数据行的预估)
本文出处:http://www.cnblogs.com/wy123/p/6008477.html 关于统计信息对数据行数做预估,之前写过对非相关列(单独或者单独的索引列)进行预估时候的算法,参考这里. ...
- SQL Server 执行计划利用统计信息对数据行的预估原理以及SQL Server 2014中预估策略的改变
前提 本文仅讨论SQL Server查询时, 对于非复合统计信息,也即每个字段的统计信息只包含当前列的数据分布的情况下, 在用多个字段进行组合查询的时候,如何根据统计信息去预估行数的. 利用不同字段 ...
- 数据库char varchar nchar nvarchar,编码Unicode,UTF8,GBK等,Sql语句中文前为什么加N(一次线上数据存储乱码排查)
背景 公司有一个数据处理线,上面的数据经过不同环境处理,然后上线到正式库.其中一个环节需要将数据进行处理然后导入到另外一个库(Sql Server).这个处理的程序是老大用python写的,处理完后进 ...
- 全废话SQL Server统计信息(2)——统计信息基础
接上文:http://blog.csdn.net/dba_huangzj/article/details/52835958 我想在大地上画满窗子,让所有习惯黑暗的眼睛都习惯光明--顾城<我是一个 ...
- 全废话SQL Server统计信息(1)——统计信息简介
当心空无一物,它便无边无涯.树在.山在.大地在.岁月在.我在.你还要怎样更好的世界?--张晓风<我在> 为什么要写这个内容? 随着工作经历的积累,越来越感觉到,大量的关系型数据库的性能问题 ...
- sql中NVARCHAR(MAX) 性能和占空间分析 varchar(n),nvarchar(n) 长度性能及所占空间分析
varchar(n),nvarchar(n) 中的n怎么解释: nvarchar(n)最多能存n个字符,不区分中英文. varchar(n)最多能存n个字节,一个中文是两个字节. 所占空间: nvar ...
- 答:SQLServer DBA 三十问之一: char、varchar、nvarchar之间的区别(包括用途和空间占用);xml类型查找某个节点的数据有哪些方法,哪个效率高;使用存储 过程和使用T-SQL查询数据有啥不一样;
http://www.cnblogs.com/fygh/archive/2011/10/18/2216166.html 1. char.varchar.nvarchar之间的区别(包括用途和空间占用) ...
- varchar和Nvarchar区别
http://www.cnblogs.com/yelaiju/archive/2010/05/29/1746826.html Unicode字符集就是为了解决字符集这种不兼容的问题而产生的,它所有的字 ...
- sql-char和varchar,nvarchar的区别
数据类型的比较 char表示的是固定长度,最长n个字 varchar表示的是实际长度的数据类型 比如:如果是char类型,当你输入字符小于长度时,后补空格:而是varchar类型时,则表示你输入字符的 ...
随机推荐
- JSP动作
JSP动作元素在请求处理阶段起作用,他们会被转换成Java代码来执行操作,如访问一个Java对象或调用方法. JSP动作元素是用XML语法写成的. 动作元素基本上都是预定义的函数,JSP规范定义了一系 ...
- Servlet会话管理二(Cookie)
Cookie是在HTTP协议下,将服务器传递给浏览器的的少量信息保存到浏览器客户端的一种技术,通过这种技术,即使在浏览器被关闭或链接中断的情况下,用户仍可以维护Cookie中的数据. Cookie是经 ...
- 【统一异常处理】@ControllerAdvice + @ExceptionHandler 全局处理 Controller 层异常
1.利用springmvc注解对Controller层异常全局处理 对于与数据库相关的 Spring MVC 项目,我们通常会把 事务 配置在 Service层,当数据库操作失败时让 Service ...
- 要显示的联系人——>自定义-bug
自定义中将“电话”下的“所有联系人”不勾选,但是Contacts列表还是显示PHONE联系人. SELECT _id, display_name, agg_presence.mode AS conta ...
- ViewPager源码分析——滑动切换页面处理过程
上周客户反馈Contacts快速滑动界面切换tab有明显卡顿,让优化. 自己验证又没发现卡顿现象,但总得给客户一个技术性的回复,于是看了一下ViewPager源码中处理滑动切换tab的过程. View ...
- 消息中间件及WebSphere MQ入门(转载)
消息队列技术是分布式应用间交换信息的一种技术.消息队列可驻留在内存或磁盘上,队列存储消息直到它们被应用程序读走.通过消息队列,应用程序可独立地执行--它们不需要知道彼此的位置.或在继续执行前不需要等待 ...
- mybatis学习 十六 auto_mapping实现连表查询
只能使用多表联合查询方式. 要求:查询出的列别和属性名相同. 点字符 "." 在 SQL 是关键字符,两侧添加反单引号(Tab键上的一个字符) <select id=&q ...
- centos6 搭建nginx实现负载均衡
一.安装nginx 1)准备2台服务器,环境一样,同时执行 rpm -ivh http://mirrors.aliyun.com/epel/epel-release-latest-6.noarch.r ...
- tensorflow下识别手写数字基于MLP网络
# coding: utf-8 # In[1]: import tensorflow as tf import tensorflow.examples.tutorials.mnist.input_da ...
- 3、iOS Xcode创建protocol(代理).h文件