
scikitlearn库中调用k-近邻算法的操作步骤
1、k近邻算法可以说是唯一一个没有训练过程的机器学习算法,它含有训练基础数据集,但是是一种没有模型的算法,为了将其和其他算法进行统一,我们把它的训练数据集当做它的模型本身。
2、在scikitlearn中调用KNN算法的操作步骤如下(利用实际例子举例如下):
#1导入相应的数据可视化模块
import numpy as np
import matplotlib.pyplot as plt
#2输入训练的数据集x_train、y_train
raw_data_X=[[3.393533211,2.331273381],
[3.110073483,1.781539638],
[1.343808831,3.368360954],
[3.582294042,4.679179110],
[2.280362439,2.866990263],
[7.423436942,4.696522875],
[5.745051997,3.533989803],
[9.172168622,2.511101045],
[7.792783481,3.424088941],
[7.939820817,0.791637231]]
raw_data_Y=[0,0,0,0,0,1,1,1,1,1]
x_train=np.array(raw_data_X)
y_train=np.array(raw_data_Y)
x=np.array([8.093607318,3.365731514])
#特别注意:scilearn模块里面验证数据都将默认为二维数据,如果不是,则需要使用.reshape(1,-1)函数对其进行转换
#3从scikitlearn库中调用相应的机器学习算法
from sklearn.neighbors import KNeighborsClassifier #调用算法库
KNN_classifier=KNeighborsClassifier(n_neighbors=6) #定义新的算法
KNN_classifier.fit(x_train,y_train) #基础数据训练模型
#4导入测试的数据集test_data和test_target
test_data1=[[3.93533211,2.33127381],
[3.10073483,1.78159638],
[1.34808831,3.36830954],
[3.58294042,4.67919110],
[2.28032439,2.86690263],
[7.42343942,4.69652875],
[5.74505997,3.53399803],
[9.17216622,2.51101045],
[7.79278481,3.42488941],
[7.93982087,0.79637231]]
test_data=np.array(test_data1)
test_target=[0,0,0,0,1,1,0,0,0,0]
x=x.reshape(1,-1)
print(KNN_classifier.predict(x))
y_pred=KNN_classifier.predict(test_data) #对测试数据进行预测
#5对于算法的准确度进行输出和评估(准确度和混淆矩阵)
from sklearn import metrics #引入机器学习的验证模块
print(metrics.accuracy_score(y_true=test_target,y_pred=y_pred)) #输出整体预测结果的准确率,其中第三个参数normalize=False表示输出结果预测正确的个数
print(metrics.confusion_matrix(y_true=test_target,y_pred=y_pred)) #输出混淆矩阵,如果为对角阵,则表示预测结果是正确的,准确度越大
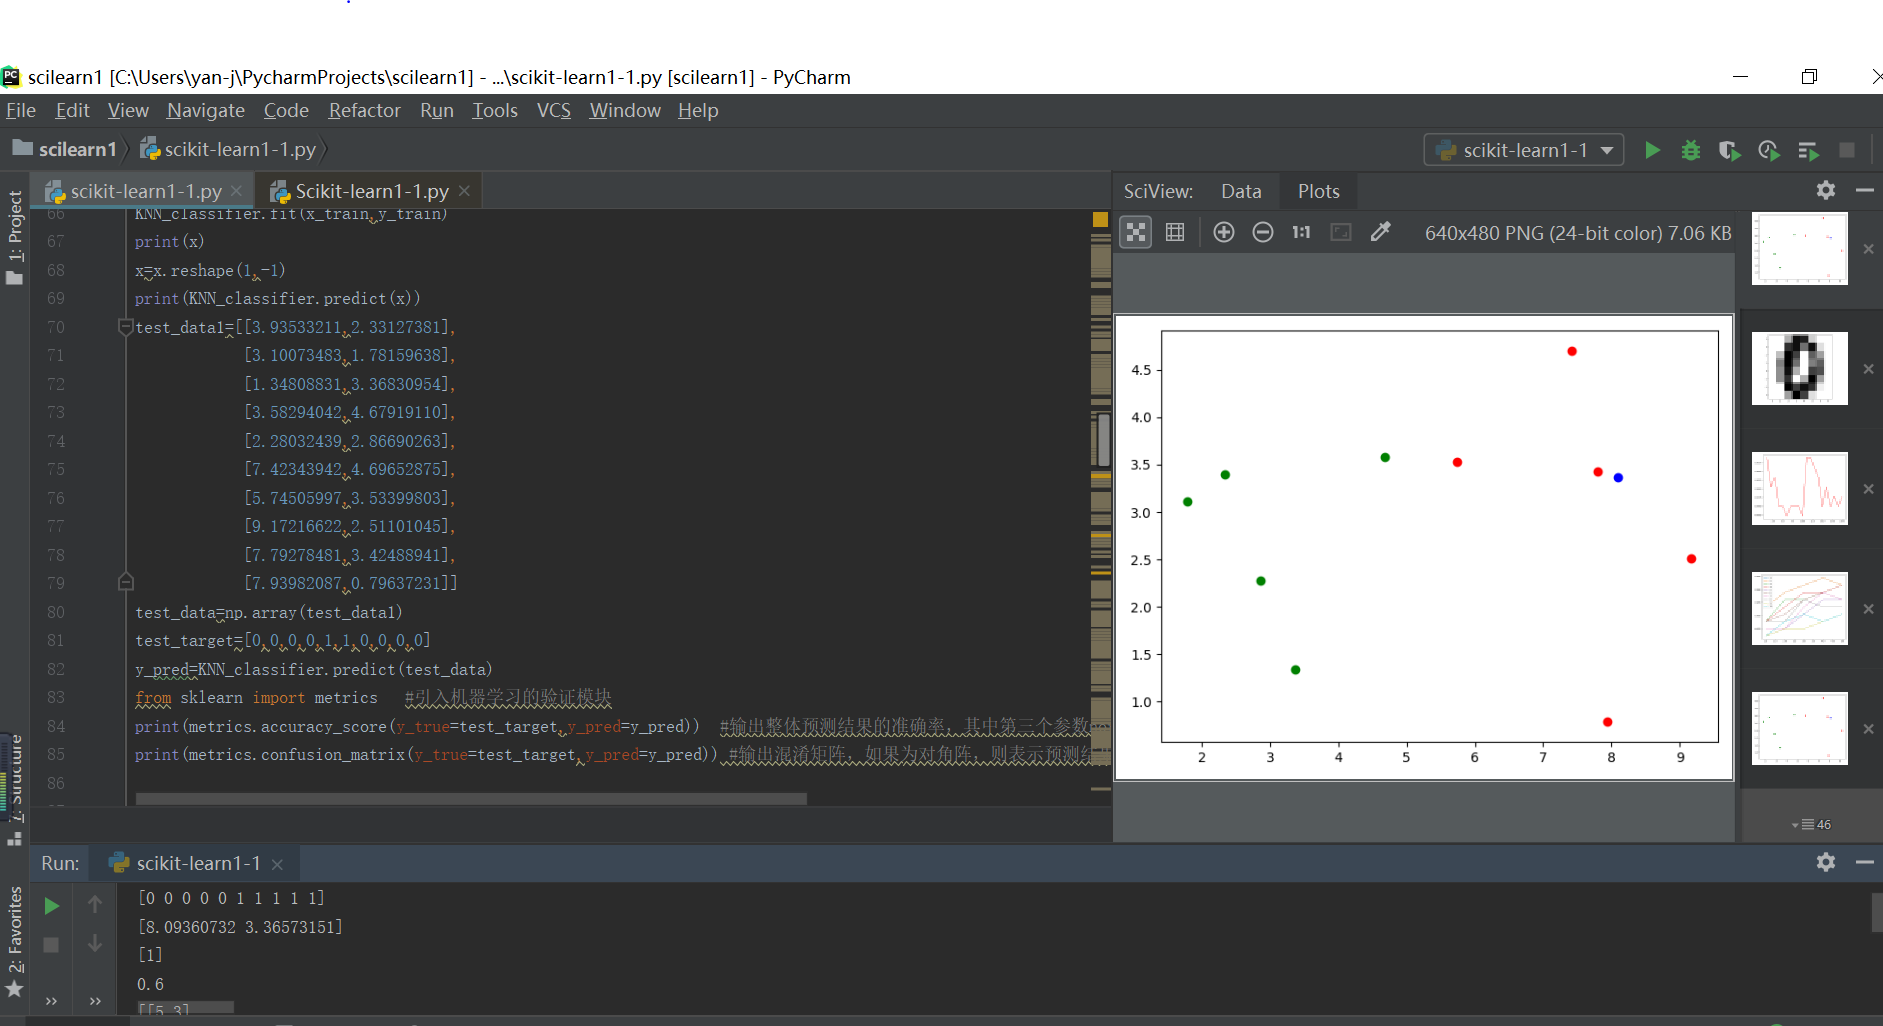
3、从scikitlearn库中调用相应的机器学习算法的步骤如下:
(1)从scikitlearn库中调用相应的机器学习算法模块;
(2)输入相应的算法参数定义一个新的算法;
(3)输入基础训练数据集进行训练;
(4)输入测试数据集对其结果进行预测;
(5)将预测结果与真实结果进行对比,输出其算法的准确率(或者混淆矩阵)
4、对于机器学习算法的准确度评价主要有以下几种方式:
(1)利用scikitlearn中的accuracy函数:
from sklearn import metrics #引入机器学习的验证模块
print(metrics.accuracy_score(y_true=y_test,y_pred=y_pred)) #输出整体预测结果的准确率,其中第三个参数normalize=False表示输出结果预测正确的个数
print(metrics.confusion_matrix(y_true=y_test,y_pred=y_pred)) #输出混淆矩阵,如果为对角阵,则表示预测结果是正确的,准确度越大
(2)直接利用机器学习算法中的.score(X,y)函数输出算法的准确度
其中X表示数据的测试集(x_test),y代表真实目标值(y_test)
scikitlearn库中调用k-近邻算法的操作步骤的更多相关文章
- Asp.net页面中调用soapheader进行验证的操作步骤
Asp.net页面中调用以SOAP头作验证的web services操作步骤 第一步:用来作SOAP验证的类必须从SoapHeader类派生,类中Public的属性将出现在自动产生XML节点中,即: ...
- GridSearchCV网格搜索得到最佳超参数, 在K近邻算法中的应用
最近在学习机器学习中的K近邻算法, KNeighborsClassifier 看似简单实则里面有很多的参数配置, 这些参数直接影响到预测的准确率. 很自然的问题就是如何找到最优参数配置? 这就需要用到 ...
- 机器学习:k-NN算法(也叫k近邻算法)
一.kNN算法基础 # kNN:k-Nearest Neighboors # 多用于解决分裂问题 1)特点: 是机器学习中唯一一个不需要训练过程的算法,可以别认为是没有模型的算法,也可以认为训练数据集 ...
- 02-16 k近邻算法
目录 k近邻算法 一.k近邻算法学习目标 二.k近邻算法引入 三.k近邻算法详解 3.1 k近邻算法三要素 3.1.1 k值的选择 3.1.2 最近邻算法 3.1.3 距离度量的方式 3.1.4 分类 ...
- 1.K近邻算法
(一)K近邻算法基础 K近邻(KNN)算法优点 思想极度简单 应用数学知识少(近乎为0) 效果好 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 图解K近邻算法 上图是以 ...
- 02-18 scikit-learn库之k近邻算法
目录 scikit-learn库之k近邻算法 一.KNeighborsClassifier 1.1 使用场景 1.2 代码 1.3 参数详解 1.4 方法 1.4.1 kneighbors([X, n ...
- 数据挖掘入门系列教程(三)之scikit-learn框架基本使用(以K近邻算法为例)
数据挖掘入门系列教程(三)之scikit-learn框架基本使用(以K近邻算法为例) 简介 scikit-learn 估计器 加载数据集 进行fit训练 设置参数 预处理 流水线 结尾 数据挖掘入门系 ...
- 【笔记】KNN之网格搜索与k近邻算法中更多超参数
网格搜索与k近邻算法中更多超参数 网格搜索与k近邻算法中更多超参数 网络搜索 前笔记中使用的for循环进行的网格搜索的方式,我们可以发现不同的超参数之间是存在一种依赖关系的,像是p这个超参数,只有在 ...
- 机器学习算法之K近邻算法
0x00 概述 K近邻算法是机器学习中非常重要的分类算法.可利用K近邻基于不同的特征提取方式来检测异常操作,比如使用K近邻检测Rootkit,使用K近邻检测webshell等. 0x01 原理 ...
随机推荐
- DHCP报文交互流程
1.发现阶段,即DHCP客户机寻找DHCP服务器的阶段(DHCPdiscover) DHCP客户机以广播方式(因为DHCP服务器的IP地址对于客户机来说是未知的)发送DHCPdiscover发现信息来 ...
- Python与线性代数——Numpy中的matrix()和array()的区别
Numpy中matrix必须是2维的,但是 numpy中array可以是多维的(1D,2D,3D····ND).matrix是array的一个小的分支,包含于array.所以matrix 拥有arra ...
- Update(Stage4):spark_rdd算子:第1节 RDD_定义_转换算子:深入RDD
一. 二.案例:详见代码.针对案例提出的6个问题: 假设要针对整个网站的历史数据进行处理, 量有 1T, 如何处理? 放在集群中, 利用集群多台计算机来并行处理 如何放在集群中运行? 简单来讲, 并行 ...
- MYSQL优化考虑十个方面
1)索引 2)sql优化 3)锁 4)延迟 5)参数优化 6)连接数 7)cpu 8)iops 9)磁盘 10)内存
- Solidity高级用法
1.内存数组: 将数组与memory结合形成内存数组,在函数调用完后就解释 uint[ ] memory values = new uint[ ](3);//初始化了一个长度为3的内存数组: #内存数 ...
- JavaScript判断两个对象内容是否相等
ES6中有一个方法判断两个对象是否相等,这个方法判断是两个对象引用地址是否一致 let obj1= { a: 1 } let obj2 = { a: 1 } console.log(Object.is ...
- Faster-RCNN Pytorch实现的minibatch包装
实际上faster-rcnn对于输入的图片是有resize操作的,在resize的图片基础上提取feature map,而后generate一定数量的RoI. 我想首先去掉这个resize的操作,对每 ...
- gitlab相关命令操作
[root@xuegod63 ~]# git config --global user.name "zsl3"[root@xuegod63 ~]# git config --glo ...
- 简单描述MySQL常用引擎的特点及MySQL的逻辑架构
目录 表的分类数据库引擎? 首先得说说mysql的逻辑架构,它整体分为3层: 常用引擎: 补充知识点: 表的分类数据库引擎? 引擎是什么? 引擎就是一个系统最核心的部分,比如汽车的发动机,人的心脏 数 ...
- Servlet 学习(四)
HTTP 响应的构成1.HTTP 响应行: 协议.状态.描述 HTTP 1.1 中定义的状态代码 100-199 是信息性代码,标示客户应该采取的其它动作 200-299 表示请求成功 300-399 ...