
3. Spark常见数据源
*以下内容由《Spark快速大数据分析》整理所得。
读书笔记的第三部分是讲的是Spark有哪些常见数据源?怎么读取它们的数据并保存。
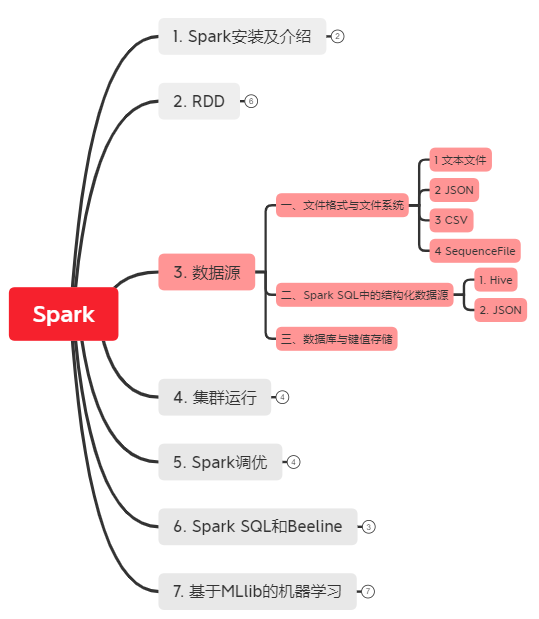
Spark有三类常见的数据源:
- 文件格式与文件系统:它们是存储在本地文件系统或分布式文件系统(比如 NFS、HDFS、Amazon S3 等)中的 数据,例如:文本文件、JSON、SequenceFile, 以及 protocol buffer。
- Spark SQL中的结构化数据源:它针对包括JSON和Apache Hive在内的结构化数据源。
- 数据库与键值存储:Spark 自带的库和一些第三方库,它们可以用来连接Cassandra、HBase、Elasticsearch以及JDBC源。
一、文件格式与文件系统
1. 文本文件
2. JSON
3. CSV
4. SequenceFile
二、Spark SQL中的结构化数据源
1. Hive
2. JSON
三、数据库与键值存储
一、文件格式与文件系统
1. 文本文件
文本文件读取:
# 方法1:文本文件读取

input = sc.textFile("file://home/holden/repos/sparks/README.md")

# 方法2:如果文件足够小,同时读取整个文件,从而返回一个pair RDD,其中键时输入文件的文件名

input = sc.wholeTextFiles("file://home/holden/salesFiles")
文本文件保存:
result.saveAsTextFile(outputFile)
2. JSON
JSON读取:
# JSON读取

import json

data = input.map(lambda x: json.loads(x))
JSON保存:
# JSON保存 - 举例选出喜爱熊猫的人

(data.filter(lambda x: x["lovesPandas"]).map(lambda x: json.dumps(x)).saveAsTextFile(outputFile))

# 保存文本文件

result.SaveAsTextFile(outputFilePath)
3. CSV
CSV读取:
import csv

import StringIO

# CSV读取 - 如果数据字段均没有包括换行符,只能一行行读取

def loadRecord(line):

    """解析一行CSV记录"""

    input = StringIO.StringIO(line)

    reader = csv.DictReader(input, fieldnames=["name", "favouriteAnimal"])

    return reader.next()


input = sc.textFile(inputFile).map(loadRecord)


# CSV读取 - 如果数据字段嵌有换行符,需要完整读入每个文件

def loadRecords(fileNameContents):

    """读取给定文件中的所有记录"""

    input = StringIO.StringIO(fileNameContents[1])

    reader = csv.DictReader(input, fieldnames=["name", "favoriteAnimal"])

    return reader


fullFileData = sc.wholeTextFiles(inputFile).flatMap(loadRecords)
CSV保存:
# CSV保存

def writeRecords(records):

    """写出一些CSV记录"""

    output = StringIO.StringIO()

    writer = csv.DictWriter(output, fieldnames=["names", "favoriteAnimal"])

    for record in records:

        writer.writerow(record)

    return [output.getvalue()]

pandaLovers.mapPartitions(writeRecords).saveAsTextFile(outputFile)
4. SequenceFile
SequenceFile读取:
# sc.sequenceFile(path, keyClass, valueClass)
data = sc.sequenceFile(inFile, "org.apache.hadoop.io.Text", "org.apache.hadoop.io.IntWritable")
SequenceFile保存(用Scala):
val data = sc.parallelize(List(("Pandas", 3), ("Kay", 6), ("Snail", 2)))

data.saveAsSequenceFile(outputFile)
二、Spark SQL中的结构化数据源
用Spark SQL从多种数据源里读取数据:
1. Hive
用Spark SQL连接已有的Hive:
(1.1)需要将hive-site.xml文件复制到 Spark 的 ./conf/ 目录下;
(1.2)再创建出HiveContext对象,也就是 Spark SQL 的入口;
(1.3)使用Hive查询语言(HQL)来对你的表进行查询。
# 例子:用Python创建HiveContext并查询数据

from pyspark.sql import HiveContext

hiveCtx = HiveContext(sc)

rows = hiveCtx.sql("SELECT name, age FROM users")

firstRow = rows.first()

print firstRow.name
2. JSON
(2.1)和使用Hive一样创建一个HiveContext。(不过在这种情况下我们不需要安装好Hive,也就是说你也不需要hive-site.xml文件。);
(2.2)使用HiveContext.jsonFile方法来从整个文件中获取由Row对象组成的RDD。
(2.3)除了使用整个Row对象,你也可以将RDD注册为一张表,然后从中选出特定的字段。
# 例子:在Python中使用Spark SQL读取JSON数据

tweets = hiveCtx.jsonFile("tweets.json")

tweets.registerTempTable("tweets")

results = hiveCtx.sql("SELECT user.name, text FROM tweets")
三、数据库与键值存储
关于Cassandra、HBase、Elasticsearch以及JDBC源的数据库连接,详情请参考书本81-86页内容。
3. Spark常见数据源的更多相关文章
- Spring:(三) --常见数据源及声明式事务配置
Spring自带了一组数据访问框架,集成了多种数据访问技术.无论我们是直接通过 JDBC 还是像Hibernate或Mybatis那样的框架实现数据持久化,Spring都可以为我们消除持久化代码中那些 ...
- Spark SQL数据源
[TOC] 背景 Spark SQL是Spark的一个模块,用于结构化数据的处理. ++++++++++++++ +++++++++++++++++++++ | SQL | | Dataset API ...
- Spark常见编程问题解决办法及优化
目录 1.数据倾斜 2.TopN 3.Join优化 预排序的join cross join 考虑Join顺序 4.根据HashMap.DF等数据集进行filter 5.Join去掉重复的列 6.展开N ...
- 4. Spark SQL数据源
4.1 通用加载/保存方法 4.1.1手动指定选项 Spark SQL的DataFrame接口支持多种数据源的操作.一个DataFrame可以进行RDDs方式的操作,也可以被注册为临时表.把DataF ...
- ODBC 常见数据源配置整理
目录 1. 简介 1.1 ODBC和JDBC 1.2 ODBC配置工具 1.3 ODBC 数据源连接配置 2. MySQL 数据源配置 2.1 配置步骤 2.2 链接参数配置 3. SQLServer ...
- spark之数据源之自动分区推断
在hadoop上创建目录/spark-study/users/gender=male/country=US/users.parquet(并且把文件put上去) code: package cn.spa ...
- Spark常见错误汇总
1. Spark Driver cannot bind on port0, SparkContext initialized failed 如果是通过spark-submit等命令行提交的任务,在sp ...
- spark常见错误【持续更新】
错误1.错误: 找不到或无法加载主类 idea.scala代码 idea 导入的scala工程,编写代码后报该错误. 原因:\src\main\scala 包路径下没有将scala这个包设置成Sour ...
- spark sql数据源--hive
使用的是idea编辑器 spark sql从hive中读取数据的步骤:1.引入hive的jar包 2.将hive-site.xml放到resource下 3.spark sql声明对hive的支持 案 ...
随机推荐
- JS判断PC操作系统版本
var version = navigator.userAgent; console.log(version); //"Mozilla/5.0 (Windows NT 10.0; WOW64 ...
- Oracle误操作 数据恢复
SELECT * FROM v$sqlarea //查询最近sql记录 SELECT r.FIRST_LOAD_TIME,r.* FROM v$sqlarea r ORDER BY r.FIRST_L ...
- package wang/test is not in GOROOT (/usr/local/go/src/wang/test)
如果要用 gopath模式 引入包 从src目录下开始引入 需要关闭 go mod 模式 export GO111MODULE=off 如果使用go mod 模式 export GO111MODULE ...
- Elasticsearch(5):添加文档
1 ES数据读写流程¶ ES中,每个索引都将被划分为若干分片,每个分片可以有多个副本.这些副本共同组成复制组,复制组中的分片在添加或删除文档时必须保持同步,否则,从一个副本中读取的数据将与从另一个 ...
- SpringCloud 与 SpringBoot版本问题
如果SpringBoot版本与SpringCloud版本不一致,SpringBoot应用启动会报错: 解决方案: 版本对应关系可以在 https://start.spring.io/info 上查看: ...
- 基于.Net Core开发的物联网平台 IoTSharp V1.5 发布
很高兴的宣布新版本的发布, 这次更新我们带来了大量新特性, 最值得关注的是, 我们逐步开始支持分布式, 这意味着你可以通过多台服务器共同处理数据, 而不是原来的单机处理, 我们也将遥测数据进行分开存储 ...
- windows.h和WinSock2.h出现重定义API
有两种常用的解决方法:1.把WinSock2.h写在windows.h之前 2.使用宏定义#define WIN32_LEAN_AND_MEAN
- 配置交换机之间直连链路聚合-LACP模式
组网图形 LACP模式链路聚合简介 以太网链路聚合是指将多条以太网物理链路捆绑在一起成为一条逻辑链路,从而实现增加链路带宽的目的.链路聚合分为手工模式和LACP模式. LACP模式需要有链路聚合控制协 ...
- ArcPy批量选择指定属性的要素
在GIS数据处理中,选择数据是十分频繁的操作,常用的是"按属性选择"和"按位置选择",这两个功能虽然比较强大,但有时也不能满足实际需求.比如可能时常会遇到这样一 ...
- python类的封装与继承
封装 关注公众号"轻松学编程"了解更多. 1.概念 面向对象语言的三大特征:封装, 继承, 多态. 广义的封装: 类和函数的定义本身就是封装的体现. 狭义的封装:一个类的某些属性, ...