
MapReduce:输入是两个文件,file1代表工厂表,包含工厂名列和地址编号列;file2代表地址表,包含地址名列和地址编号列。要求从输入数据中找出工厂名和地址名的对应关系,输出"工厂名----地址名"表
文件如下:
file1:
Beijing Red Star

Shenzhen Thunder

Guangzhou Honda

Beijing Rising

Guangzhou Development Bank

Tencent

Back of Beijing
file2:
    Beijing

    Guangzhou

    Shenzhen

    Xian
代码如下(由于水平有限,不保证完全正确,如果发现错误欢迎指正):
package com;

import java.io.IOException;

import java.util.ArrayList;

import java.util.Iterator;

import java.util.List;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class Test {

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {

        Configuration config = new  Configuration();

        config.set("fs.defaultFS", "hdfs://192.168.0.100:9000");

        config.set("yarn.resourcemanager.hostname", "192.168.0.100");

        FileSystem fs = FileSystem.get(config);

        Job job = Job.getInstance(config);

        job.setJarByClass(Test.class);

        //设置所用到的map类

        job.setMapperClass(myMapper.class);

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(Text.class);

        //设置用到的reducer类

        job.setReducerClass(myReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(Text.class);

        //设置s输入输出地址

        FileInputFormat.addInputPath(job, new Path("/FactoryName/"));

        Path path = new Path("/output2/");

        if(fs.exists(path)){

            fs.delete(path, true);

        }

        //指定文件的输出地址

        FileOutputFormat.setOutputPath(job, path);

        //启动处理任务job

        boolean completion = job.waitForCompletion(true);

        if(completion){

            System.out.println("Job Success!");

        }

    }

    public static class myMapper extends Mapper<Object, Text, Text, Text> {

        // 实现map函数

        public void map(Object key, Text value, Context context) throws IOException, InterruptedException {

            String temp=new String();// 左右表标识

            String values=value.toString();

            String words[]=values.split("\t");

            String mapkey = new String();

            String mapvalue = new String();

            //右表:1  Beijing

            if (words[].charAt() >= '' && words[].charAt() <= '') {

                mapkey = words[];

                mapvalue =words[];

                temp = "";

            }else{

                //左表:Beijing Red Star  1

                mapkey = words[];

                mapvalue =words[];

                temp = "";

            }

            // 输出左右表

            //左表:(1,1+Beijing Red Star)

            //右表:(1,2+Beijing)

            context.write(new Text(mapkey), new Text(temp + "+"+ mapvalue));

        }

    }

    //reduce解析map输出,将value中数据按照左右表分别保存

    public static class myReducer extends Reducer<Text, Text, Text, Text> {

        // 实现reduce函数

        public void reduce(Text key, Iterable<Text> values, Context context) throws IOException, InterruptedException {

            List<String> factory = new ArrayList<String>();

            List<String> address = new ArrayList<String>();

            for (Text value : values) {

                // 取得左右表标识

                char temp=(char) value.charAt();

                String words[]=value.toString().split("[+]");//1,Beijing Red Star

                if(temp==''){

                    factory.add(words[]);// 左表

                }

                if(temp==''){

                    address.add(words[]);// 右表

                }

            }

            //求出笛卡尔积,并输出

            for (String f : factory) {

                for (String a : address) {

                    context.write(new Text(f), new Text(a));

                }

            }

        }

    }

}
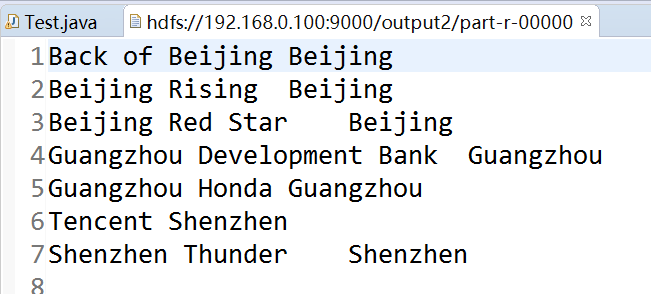
输出结果如下:
如果您认为这篇文章还不错或者有所收获,您可以通过右边的“打赏”功能 打赏我一杯咖啡【物质支持】,也可以点击下方的【好文要顶】按钮【精神支持】,因为这两种支持都是使我继续写作、分享的最大动力!
MapReduce:输入是两个文件,file1代表工厂表,包含工厂名列和地址编号列;file2代表地址表,包含地址名列和地址编号列。要求从输入数据中找出工厂名和地址名的对应关系,输出"工厂名----地址名"表的更多相关文章
- 使用Vim比较两个文件的内容
原文地址:http://blog.chinaunix.net/uid-22548820-id-3477464.html 1. 使用vim的比较模式打开两个文件: vim -d file1 file2 ...
- LINUX Shell 下求两个文件交集和差集的办法
http://blog.csdn.net/autofei/article/details/6579320 假设两个文件FILE1和FILE2用集合A和B表示,FILE1内容如下: a b c e d ...
- 在数组中找几个数的和等于某个数[LeetCode]
首先明确一点,这个方面的问题设计到的知识点是数组的查找的问题.对于类似的这样的查找操作的具体办法就是三种解决方法: 1.暴力算法,多个for循环,很高的时间复杂度 2.先排序,然后左右夹逼,但是这样会 ...
- [Python]根据地址从maps文件中找相应的库名
/proc/PID/maps提供了进程的memory layout,下面脚本根据给定地址找出相应的库名: #!/usr/bin/python from __future__ import print_ ...
- 给定a、b两个文件,各存放50亿个url,每个url各占用64字节,内存限制是4G,如何找出a、b文件共同的url?
给定a.b两个文件,各存放50亿个url,每个url各占用64字节,内存限制是4G,如何找出a.b文件共同的url? 可以估计每个文件的大小为5G*64=300G,远大于4G.所以不可能将其完全加载到 ...
- diff - 找出两个文件的不同点
总览 diff [选项] 源文件 目标文件 描述 在最简单的情况是, diff 比较两个文件的内容 (源文件 和 目标文件). 文件名可以是 - 由标准输入设备读入的文本. 作为特别的情况是, dif ...
- diff 比较两个文件的差异
功能:比较两个文件的差异,并把不同地方的信息显示出来.默认diff格式的信息. diff比较两个文件或文件集合的差异,并记录下来,生成一个diff文件,这也是我们常说的补丁文件.也使用patch命令对 ...
- diff比较两个文件 linux
功能:比较两个文件的差异,并把不同地方的信息显示出来.默认diff格式的信息. diff比较两个文件或文件集合的差异,并记录下来,生成一个diff文件,这也是我们常说的补丁文件.也使用patch命令对 ...
- 【pyhon】理想论坛爬虫1.05版,将读取和写DB分离成两个文件
下午再接再厉仿照Nodejs版的理想帖子爬虫把Python版的也改造了下,但美中不足的是完成任务的线程数量似乎停滞在100个左右,让人郁闷.原因还待查. 先把代码贴出来吧,也算个阶段性成果. 爬虫代码 ...
随机推荐
- 【转】HDC,CDC,CWindowDC,CClientDC,CPaintDC等等
转载出处:http://blog.sina.com.cn/s/blog_447611f20100lirt.html 首先说一下什么是DC(设备描述表) Windows应用程序通过为指定设备(屏幕,打 ...
- call to unavailable function system not available on ios 解决方案
编译时报错:call to unavailable function system not available on iOS 原因:iOS11已经将system删除 解决方案:system(comma ...
- 基于注解的Spring AOP拦截含有泛型的DAO
出错场景 1.抽象类BaseDao public abstract class BaseDao<T> { public BaseDao() { entityClass = (Class&l ...
- Dubbo基础篇-zookeeper安装(单点)
安装步骤: 一首先安装jdk环境 二 安装zookeeper 在centos虚拟机192.168.23.131中安装zookeeper: 1 修改操作系统/etc/hosts 文件中的配置: # ...
- cocos2d游戏开发,常用工具集合
位图字体工具Bitmap Font ToolsBMFont (Windows)FonteditorGlyph DesignerHieroLabelAtlasCreator 粒子编辑工具Particle ...
- 160722、Javascript函数节流
最近在做网页的时候有个需求,就是浏览器窗口改变的时候需要改一些页面元素大小,于是乎很自然的想到了window的resize事件,于是乎我是这么写的 <!DOCTYPE html> < ...
- 用jQuery的attr()设置option默认选中无效的解决 attr设置属性失效
表单下拉选项使用selected设置,发现第一次默认选中成功,在页面不刷新的情况下,再次下拉,selected属性设置了,默认选中不生效 在手机端有些浏览器用jQuery的attr()方法设置sele ...
- Exchange 2016 系统要求
Exchange 2016 和早期版本的 Exchange Server 共存方案 Exchange 2016支持混合部署方案 Exchange 2016 的网络和目录服务器要求 目录服务体系结构: ...
- SQL case when else
先占个坑,sql 版本的swith case SELECT Oldvote, (CASE THEN (SELECT NOW() from dual) END) as "number" ...
- flink hadoop yarn
新一代大数据处理引擎 Apache Flink https://www.ibm.com/developerworks/cn/opensource/os-cn-apache-flink/ 新一代大数据处 ...