
【NLP_Stanford课堂】文本分类2
一、实验评估参数

实验数据本身可以分为是否属于某一个类(即correct和not correct),表示本身是否属于某一类别上,这是客观事实;又可以按照我们系统的输出是否属于某一个类(即selected和not selected),表示是否分到某一类别,这是实验输出。
以垃圾邮件为例:
tp:表示系统认为它是垃圾邮件,而确实它是垃圾邮件,所以为true positive
fn:表示系统不认为它是垃圾邮件,但它其实是垃圾邮件,所以为false negative
fp:表示系统认为是,其实不是,所以为false positive
tn:表示系统认为不是,确实也不是,所以是true negative
对于检测垃圾邮件,只用检测正确率,正确的部分则为tp和tn,所以正确率Acc=(tp+tn)/(tp+fp+fn+tn)
但是如果换一个语境:现在我们要在一篇文档中检测出现的鞋的牌子
那么假设文档中有100,000个词,其中10个是鞋的牌子,99,990个是其他词,如果我们的系统检测出来的鞋的牌子是0个,100,000个词是其他词,那么正确率反而是Acc=99,990/100,000=99.99%,但是显然是不准确的,系统根本没有做任何事,甚至我们用一行代码:for each word: return false。就可以实现,所以在这种情况下,正确率是无法合理评估的,我们更关注的是tp的部分,因此需要用准确率和召回率来评估。
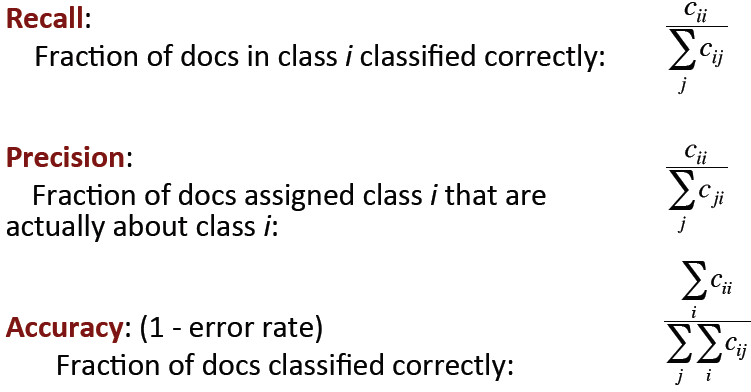
Precision准确率(查准率):selected的部分中正确的比例,tp/(tp+fp)
Recall召回率(查全率):正确的部分中selected的比例,tp/(tp+fn)
两者是相斥的,相加为1,所以召回率越高,准确率反而越低,需要权衡两者,看是查准重要还是查全重要?
the F measure:综合考虑准确率和召回率,为加权调和平均数:

α值取决于作者本身对于应用的评估是查准重要还是查全重要。α=1/(β^2+1)
一般使用F1 measure, 即β=1(即,α=1/2),从而F=2PR/(P+R)
二、实验评估通用数据集
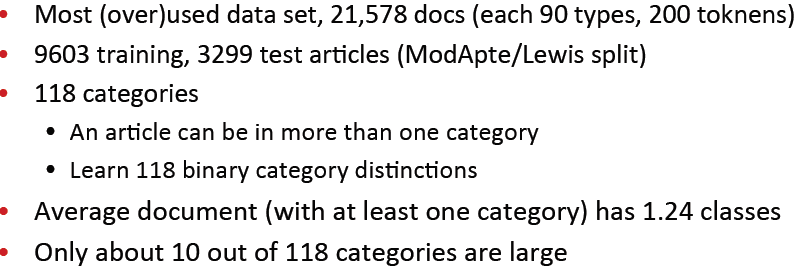
Reuters-21578 Data Set:

混淆矩阵:
横纵坐标为类别,对于每一对<c1,c2>, 其值表示属于c1的文档被错误分到c2的数目,如下:
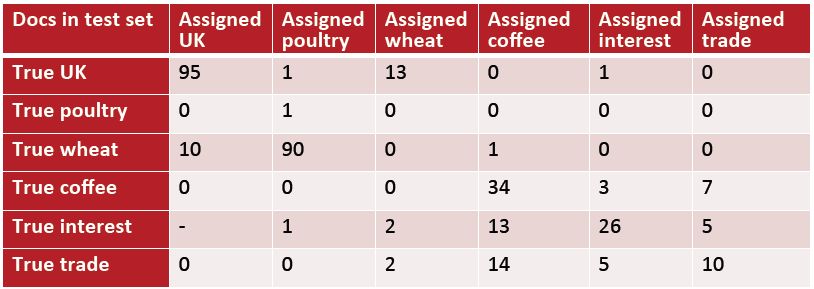
横坐标表头“True XX”表示真实的类别,纵坐标表头“Assigned XX”表示分类器分配的类别。
对角线表示正确分配类别的文档数目。
使用混淆矩阵可以计算各种评估参数:
如果有多个类别,如何结合多项实验参数得到一个参数用以评估:
方法1:Macroaveraging:为每一个类别计算一个值,然后取平均值
方法2:Microaveraging:收集每个类别中的决定,然后计算一个列联表,然后评估
实例:

数据集分为:

在开发测试集中计算各项评估参数:P/R/F1或Accuracy
然后按照评估参数修改模型,继续在训练集中训练模型。
而测试集要求数据跟前两个数据集完全不同,即unseen不可见,这是为了:
- 避免过度拟合
- 对性能的估计更保守
交叉验证:

从训练集中切割出部分开发测试集,然后我们将从每次分割中共享开发测试集的评估结果,然后计算总的开发集性能。从而避免开发测试集过小或者不具有代表性的问题。最后用不可见的测试集验证模型性能。
三、文本分类中的实际问题
1. 没有训练集怎么办?
使用手写规则:非常耗时耗力
2. 训练集很小怎么办?
- 使用Naive Bayes算法:即使训练数据很少,也不至于太过度拟合训练数据
- 获得更多的标签数据:一般也是手动
- 使用半监督训练方法:Bootstrapping, EM over unlabeled documents,...
3. 有足够的训练集
可以尝试任何分类器:SVM、逻辑回归、甚至决策树。
决策树是可以解释的,用户也是乐于去建立决策树的
4. 训练集非常庞大
那就可以达到很高的accuracy正确率,但是大部分分类器比如SVM、KNN都非常慢,逻辑回归会好一些,这种时候训练Naive Bayes反而会非常有效。
实验证明:当数据集非常庞大时,不同的分类器的正确率反而很相近
5. Naive Bayes中的一些关键问题
1)预防下溢:
因为多个小数相乘会导致接近于0。
通过转换成log、将乘法转换为加法可以解决这个问题
2)怎么调整性能:
- 按照领域挑选特定的特征和权重
- 对某些词增加它的计数,即出现一次的时候记成两次,比如:标题、每段的第一句、包含标题单词的句子中的单词
【NLP_Stanford课堂】文本分类2的更多相关文章
- 【NLP_Stanford课堂】文本分类1
文本分类实例:分辨垃圾邮件.文章作者识别.作者性别识别.电影评论情感识别(积极或消极).文章主题识别及任何可分类的任务. 一.文本分类问题定义: 输入: 一个文本d 一个固定的类别集合C={c1,c2 ...
- Tensorflow二分类处理dense或者sparse(文本分类)的输入数据
这里做了一些小的修改,感谢谷歌rd的帮助,使得能够统一处理dense的数据,或者类似文本分类这样sparse的输入数据.后续会做进一步学习优化,比如如何多线程处理. 具体如何处理sparse 主要是使 ...
- Atitti 文本分类 以及 垃圾邮件 判断原理 以及贝叶斯算法的应用解决方案
Atitti 文本分类 以及 垃圾邮件 判断原理 以及贝叶斯算法的应用解决方案 1.1. 七.什么是贝叶斯过滤器?1 1.2. 八.建立历史资料库2 1.3. 十.联合概率的计算3 1.4. 十一. ...
- 基于weka的文本分类实现
weka介绍 参见 1)百度百科:http://baike.baidu.com/link?url=V9GKiFxiAoFkaUvPULJ7gK_xoEDnSfUNR1woed0YTmo20Wjo0wY ...
- LingPipe-TextClassification(文本分类)
What is Text Classification? Text classification typically involves assigning a document to a catego ...
- 文本分类之特征描述vsm和bow
当我们尝试使用统计机器学习方法解决文本的有关问题时,第一个需要的解决的问题是,如果在计算机中表示出一个文本样本.一种经典而且被广泛运用的文本表示方法,即向量空间模型(VSM),俗称“词袋模型”. 我们 ...
- R语言做文本挖掘 Part4文本分类
Part4文本分类 Part3文本聚类提到过.与聚类分类的简单差异. 那么,我们需要理清训练集的分类,有明白分类的文本:測试集,能够就用训练集来替代.预測集,就是未分类的文本.是分类方法最后的应用实现 ...
- Spark ML下实现的多分类adaboost+naivebayes算法在文本分类上的应用
1. Naive Bayes算法 朴素贝叶斯算法算是生成模型中一个最经典的分类算法之一了,常用的有Bernoulli和Multinomial两种.在文本分类上经常会用到这两种方法.在词袋模型中,对于一 ...
- 文本分类学习(三) 特征权重(TF/IDF)和特征提取
上一篇中,主要说的就是词袋模型.回顾一下,在进行文本分类之前,我们需要把待分类文本先用词袋模型进行文本表示.首先是将训练集中的所有单词经过去停用词之后组合成一个词袋,或者叫做字典,实际上一个维度很大的 ...
随机推荐
- CSAPP阅读笔记-变长栈帧,缓冲区溢出攻击-来自第三章3.10的笔记-P192-P204
一.几个关于指针的小知识点: 1. malloc是在堆上动态分配内存,返回的是void *,使用时会配合显式/隐式类型转换,用完后需要用free手动释放. alloca是标准库函数,可以在栈上分配任 ...
- Axure原型设计介绍
在第八周的课堂上,王文娟老师在校园系统上发布了对于自行选择的原型设计软件进行资料查找以及自学的任务.因为之前的课程学习需要,我们大概掌握了原型设计软件Axure的使用,下面是一些我们学习过程中的介绍 ...
- 【DB2】普通用户最小查询权限分配
1. 通过实例用户或者有dbadm权限的用户连接数据库 db2 connect to <db-name> 2. 分配普通用户连接权限db2 "grant connect on d ...
- (转)heartbeat原理及部署
原文:http://yjy724.blog.51cto.com/10897133/1840794---------------------------------------------------h ...
- 判断title(title_is)
判断 title 获取页面 title 的方法可以直接用 driver.title 获取到,然后也可以把获取到的结果用做断言.本篇介绍另外一种方法去判断页面 title 是否与期望结果一种,用到上一篇 ...
- 关于window.console&&console.log(123)的思考
一.JS的且运算记得最开始看到window.console&&console.log(123),当时知道能起什么作用但是没有深入研究,最近在研究后总算弄明白了.要理解这个,首先得明白三 ...
- vue 坑之 vuex requires a Promise polyfill in this browser
android内嵌H5页面不显示出现这个问题,原因有很多 首先,别急,请看下面的推荐方案: 1.找个Android真机测试下(机型版本为4.4以上),真机联调测试 Android 只需要四个步骤: 1 ...
- 解决Eclipse中Android SDK Manager图标不见了的问题
在Eclipse中安装完ADT后,发现 Android SDK Manager图标不见了,Android Virtual Device Manager图标也不见了. 解决这个问题,可用如下方法: 打开 ...
- 入门系列之在Ubuntu上使用MySQL设置远程数据库优化站点性能
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 本文由苏子晨 发表于云+社区专栏 介绍 随着您的应用程序或网站的增长,您可能已经超出了当前的服务器设置.如果您在同一台计算机上托管Web服务 ...
- 关于React Hooks,你不得不知的事
React Hooks是React 16.8发布以来最吸引人的特性之一.在开始介绍React Hooks之前,让咱们先来理解一下什么是hooks.wikipedia是这样给hook下定义的: In c ...