
借助Numpy,优化Pandas的条件检索代码
Numpy其实是最早的处理数据的Python库,它的核心ndarray对象,是一个高效的n维数组结构。
通过这个库,可以高效的完成向量和矩阵运算,由于其出色的性能,很多其他的数据分析,科学计算或者机器学习相关的Python库都或多或少的依赖于它。
Pandas就是其中之一,Pandas充分利用了NumPy的数组运算功能,使得数据处理和分析更加高效。
比如,Pandas中最重要的两个数据结构Series和DataFrame在内部就使用了NumPy的ndarray来存储数据。
在使用Pandas进行数据分析的过程中,按条件检索和过滤数据是最频繁的操作。
本文介绍两种通过结合Numpy,一方面让Pandas的检索过滤代码更加简洁易懂,另一方面还能保障检索过滤的高性能。
1. 准备数据
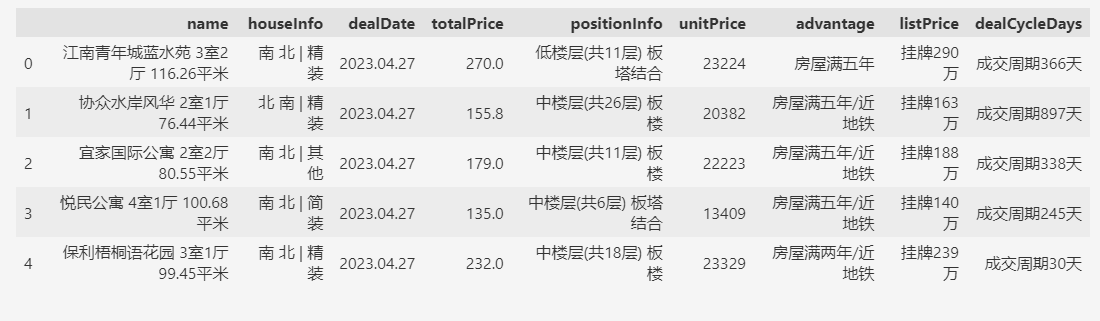
第一步,先准备数据,这次使用二手房交易数据,可从 https://databook.top/lianjia/nj 下载。
import pandas as pd

import numpy as np

# 这个路径替换成自己的路径

fp = r'D:\data\南京二手房交易\南京江宁区.csv'

df = pd.read_csv(fp)

df.head()
2. 一般条件判断(np.where)
比如,买房前我们想先分析下已有的成交信息,对于房价能有个大致的印象。
下面,按照总价和单价,先挑选总价200~300万之间,或者单价1万以下的成交信息。
符合条件返回“OK”,否则返回“NG”。
def filter_data(row):

    if row["totalPrice"] > 200 and row["totalPrice"] < 300:

        return "OK"

    if row["unitPrice"] < 10000:

        return "OK"

    return "NG"

df["评估"] = df.apply(filter_data, axis=1)

df[df["评估"] == "OK"].head()
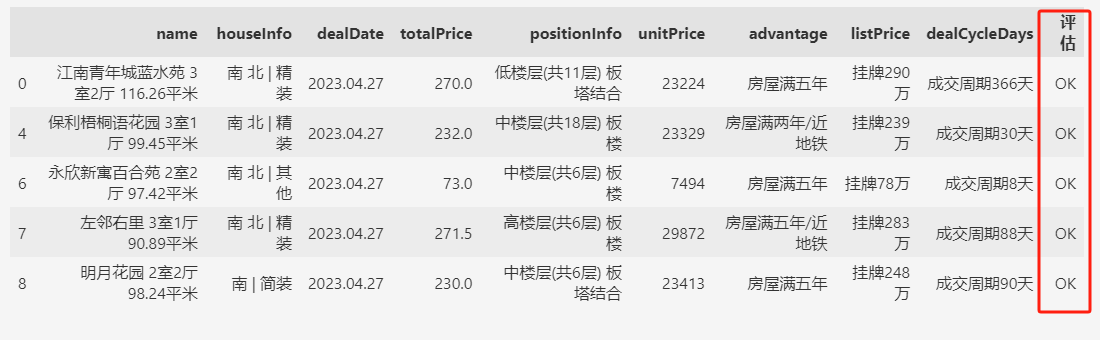
上面的过滤数据写法是使用Pandas时用的比较多的方式,也就是将过滤条件封装到一个自定义函数(filter_data)中,然后通过 apply 函数来完成数据过滤。
下面我们用Numpy的 np.where 接口来改造上面的代码。np.where类似Python编程语言中的if-else判断,基本语法:
import numpy as np

np.where(condition[, x, y])
其中:
- condition:条件表达式,返回布尔数组。
- x 和 y:可选参数,
condition为True,返回x,反之,返回y。
如果未提供x 和 y,则函数仅返回满足条件的元素的索引。
改造后的代码如下:
# 根据单价过滤

cond_unit_price = np.where(

    df["unitPrice"] < 10000,

    "OK",

    "NG",

)

# 先根据总价过滤,不满足条件再用单价过滤

cond_total_price = np.where(

    (df["totalPrice"] > 200) & (df["totalPrice"] < 300),

    "OK",

    cond_unit_price,

)

df["评估"] = cond_total_price

df[df["评估"] == "OK"].head()
运行之后返回的结果是一样的,但是性能提升很多。
如果数据量是几十万量级的话,你会发现改造之后的代码运行效率提高了几百倍。
3. 复杂多条件判断(np.select)
上面的示例中,判断还比较简单,属于if-else,也就是是与否的判断。
下面设计一种更复杂的判断,将成交信息评估为“优良中差”4个等级,而不仅仅是“OK”和“NG”。
我们假设:
- 优:房屋精装,且位于中楼层,且近地铁
- 良:总价<300,且近地铁
- 中:总价<400
- 差:其他情况
用传统的方式,同样是封装一个类似filter_data的函数来判断“优良中差”4个等级,然后用 apply 函数来完成数据过滤。
这里就不演示了,直接看结合Numpy的np.select接口,高效的完成“优良中差”4个等级的过滤。
np.select类似Python编程语言中的match匹配,基本语法:
numpy.select(condlist, choicelist, default=0)
其中:
- condlist:条件列表,每个条件都是一个布尔数组。
- choicelist:与 condlist 对应的数组列表,当某个条件为真时,返回该位置对应的数组中的元素。
- default:可选参数,当没有条件为真时返回的默认值。
# 设置 “优,良,中” 的判断条件

conditions = [

    df["houseInfo"].str.contains("精装")

    & df["positionInfo"].str.contains("中楼层")

    & df["advantage"].str.contains("近地铁"),

    (df["totalPrice"] < 300) & df["advantage"].str.contains("近地铁"),

    df["totalPrice"] < 400,

]

choices = ["优", "良", "中"]

# 默认为 “差”

df["评估"] = np.select(conditions, choices, default="差")

df.head()
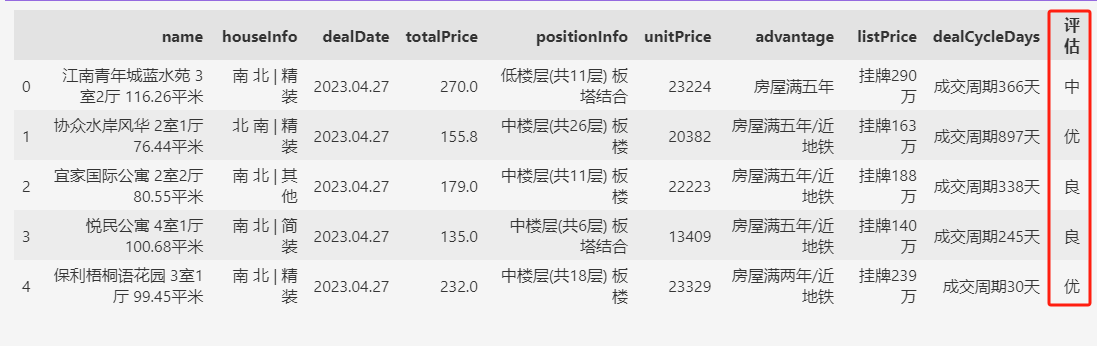
这样,就实现了一个对成交信息的分类。
4. 总结
np.where 和 np.select的底层都是向量化的方式来操作数据,执行效率非常高。
所以,我们在使用Pandas分析数据时,应尽量使用np.where 和 np.select来帮助我们过滤数据,这样不仅能够让代码更加简洁专业,而且能够极大的提高分析性能。
借助Numpy,优化Pandas的条件检索代码的更多相关文章
- numpy、pandas
numpy: 仨属性:ndim-维度个数:shape-维度大小:dtype-数据类型. numpy和pandas各def的axis缺省为0,作用于列,除DataFrame的.sort_index()和 ...
- NumPy和Pandas常用库
NumPy和Pandas常用库 1.NumPy NumPy是高性能科学计算和数据分析的基础包.部分功能如下: ndarray, 具有矢量算术运算和复杂广播能力的快速且节省空间的多维数组. 用于对整组数 ...
- python安装numpy和pandas
最近要对一系列数据做同比比较,需要用到numpy和pandas来计算,不过使用python安装numpy和pandas因为linux环境没有外网遇到了很多问题就记下来了.首要条件,python版本必须 ...
- 如何快速地从mongo中提取数据到numpy以及pandas中去
mongo数据通常过于庞大,很难一下子放进内存里进行分析,如果直接在python里使用字典来存贮每一个文档,使用list来存储数据的话,将很快是内存沾满.型号拥有numpy和pandas import ...
- [转] python安装numpy和pandas
最近要对一系列数据做同比比较,需要用到numpy和pandas来计算,不过使用python安装numpy和pandas因为linux环境没有外网遇到了很多问题就记下来了.首要条件,python版本必须 ...
- Python 工匠:编写条件分支代码的技巧
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 本文由鹅厂优文发表于云+社区专栏 作者:朱雷 | 腾讯IEG高级工程师 『Python 工匠』是什么? 我一直觉得编程某种意义是一门『手艺』 ...
- numpy和pandas简单使用
numpy和pandas简单使用 import numpy as np import pandas as pd 一维数据分析 numpy中使用array, pandas中使用series numpy一 ...
- Python入门之安装numpy和pandas
最近要对一系列数据做同比比较,需要用到numpy和pandas来计算,不过使用python安装numpy和pandas因为linux环境没有外网遇到了很多问题就记下来了. 首要条件,python版本必 ...
- asp.net用三层实现多条件检索
众所周知,三层将项目分为界面层,业务逻辑层和数据訪问层(以最主要的三层为例) 相同都知道,多条件检索事实上就是依据用户选择的条件项,然后来拼sql语句 那么.既然要依据用户选择的条件项来拼sql语句, ...
- 【转载】python安装numpy和pandas
转载:原文地址 http://www.cnblogs.com/lxmhhy/p/6029465.html 最近要对一系列数据做同比比较,需要用到numpy和pandas来计算,不过使用python安装 ...
随机推荐
- BZOJ3156 防御准备 题解
原题 令 \(S_{i} =\sum\limits_{j=1}^{i}j\) , \(f_{i}\) 为处理到第 \(i\) 个位置放置守卫塔的最小花费. 观察题意,容易得到在\((1 \le j \ ...
- LGV引理
LGV引理是用来统计DAG中固定若干起点和终点情况下的选择不相交链的方案数的. 同样用来优化计数问题,但是比Pólya定理友好多了,这也就是为什么它能够被直接糊到NOI考场上. 对于一张DAG,每条边 ...
- JS LeetCode 566. 重塑矩阵题解分析,数组降维的几种方式
壹 ❀ 引 今天是过完年到公司的第二天,年前因为封版,到今天我们小组是第一个发版的组,然后就各种踩坑,到现在还在公司等运维解决jenkins问题,闲着也是闲着,做一道算法题,简单记录下解题思路,本题来 ...
- java generic 介绍
一 介绍: 在Java SE 1.5之前,没有泛型的情况的下,通过对类型Object的引用来实现参数的"任意化","任意化"带来的缺点是要做显式的强制类型转换, ...
- virtualapp安装应用流程源码分析
1. HomeActivity 为处理的入口 @Override protected void onActivityResult(int requestCode, int resultCode, In ...
- java+文件实现的超市管理系统
一.需求 1.使用java语言实现系统 2.数据存储使用io读写文件 3.超市的商品管理+销售功能 二.效果 商品列表 商品增删改查 购买 三.说明 1.开发工具/技术 java eclipse 2 ...
- Ubuntu虚拟机开机显示initramfs
因为我的虚拟机路径放在了移动硬盘当中,所以连接有点失常就断开了,紧接着虚拟机也异常关闭了. 重启后进入了initramfs界面 查看出错的分区,如下图所示,是/dev/sda5分区有损坏 解决方法: ...
- JS内存爆破问题
原理 检测到调试,格式化等,疯狂的在js文件,或者html中进行读写,cookie重写追加,字节追加,导致内存不足够,卡死 内存爆破,指js通过死循环/频繁操作数据库(包括cookie)/频繁调取hi ...
- CUDA、CUDNN 安装
安装 CUDA.CUDNN 1. CUDA CUDA 是 NVIDIA 发明的一种并行计算平台和编程模型.它通过利用图形处理器 (GPU) 的处理能力,可大幅提升计算性能. 官方地址 https:// ...
- OFDM系统各种QAM调制阶数在多径信道下的误码性能仿真(暂存版本)
本文考虑OFDM系统在多径信道下的误码性能 代码 clc;close all;clear %% Seting parameters EbN0_list = 20:2:40; Q_order_list ...