
Docker最全教程之Python爬网实战(二十一)
Python目前是流行度增长最快的主流编程语言,也是第二大最受开发者喜爱的语言(参考Stack Overflow 2019开发者调查报告发布)。笔者建议.NET、Java开发人员可以将Python发展为第二语言,一方面Python在某些领域确实非常犀利(爬虫、算法、人工智能等等),另一方面,相信我,Python上手完全没有门槛,你甚至无需购买任何书籍!
由于近期在筹备4.21的长沙开发者大会,耽误了不少时间。不过这次邀请到了腾讯资深技术专家、.NET中国社区领袖,微软MVP张善友;52ABP开源框架的作者,微软MVP梁桐铭;知名技术类作家汪鹏,腾讯高级工程师卓伟,腾讯云高级产品经理胡李伟等等,有兴趣参加的朋友可以点击公众号菜单【联系我们】==>【报名】进行报名,技术不分语言,亦没有界限,期待和你分享、交流!
目录
关于Python
官方镜像
使用Python抓取博客列表
需求说明
了解Beautiful Soup
分析并获取抓取规则
编写代码实现抓取逻辑
编写Dockerfile
运行并查看抓取结果
关于Python
Python是一种计算机程序设计语言。是一种动态的、面向对象的脚本语言,最初被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新功能的添加,越来越多被用于独立的、大型项目的开发。Python目前是流行度增长最快的主流编程语言,也是第二大最受开发者喜爱的语言(参考Stack Overflow 2019开发者调查报告发布)。
Python是一种解释型脚本语言,可以应用于以下领域:
- Web 和 Internet开发
- 科学计算和统计
- 教育
- 桌面界面开发
- 软件开发
- 后端开发
Python学习起来没有门槛,但是通过它,你可以用更短的时间,更高的效率学习和掌握机器学习,甚至是深度学习的技能。不过单单只会Python对大多数人来说是不行的,你最好还掌握一门静态语言(.NET/Java)。同时,笔者也建议.NET、Java开发人员可以将Python发展为第二语言,一方面Python在某些领域确实非常犀利(爬虫、算法、人工智能等等),另一方面,相信我,Python上手完全没有门槛,你甚至无需购买任何书籍!
官方镜像
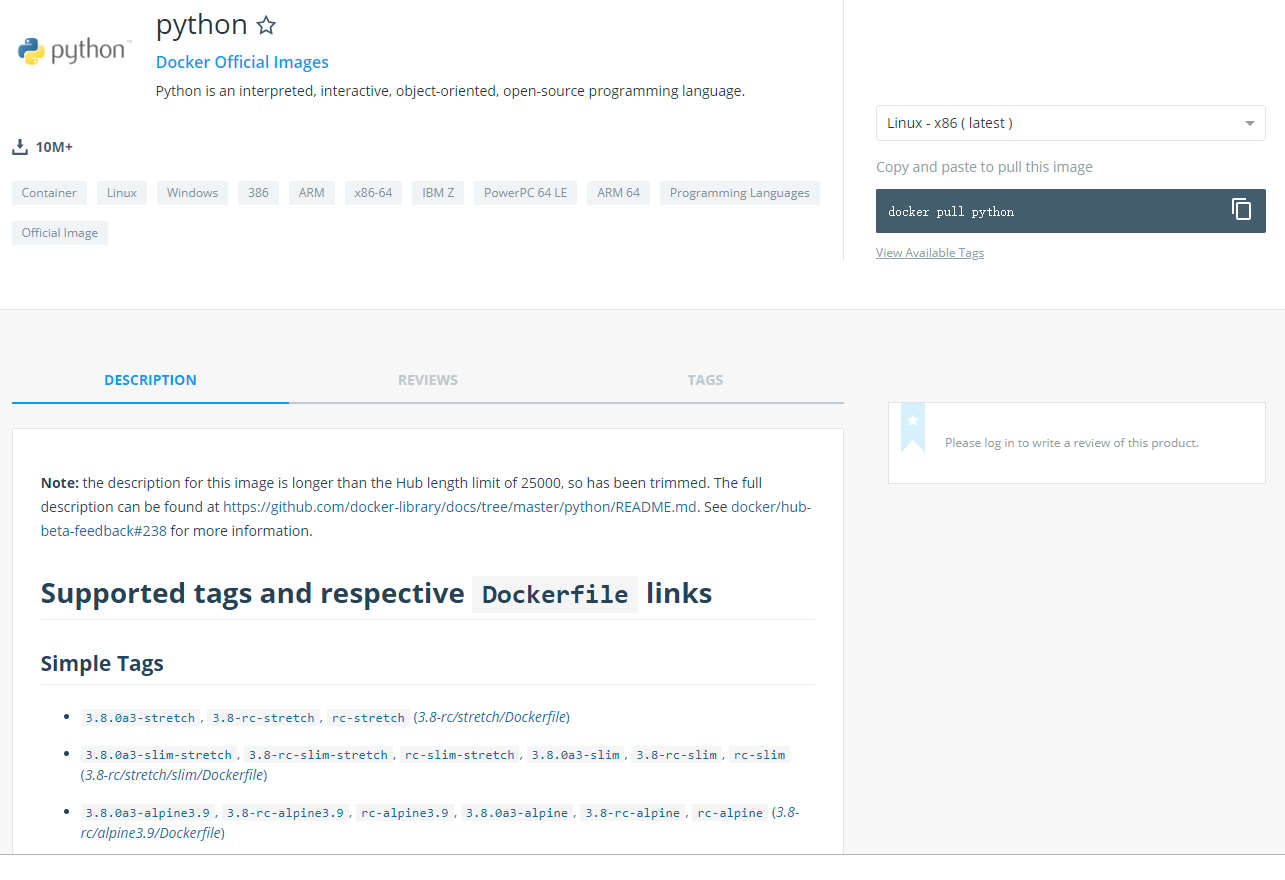
官方镜像地址:https://hub.docker.com/_/python
注意,请认准官方镜像:
使用Python抓取博客列表
需求说明
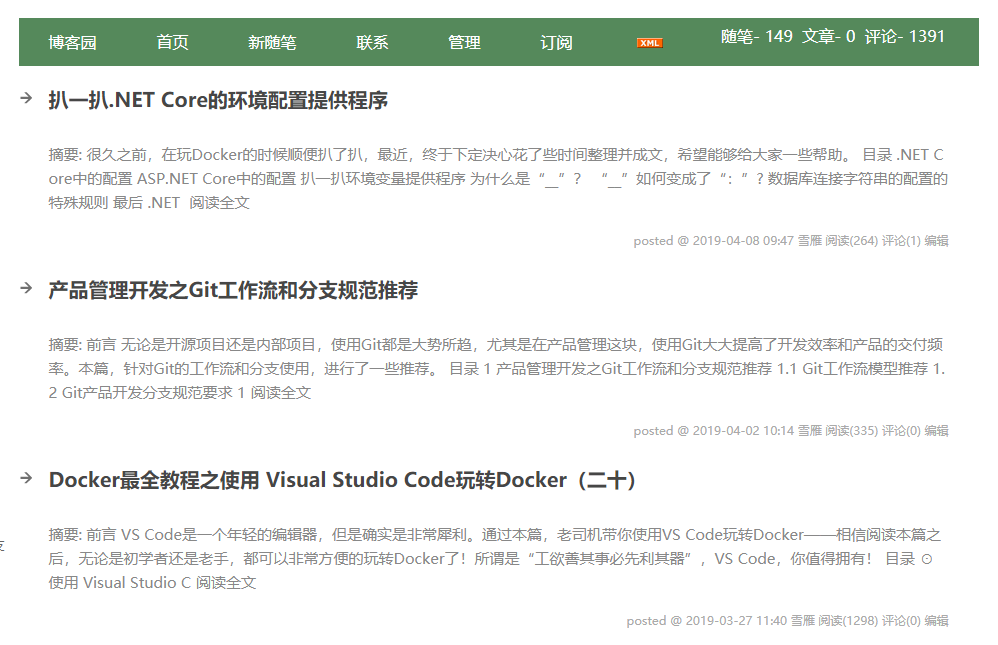
本篇使用Python来抓取我的博客园的博客列表,打印出标题、链接、日期和摘要。
博客地址:http://www.cnblogs.com/codelove/
内容如下所示:
了解Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库,支持多种解析器。Beautiful Soup简单的说,就是一个灵活又方便的网页解析库,是一个爬网利器。本篇教程我们就基于Beautiful Soup来抓取博客数据。
Beautiful Soup官方网站:https://beautifulsoup.readthedocs.io
主要解析器说明:

分析并获取抓取规则
首先我们使用Chrome浏览器打开以下地址:http://www.cnblogs.com/codelove/
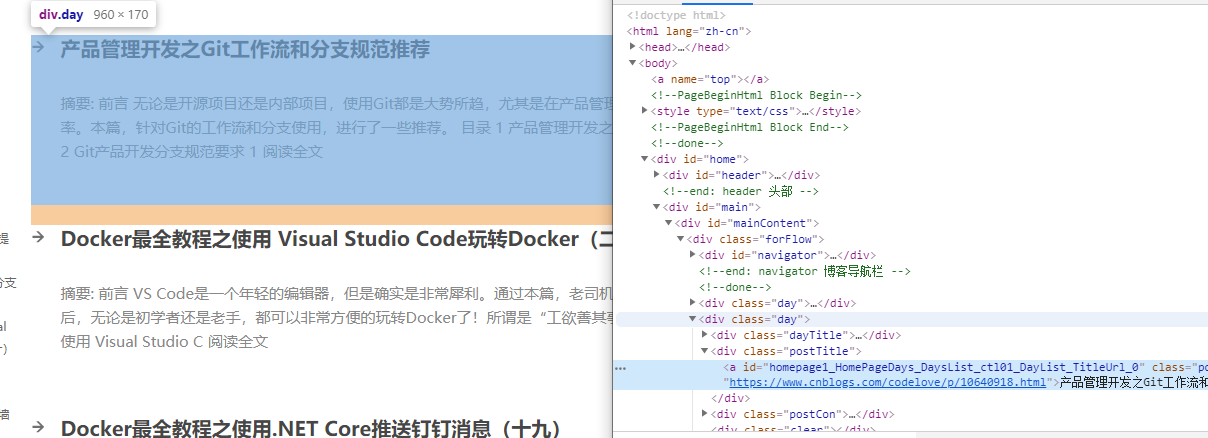
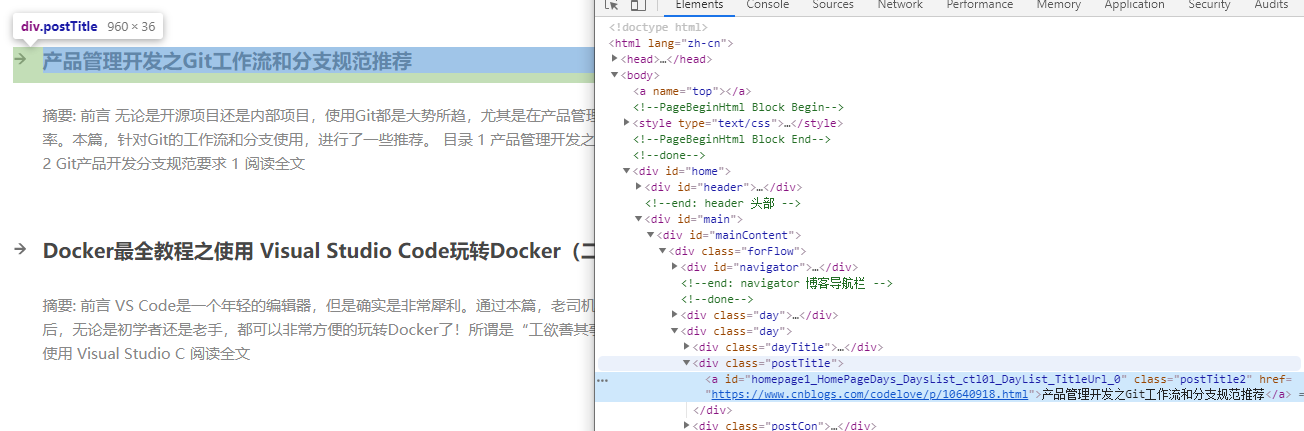
然后按下F12打开开发人员工具,通过工具我们梳理了以下规则:
- 博客块(div.day)
- 博客标题(div. postTitle a)
- 其他内容获取,如日期、博客链接、简介,这里我们就不截图了。
然后我们通过观察博客路径,获取到url分页规律:
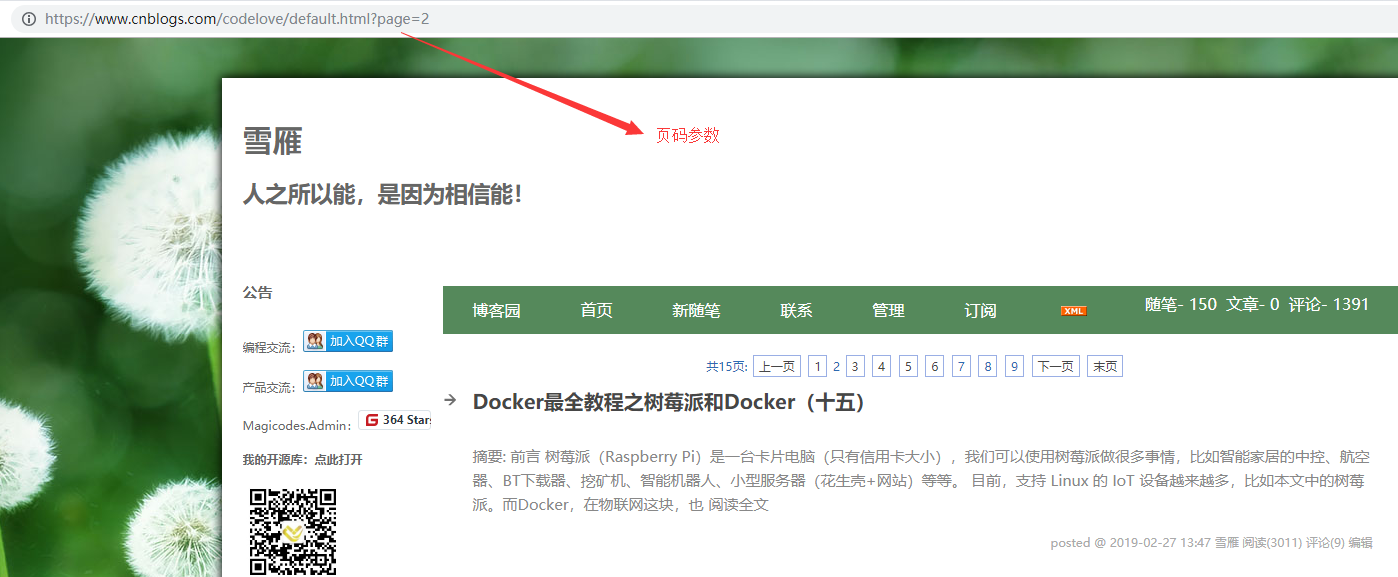
根据以上分析,我们胸有成竹,开始编码。
编写代码实现抓取逻辑
在编码前,请阅读BeautifulSoup官方文档。然后根据需求,我们编写Python的代码如下所示:
# 关于BeautifulSoup,请阅读官方文档:https://beautifulsoup.readthedocs.io/zh_CN/v4.4.0/#id52

from bs4 import BeautifulSoup

import os

import sys

import requests

import time

import re

url = "https://www.cnblogs.com/codelove/default.html?page={page}"

#已完成的页数序号,初时为0

page = 0

while True:

    page += 1

    request_url = url.format(page=page)

    response = requests.get(request_url)

    #使用BeautifulSoup的html5lib解析器解析HTML(兼容性最好)

    html = BeautifulSoup(response.text,'html5lib')

    #获取当前HTML的所有的博客元素

    blog_list = html.select(".forFlow .day")

    # 循环在读不到新的博客时结束

    if not blog_list:

        break

    print("fetch: ", request_url)

    for blog in blog_list:

        # 获取标题

        title = blog.select(".postTitle a")[0].string

        print('--------------------------'+title+'--------------------------');

        # 获取博客链接

        blog_url = blog.select(".postTitle a")[0]["href"]

        print(blog_url);

        # 获取博客日期

        date = blog.select(".dayTitle a")[0].get_text()

        print(date)

        # 获取博客简介

        des = blog.select(".postCon > div")[0].get_text()

        print(des)

        print('-------------------------------------------------------------------------------------');
如上述代码所示,我们根据分析的规则循环翻页并且从每一页的HTML中抽取出了我们需要的博客信息,并打印出来,相关代码已提供注释,这里我们就不多说了。
编写Dockerfile
代码写完,按照惯例,我们仍然是使用Docker实现本地无SDK开发,因此编写Dockerfile如下所示:
# 使用官方镜像

FROM python:3.7-slim

# 设置工作目录

WORKDIR /app

# 复制当前目录

COPY . /app

# 安装模块

RUN pip install --trusted-host pypi.python.org -r requirements.txt

# Run app.py when the container launches

CMD ["python", "app.py"]
注意,由于我们使用到了比如beautifulsoup等第三方库,因此我们需要安装相关模块。requirements.txt内容如下所示(注意换行):
html5lib
beautifulsoup4
requests
运行并查看抓取结果
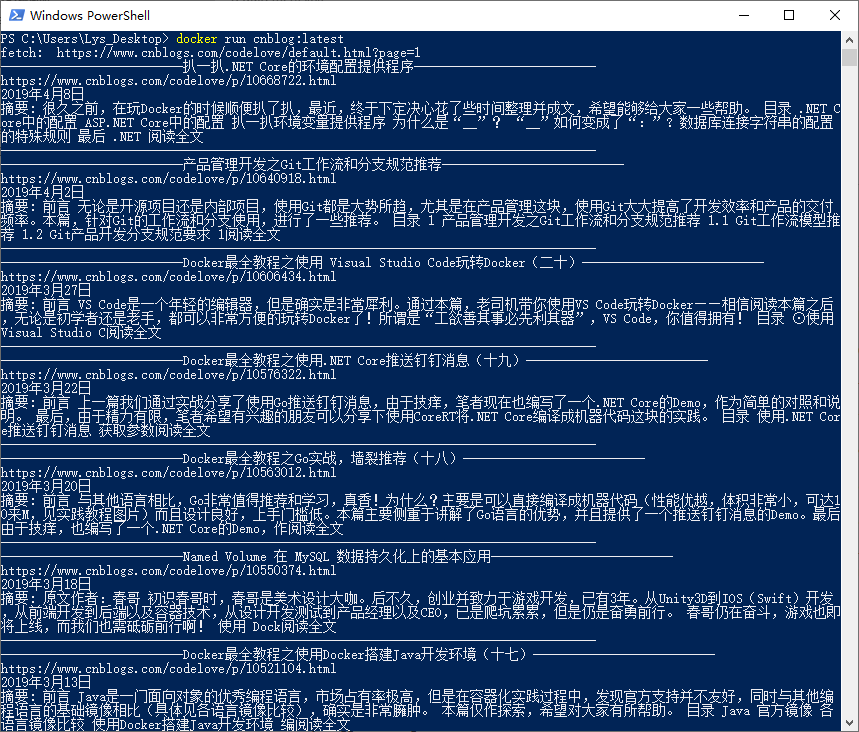
构建完成后,我们运行起来结果如下所示:
Docker最全教程之Python爬网实战(二十一)的更多相关文章
- Docker最全教程之MySQL容器化 (二十四)
前言 MySQL是目前最流行的开源的关系型数据库,MySQL的容器化之前有朋友投稿并且写过此块,本篇仅从笔者角度进行总结和编写. 目录 镜像说明 运行MySQL容器镜像 1.运行MySQL容器 ...
- Docker最全教程之Go实战,墙裂推荐(十八)
前言 与其他语言相比,Go非常值得推荐和学习,真香!为什么?主要是可以直接编译成机器代码(性能优越,体积非常小,可达10来M,见实践教程图片)而且设计良好,上手门槛低.本篇主要侧重于讲解了Go语言的优 ...
- Docker最全教程之Ubuntu下安装Docker(十四)
前言 Ubuntu是一个以桌面应用为主的开源GNU/Linux操作系统,应用很广.本篇主要讲述Ubuntu下使用SSH远程登录并安装Docker,并且提供了Docker安装的两种方式,希望对大家有所帮 ...
- Python爬网获取全国各地律师电话号
[本文出自天外归云的博客园] 从64365网站获取全国各地律师电话号,用到了python的lxml库进行对html页面内容的解析,对于xpath的获取和正确性校验,需要在火狐浏览器安装firebug和 ...
- Python爬网——获取安卓手机统计数据
[本文出自天外归云的博客园] 1. 在安卓网上对热门机型进行爬网,取前五十: # -*- coding: utf-8 -*- import requests,re from bs4 import Be ...
- 学习廖雪峰的Python教程之Python基础
一.缩进 编译器或者解释器就是负责把符合语法的程序代码转换成CPU能够执行的机器码,然后执行. 以#开头的语句是注释,注释是给人看的,可以是任意内容,解释器会忽略掉注释.其他每一行都是一个语句,当语句 ...
- Docker最全教程——MongoDB容器化(十二)
MongoDB容器化 MongoDB是一个免费的.开源的.跨平台分布式面向文档存储的数据库,由C++语言编写.旨在为WEB应用提供可扩展的高性能数据存储解决方案. MongoDB是一个介于关系数据库和 ...
- go语言开发教程之web项目开发实战
Golang介绍Go语言是谷歌推出的一种全新的编程语言,可以在不损失应用程序性能的情况下降低代码的复杂性.谷歌首席软件工程师罗布派克(Rob Pike)说:我们之所以开发Go,是因为过去10多年间软件 ...
- Web攻防系列教程之 Cookie注入攻防实战
摘要:随着网络安全技术的发展,SQL注入作为一种很流行的攻击方式被越来越多的人所知晓.很多网站也都对SQL注入做了防护,许多网站管理员的做法就是添加一个防注入程序.这时我们用常规的手段去探测网站的SQ ...
随机推荐
- 让程序跳转到绝对地址0x100000去执行
网上比较火的一个题,让程序跳转到绝对地址去执行 :可以的实现方式为: ( (void(*)())0x4110e6)(); (*(void(*)())0x4110e6)(); (*((void(*)() ...
- 虚拟机配置Openstack常见问题汇总
之前配置了openstack,遇到一些问题,现在将问题全部汇总记录在这里. (1)问题:主机名字修改不了: 原因:没有进入root状态:或者没有正确打开文件,要打开的是/etc/hostname,结果 ...
- iOS xcode9 framework静态库的创建以及xib和图片的使用记录
来到了新公司,要开发的第一个项目据说可能要封成framework,可是我从来没自己做过framework呀!顿时开始发愤图强,赶紧恶补了起来.但是还是遇到了一些乱七八糟的情况,所以写个随笔记下来. 1 ...
- 微信小程序开发入门:10分钟从0开始写一个hello-world
小程序开发需要三个描述整体程序的app文件 和 一个描述多个页面的 pages文件夹. (1)三个app文件分别是app.js,app.json,app.wxss. app.js文件是脚本文件处理一些 ...
- 从CSDN到cnblogs
博客热的年代,我也赶潮流,开了不少,以前的blogbus博客大巴,CSDN,以及MSN space,再到新浪博客,微博... 提笔写的热情越来越少,这次准备重新整理以前在CSTQB.业界分享的一些内容 ...
- 如何离线安装python的whl库
对于使用公司内网环境办公的人来说,可能无法使用pip install 命令安装python的whl库.对于这种情况,我们可以用以下的方法安装一个whl库. 1 下载whl文件,下载时注意,whl文件的 ...
- UsernamePasswordAuthenticationToken
UsernamePasswordAuthenticationToken继承AbstractAuthenticationToken实现Authentication所以当在页面中输入用户名和密码之后首先会 ...
- PHP与XML技术
XML的概述 XML(eXtensibleMarkup Language),扩展性标记语言,它是用来描述其他语言的语言.它允许用户设计自己的标记.XML是由W3C(WorldWide 月发布的一种标准 ...
- python selenium-webdriver 元素操作之键盘操作
selenium 提供了比较完整的键盘操作,在使用的模拟键盘操作之前需要我们导入from selenium.webdriver.common.keys import Keys即可,然后就可以来模拟键盘 ...
- linux学习之路(3)
vim编辑器使用 命令模式:控制光标移动,可对文本进行复制.粘贴.删除和查找等工作. 输入模式:正常的文本录入. 末行模式:保存或退出文档,以及设置编辑环境. vim中常用命令: dd 删除(剪切) ...