
最大似然估计(MLE)与最大后验概率(MAP)
- 何为:最大似然估计(MLE):
最大似然估计提供了一种给定观察数据来评估模型参数的方法,即:“模型已定,参数未知”。可以通过采样,获取部分数据,然后通过最大似然估计来获取已知模型的参数。
最大似然估计是一种统计方法,它用来求一个样本集的相关概率密度函数的参数。利用已知的样本结果,反推最有可能(最大概率)导致这样结果的参数值。
最大似然估计中采样需满足一个很重要的假设,就是所有的采样都是独立同分布(i.i.d)的。
最大似然估计的一般求解过程:
(1) 写出似然函数;
(2) 对似然函数取对数,并整理;
(3) 求导数 ;
(4) 解似然方程。
- 何为:最大后验概率(MAP):
最大后验估计是根据经验数据获得对难以观察的量的点估计。
与最大似然估计类似,但是最大的不同是,最大后验估计融入了要估计量的先验分布在其中。
故最大后验估计可以看做规则化的最大似然估计。
- 什么情况下,MAP=ML?
当模型的参数本身的概率是均匀的,即该概率为一个固定值的时候,二者相等。
当先验分布均匀之时,MAP 估计与 MLE 相等。下图是均匀分布的一个实例。
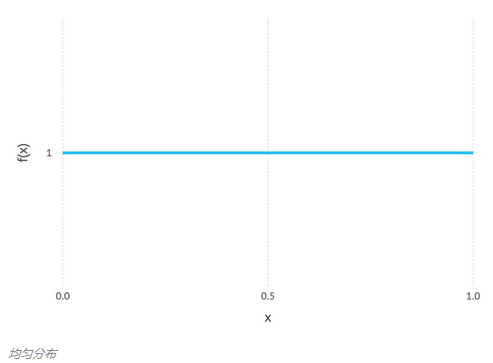
我们可以看到均匀分布给 X 轴(水平线)上的每个值分布相同的权重。直观讲,它表征了最有可能值的任何先验知识的匮乏。在这一情况中,所有权重分配到似然函数,因此当我们把先验与似然相乘,由此得到的后验极其类似于似然。因此,最大似然方法可被看作一种特殊的 MAP。
【Reference】
[2] Probability concepts explained: Maximum likelihood estimation
最大似然估计(MLE)与最大后验概率(MAP)的更多相关文章
- 机器学习基础系列--先验概率 后验概率 似然函数 最大似然估计(MLE) 最大后验概率(MAE) 以及贝叶斯公式的理解
目录 机器学习基础 1. 概率和统计 2. 先验概率(由历史求因) 3. 后验概率(知果求因) 4. 似然函数(由因求果) 5. 有趣的野史--贝叶斯和似然之争-最大似然概率(MLE)-最大后验概率( ...
- 萌新笔记——Cardinality Estimation算法学习(二)(Linear Counting算法、最大似然估计(MLE))
在上篇,我了解了基数的基本概念,现在进入Linear Counting算法的学习. 理解颇浅,还请大神指点! http://blog.codinglabs.org/articles/algorithm ...
- 最大似然估计(MLE)与最小二乘估计(LSE)的区别
最大似然估计与最小二乘估计的区别 标签(空格分隔): 概率论与数理统计 最小二乘估计 对于最小二乘估计来说,最合理的参数估计量应该使得模型能最好地拟合样本数据,也就是估计值与观测值之差的平方和最小. ...
- Cardinality Estimation算法学习(二)(Linear Counting算法、最大似然估计(MLE))
在上篇,我了解了基数的基本概念,现在进入Linear Counting算法的学习. 理解颇浅,还请大神指点! http://blog.codinglabs.org/articles/algorithm ...
- 补充资料——自己实现极大似然估计(最大似然估计)MLE
这篇文章给了我一个启发,我们可以自己用已知分布的密度函数进行组合,然后构建一个新的密度函数啦,然后用极大似然估计MLE进行估计. 代码和结果演示 代码: #取出MASS包这中的数据 data(geys ...
- 最大似然估计 (MLE) 最大后验概率(MAP)
1) 最大似然估计 MLE 给定一堆数据,假如我们知道它是从某一种分布中随机取出来的,可是我们并不知道这个分布具体的参,即"模型已定,参数未知". 例如,我们知道这个分布是正态分布 ...
- 最大似然估计 (MLE)与 最大后验概率(MAP)在机器学习中的应用
最大似然估计 MLE 给定一堆数据,假如我们知道它是从某一种分布中随机取出来的,可是我们并不知道这个分布具体的参,即“模型已定,参数未知”. 例如,对于线性回归,我们假定样本是服从正态分布,但是不知道 ...
- 【模式识别与机器学习】——最大似然估计 (MLE) 最大后验概率(MAP)和最小二乘法
1) 极/最大似然估计 MLE 给定一堆数据,假如我们知道它是从某一种分布中随机取出来的,可是我们并不知道这个分布具体的参,即“模型已定,参数未知”.例如,我们知道这个分布是正态分布,但是不知道均值和 ...
- 深度学习中交叉熵和KL散度和最大似然估计之间的关系
机器学习的面试题中经常会被问到交叉熵(cross entropy)和最大似然估计(MLE)或者KL散度有什么关系,查了一些资料发现优化这3个东西其实是等价的. 熵和交叉熵 提到交叉熵就需要了解下信息论 ...
- 最大似然估计(MLE)和最大后验概率(MAP)
最大似然估计: 最大似然估计提供了一种给定观察数据来评估模型参数的方法,即:“模型已定,参数未知”.简单而言,假设我们要统计全国人口的身高,首先假设这个身高服从服从正态分布,但是该分布的均值与方差未知 ...
随机推荐
- mOByDiC E90C2600 EOBD/OBDII to RS232 gateway
http://www.ozenelektronik.com/downs/pdf/oe90c2600.pdf Features • Compatible with EOBD/OBDII standard ...
- Small tips of APP H5 page
在开发日常落地页的时候,每当碰到一些很酷炫的宣传图用css实现很复杂且耗时的时候,一般采取切图然后将其放在页面中,在这个过程中发现<img/>标签中图片下方会有一行小空白,影响了与后一部分 ...
- CISC RISC架构
参考: http://capacity.blog.163.com/blog/static/20866413120129261737102/ http://cs.stanford.edu/people/ ...
- Android BottomNavigationBar底部导航控制器的使用
最近Google在自己推出的Material design中增加了Bottom Navigation导航控制.Android一直没有官方的导航控制器,自己实现确实是五花八门,有了这个规定之后,就类似苹 ...
- Nuget server on IIS6 returns 404
Nuget server on IIS6 returns 404 when downloading package after upgrade 2011年9月2日 8:03:30 (GMT Dayli ...
- iOS:二叉树多级表格的使用,使用三方库TreeTableView-master实现对json解析数据的递归遍历整理成树状结构
在项目中,我们有时需要使用二叉树来实现多级表格的递归遍历查询,如果对二叉树比较懂,那么写起来其实也不费事,为了节省开发时间,下面介绍一下第三方库TreeTableView-master,这个三方库上给 ...
- Android系统信息获取
在Android中可以通过android.os.Build这个类和System.getProperty(“xxx”);来获取设备信息,下面列举的常见设备信息摘自Android群英传 Build.BOA ...
- DICOMDIR
DICOMDIR 是一个可变长度 迷你 database 文件.由 group (0002, xxxx) 和 group (0004, xxxx) 为主题.描述的是一个 4 层的树状结构 (tree ...
- Informatica 常用组件Source Qualifier之五 User Defined Join
User defined join : 输入用户定义的联接与输入自定义 SQL 查询类似.但是,只需输入 WHERE 子句的内容,而不是整个查询. 添加用户定义的联接时,源限定符转换包括默认 ...
- 项目笔记:list页面展示与交互设计
1.前台页面: 因为要展示正版和非正版,所以传个Type值过去: //正版序列号库列表 var type = $("input[name='serialNumber']:checked&qu ...