
Hive的三种Join方式
Hive的三种Join方式
Hive中就是把Map,Reduce的Join拿过来,通过SQL来表示。
参考链接:https://cwiki.apache.org/confluence/display/Hive/LanguageManual+Joins
Common/Shuffle/Reduce Join
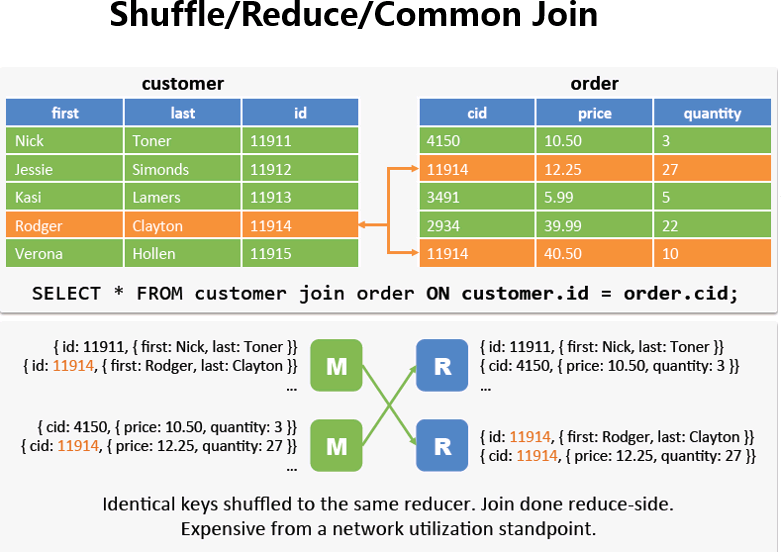
Reduce Join在Hive中也叫Common Join或Shuffle Join
如果两边数据量都很大,它会进行把相同key的value合在一起,正好符合我们在sql中的join,然后再去组合,如图所示。
Map Join
- 1) 大小表连接:
-
如果一张表的数据很大,另外一张表很少(<1000行),那么我们可以将数据量少的那张表放到内存里面,在map端做join。
Hive支持Map Join,用法如下
select /*+ MAPJOIN(time_dim) */ count(1) from

store_sales join time_dim on (ss_sold_time_sk = t_time_sk)
- 2) 需要做不等值join操作(a.x < b.y 或者 a.x like b.y等)
-
这种操作如果直接使用join的话语法不支持不等于操作,hive语法解析会直接抛出错误
如果把不等于写到where里会造成笛卡尔积,数据异常增大,速度会很慢。甚至会任务无法跑成功~
根据mapjoin的计算原理,MapJoin会把小表全部读入内存中,在map阶段直接拿另外一个表的数据和内存中表数据做匹配。这种情况下即使笛卡尔积也不会对任务运行速度造成太大的效率影响。
而且hive的where条件本身就是在map阶段进行的操作,所以在where里写入不等值比对的话,也不会造成额外负担。
select /*+ MAPJOIN(a) */

a.start_level, b.*

from dim_level a

join (select * from test) b

where b.xx>=a.start_level and b.xx<end_level;
3) MAPJOIN 结合 UNIONALL
原始sql:
select a.*,coalesce(c.categoryid,’NA’) as app_category

from (select * from t_aa_pvid_ctr_hour_js_mes1

) a

left outer join

(select * fromt_qd_cmfu_book_info_mes

) c

on a.app_id=c.book_id;
速度很慢,老办法,先查下数据分布:
select *

from

(selectapp_id,count(1) cnt

fromt_aa_pvid_ctr_hour_js_mes1

group by app_id) t

order by cnt DESC

limit 50;
数据分布如下:
NA      617370129

2       118293314

1       40673814

d       20151236

b       1846306

s       1124246

5       675240

8       642231

6       611104

t       596973

4       579473

3       489516

7       475999

9       373395

107580  10508
我们可以看到除了NA是有问题的异常值,还有appid=1~9的数据也很多,而这些数据是可以关联到的,所以这里不能简单的随机函数了。而t_qd_cmfu_book_info_mes这张app库表,又有几百万数据,太大以致不能放入内存使用mapjoin。
解决方:首先将appid=NA和1到9的数据存入一组,并使用mapjoin与维表(维表也限定appid=1~9,这样内存就放得下了)关联,而除此之外的数据存入另一组,使用普通的join,最后使用union all 放到一起。
select a.*,coalesce(c.categoryid,’NA’) as app_category

from --if app_id isnot number value or <=9,then not join

(select * fromt_aa_pvid_ctr_hour_js_mes1

where cast(app_id asint)>9

) a

left outer join

(select * fromt_qd_cmfu_book_info_mes

where cast(book_id asint)>9) c

on a.app_id=c.book_id

union all

select /*+ MAPJOIN(c)*/

a.*,coalesce(c.categoryid,’NA’) as app_category

from –if app_id<=9,use map join

(select * fromt_aa_pvid_ctr_hour_js_mes1

where coalesce(cast(app_id as int),-999)<=9) a

left outer join

(select * fromt_qd_cmfu_book_info_mes

where cast(book_id asint)<=9) c

--if app_id is notnumber value,then not join

on a.app_id=c.book_id
- 设置:
-
当然也可以让hive自动识别,把join变成合适的Map Join如下所示
注:当设置为true的时候,hive会自动获取两张表的数据,判定哪个是小表,然后放在内存中
set hive.auto.convert.join=true;

select count(*) from store_sales join time_dim on (ss_sold_time_sk = t_time_sk)
SMB(Sort-Merge-Buket) Join
- 场景:
-
大表对小表应该使用MapJoin,但是如果是大表对大表,如果进行shuffle,那就要人命了啊,第一个慢不用说,第二个容易出异常,既然是两个表进行join,肯定有相同的字段吧。
-
tb_a - 5亿(按排序分成五份,每份1亿放在指定的数值范围内,类似于分区表)
a_id
100001 ~ 110000 - bucket-01-a -1亿
110001 ~ 120000
120001 ~ 130000
130001 ~ 140000
140001 ~ 150000 -
tb_b - 5亿(同上,同一个桶只能和对应的桶内数据做join)
b_id
100001 ~ 110000 - bucket-01-b -1亿
110001 ~ 120000
120001 ~ 130000
130001 ~ 140000
140001 ~ 150000 -
注:实际生产环境中,一天的数据可能有50G(举例子可以把数据弄大点,比如说10亿分成1000个bucket)。
- 原理:
-
在运行SMB Join的时候会重新创建两张表,当然这是在后台默认做的,不需要用户主动去创建,如下所示:
-

设置(默认是false):
set hive.auto.convert.sortmerge.join=true

set hive.optimize.bucketmapjoin=true;

set hive.optimize.bucketmapjoin.sortedmerge=true;
- 总结:
-
其实在写程序的时候,我们就可以知道哪些是大表哪些是小表,注意调优。
Hive的三种Join方式的更多相关文章
- SQL Server中的三种Join方式
1.测试数据准备 参考:Sql Server中的表访问方式Table Scan, Index Scan, Index Seek 这篇博客中的实验数据准备.这两篇博客使用了相同的实验数据. 2.SQ ...
- Hive metastore三种配置方式
http://blog.csdn.net/reesun/article/details/8556078 Hive的meta数据支持以下三种存储方式,其中两种属于本地存储,一种为远端存储.远端存储比较适 ...
- Hive的三种安装方式(内嵌模式,本地模式远程模式)
一.安装模式介绍: Hive官网上介绍了Hive的3种安装方式,分别对应不同的应用场景. 1.内嵌模式(元数据保村在内嵌的derby种,允许一个会话链接,尝试多个会话链接时会报错) ...
- 数据库常见的三种join方式
数据库常见的join方式有三种:inner join, left outter join, right outter join(还有一种full join,因不常用,本文不讨论).这三种连接方式都是将 ...
- Hive之 hive的三种使用方式(CLI、HWI、Thrift)
Hive有三种使用方式——CLI命令行,HWI(hie web interface)浏览器 以及 Thrift客户端连接方式. 1.hive 命令行模式 直接输入/hive/bin/hive的执行程 ...
- Oracle中的三种Join 方式
基本概念 Nested loop join: Outer table中的每一行与inner table中的相应记录join,类似一个嵌套的循环. Sort merge join: 将两个表排序,然后再 ...
- corss、inner、outer三种join方式
cross join(没有on)inner join(一般用于交集)outer join(你懂得)后面两个 on 1=1 效果同cross join
- MapReduce三种join实例分析
本文引自吴超博客 实现原理 1.在Reudce端进行连接. 在Reudce端进行连接是MapReduce框架进行表之间join操作最为常见的模式,其具体的实现原理如下: Map端的主要工作:为来自不同 ...
- 061 hive中的三种join与数据倾斜
一:hive中的三种join 1.map join 应用场景:小表join大表 一:设置mapjoin的方式: )如果有一张表是小表,小表将自动执行map join. 默认是true. <pro ...
随机推荐
- 引入 netty网关,向flume提交数据
netty 处理http请求 package com.test; import io.netty.bootstrap.ServerBootstrap;import io.netty.channel. ...
- HTTP Headers Client Identification
用户信息通过HTTP头部承载:不能实现用户唯一性标识. w HTTP The Definitive Guide Table 11-1 shows the seven HTTP request head ...
- Zipline Data Bundles
Data Bundles A data bundle is a collection of pricing data, adjustment data, and an asset database. ...
- SpringCloud 进阶之Ribbon和Feign(负载均衡)
1. Ribbon 负载均衡 Spring Cloud Ribbon是基于Netflix Ribbon实现的一套客户端,负载均衡的工具; 1.1 Ribbon 配置初步 1.1.1 修改 micros ...
- 剑指Offer——树的子结构
题目描述: 输入两棵二叉树A,B,判断B是不是A的子结构.(ps:我们约定空树不是任意一个树的子结构) 分析: 先匹配到A的某个结点和B的根相同,然后往下继续匹配.不匹配则递归匹配左右子树. 代码: ...
- paintschainer项目
github:https://github.com/pfnet/PaintsChainer tensorflow实现:https://github.com/mizti/tensor_paint 在线测 ...
- redis之持久化操作
简介 Redis是一种高级key-value数据库.它跟memcached类似,不过数据可以持久化,而且支持的数据类型很丰富.有字符串,链表,集 合和有序集合.支持在服务器端计算集合的并,交和补集(d ...
- sql server dba概念系列引用
原文转自:https://www.cnblogs.com/gaochundong/p/everyone_is_a_dba_sqlserver_architecture.html <人人都是 DB ...
- ssmWeb开发框架_2014-01
一直在准备做一套系统, 具体用来干什么都没确定. 只是从纯技术人员的想法, 先搭建一套开发的框架. 做的时候才发现, 系统用途不同, 框架也是不同的. 暂时就先当作企业内部管理的系统来做吧. 后台基础 ...
- TQ2440系统介绍入门 、linux系统目录结构
TQ2440开发板系统安装步骤: 1.先用JTAG线安装BIOS到开发板.下载BIOS,NOR/NAND开关选在NOR位置. 2.linux安装步骤: (1).格式化分区 (2).安装BIOS---& ...