
DRF-->2序列化组件的使用和接口设计--get,post,put,delete&优化组件
!!!!!
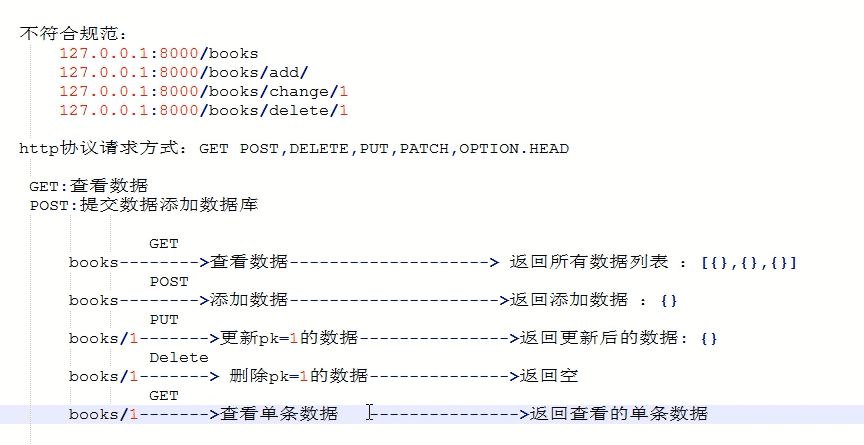
!!!!!
记住这个图
!!!!!
上篇博客说道DRF序列化组件的get,只是简单的举一个实例,然而在现实生活中我们前后端进行交互的时候更多的用到了Json数据格式,这也就是说前后端交互的时候用到的更多序列化,但同时也会有大量的重复性的代码,举个简单的例子,就上片博客---get请求的时候,只是一个简单的get请求,还有put,updata,post,delete请求的时候呢,代码没有任何的优化,在这里我们再来说一下序列化和代码优化的结合,以供后来人参考,不多说直接上代码
1.这里我们直接用我们上片博客的代码示例,表的结构以及数据的迁移可以参考上片博客
2.我们直接来看urls
urlpatterns = [

    re_path(r'books/$',views.BookView.as_view({

       #这里的get就是请求数据,可以理解是查看

        'get',:'list',

       #这里的post就是请求数据,可以理解提交数据

         'post':'create'

})'),

    re_path(r'books/(?P<pk>\d+)/$',views.BookView.as_view({

        #这里的get是请求数据,可以理解是查看单条数据

        'get':'retrieve',

        #这里的putr是请求数据,可以理解是修改

        'put':'update',

        #这里的delete就是请求数据,可以理解是删除

        'delete':destory'

}))

]
2.
views.py

from rest_framwork.viewsets import ModelViewSetfrom rest_framework import serializers

from app1.models import Book,Publish,Author

#注意这里必须继承ModelSerializer,这里只有它的源码里给我们封装了我们需要的东西

class BookSerializer(serializers.ModelSerializer):

    class Meta:

        model = Book

        fields = (

            'title',

            'price',

            'publish',

            'author_list',

            'publish_name',

            'publish_city'

        )

        extra_kwargs = {

            'publish':{'write_only': True},

            'authors':{'write_only': True}

        }
  #这里是外键字段,就是__str__显示字段,source='publish.name'就是为了我们能够更清楚地知道我们显示的字段是什么,read_only我们只读不写

    publish_name = serializers.CharField(max_length=32,read_only=True,source='publish.name')

    publish_city = serializers.CharField(max_length=32,read_only=True,source='publish.city')

   #这里是固定写法;serializers.SerializerMethodField()

    author_list = serializers.SerializerMethodField()

#这里在说一下 author_list

    def get_author_list(self, book_obj):

        authors = list()

        for author in book_obj.authors.all():

            authors.append(author.name)

            print(authors)

        return authors

class Book(ModelViewSet):

    queryset = Book.objects.all()

    #注意,这里的都是固定的写法,除了BookSerializer,它是需要我们进行序列化类的名字一致,否则找不到报错

    serializer_class = BookSerializer
3.是不是感觉很乱?ok,显示开发中我们不可能这样,我们新建文件夹,把我们代码进行一个解耦
app1_serializers.py

from rest_framework import serializers

from app1.models import Book,Publish,Author

class BookSerializer(serializers.ModelSerializer):

    class Meta:

        model = Book

        fields = (

            'title',

            'price',

            'publish',

            'author_list',

            'publish_name',

            'publish_city'

        )

        extra_kwargs = {

            'publish':{'write_only': True},

            'authors':{'write_only': True}

        }

    publish_name = serializers.CharField(max_length=32,read_only=True,source='publish.name')

    publish_city = serializers.CharField(max_length=32,read_only=True,source='publish.city')

    author_list = serializers.SerializerMethodField()

    def get_author_list(self, book_obj):

        authors = list()

        for author in book_obj.authors.all():

            authors.append(author.name)

            print(authors)

        return authors

#现在我们的代码就完全优化完了,现在urls两条,而我们的类只有一个,剩下的逻辑基本都在 app1_serializers.py脚本里,ok
DRF-->2序列化组件的使用和接口设计--get,post,put,delete&优化组件的更多相关文章
- DRF-->1 序列化组件的使用和接口设计---get
定义序列化器(本质就是一个类),一般包括模型类的字段,有自己的字段类型规则.实现了序列化器后,就可以创建序列化对象以及查询集进行序列化操作,通过序列化对象.data来获取数据(不用自己构造字典,再返回 ...
- DRF(2) - 解析器,序列化组件使用(GET/POST接口设计)
一.DRF - 解析器 1.解析器的引出 我们知道,浏览器可以向django服务器发送json格式的数据,此时,django不会帮我们进行解析,只是将发送的原数据保存在request.body中,只有 ...
- Restful 2 --DRF解析器,序列化组件使用(GET/POST接口设计)
一.DRF - 解析器 1.解析器的引出 我们知道,浏览器可以向django服务器发送json格式的数据,此时,django不会帮我们进行解析,只是将发送的原数据保存在request.body中,只有 ...
- DRF(3) - 序列化组件(GET/PUT/DELETE接口设计)、视图优化组件
一.序列化组件 基于上篇随笔的表结构,通过序列化组件的ModelSerializer设计如下三个接口: GET 127.0.0.1:8000/books/{id} # 获取一条数据,返回值:{} PU ...
- DRF - 序列化组件(GET/PUT/DELETE接口设计)、视图优化组件
一.序列化组件 基于上篇随笔的表结构 , 通过序列化组件的ModelSerializer设计如下三个接口 : GET 127.0.0.1:8000/books/{id} # 获取一条数据,返回值:{} ...
- 解析器组件和序列化组件(GET / POST 接口设计)
前言 我们知道,Django无法处理 application/json 协议请求的数据,即,如果用户通application/json协议发送请求数据到达Django服务器,我们通过request.P ...
- drf框架 - 序列化组件 | Serializer
序列化组件 知识点:Serializer(偏底层).ModelSerializer(重点).ListModelSerializer(辅助群改) 序列化与反序列化 序列化: 将对象序列化成字符串用户传输 ...
- Restful 3 -- 序列化组件(GET/PUT/DELETE接口设计)、视图优化组件
一.序列化组件 基于上篇随笔的表结构,通过序列化组件的ModelSerializer设计如下三个接口: GET 127.0.0.1:8000/books/{id} # 获取一条数据,返回值:{} PU ...
- 序列化组件(get/put/delete接口设计),视图优化组件
一 . 知识点回顾 1 . 混入类 , 多继承 class Animal(object): def eat(self): print("Eat") def walk(self): ...
随机推荐
- Umbraco中如何找到home node
在一个Umbraco项目中,我们经常会出现需要找到这个项目的home node的情况, 那么如何来找到项目的home node呢 方法如下: 1. 在View中 @inherits Umbraco.W ...
- libsvm使用简介
libsvm是support vector machine的一种开源实现,采用了smo算法.源代码编写有独到之处,值得一睹. 常用结构 svm_node结构 定义了构成输入特征向量的元素,index为 ...
- sql 脚本创建索引
之前从没有用SqlServer数据库处理过大数据量的表,都是用Oracle,然后一般为数据量较大的表添加索引或主键都是用plsql工具,今天正好需要为一张保存于SqlServer数据库的千万级数据表增 ...
- DotNet经典面试题(转载)
.Net基础常见 什么叫应用程序域?什么是受管制的代码?什么是强类型系统?什么是装箱和拆箱?什么是重载?CTS.CLS.CLR分别作何解释? 答: 1应用程序域可以理解为一种轻量级进程.起到安全的作用 ...
- [C++11]shared_ptr循环引用导致内存泄露
1 /* 2 * shared_ptr循环引用导致内存泄露 3 */ 4 5 struct A 6 { 7 shared_ptr<A> ptr; // 改为weak_ptr<A> ...
- Go语言学习教程:xorm表基本操作及高级操作
在上节内容中,我们介绍了xorm框架表结构的映射规则和表结构的操作.本节课,继续来深入学习表结构基本操作和高级查询的相关功能. 表结构基本操作 对表结构的操作最常见的操作是查询和统计相关的方法,我们首 ...
- [SinGuLaRiTy] (树形)数据结构题目复习
[SinGuLaRiTy-1023] Copyright (c) SinGuLaRiTy 2017. All Rights Reserved. 普通平衡树 题目描述 你需要写一种数据结构(可参考题目标 ...
- ExtJS 4.2.1学习笔记(二)——主题theme
1 UI组件基础 学习ExtJs就是学习组件的使用.ExtJs4对框架进行了重构,其中最重要的就是形成了一个结构及层次分明的组件体系,由这些组件形成了Ext的控件. E ...
- ArcGIS-各类问题
arcgis 10.4破解方法*注意!Desktop,Engine,Server必须为同一版本 1.先安装License10.4 2.再安装Desktop10.4 3.再安装Engine10.4 4. ...
- Eclipse导入GitHub项目两处报错处理
1.项目出现Could not calculate build plan:pligin 错误解决办法: 删除本地.m2仓库中 org.apache.maven.plugins:maven-resour ...