
Kafka Topic ISR不全,个别Spark task处理时间长
现象
Spark streaming读kafka数据做业务处理时,同一个stage的task,有个别task的运行时间比多数task时间都长,造成业务延迟增大。
查看业务对应的topic发现当topic isr不足时,会出现个别task运行时间过长的现象.
原因
和大部分分布式系统一样,Kafka处理失败需要明确定义一个Broker是否“活着”。对于Kafka而言,Kafka存活包含两个条件,一是它必须维护与ZooKeeper的session(这个通过ZooKeeper的Heartbeat机制来实现)。二是Follower必须能够及时将Leader的消息复制过来,不能“落后太多”。
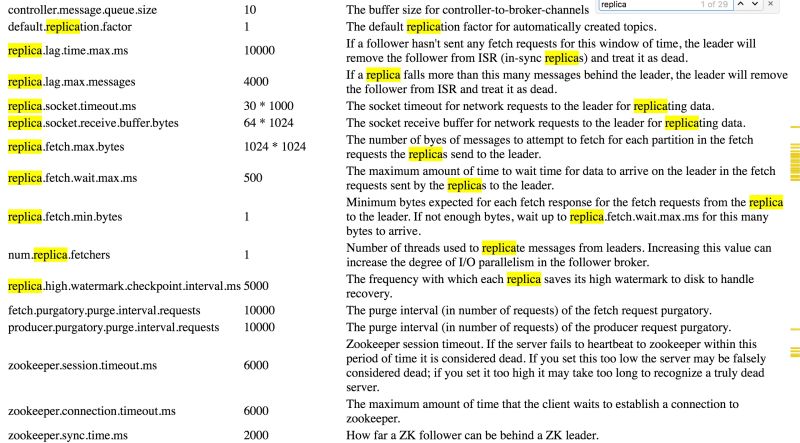
Leader会跟踪与其保持同步的Replica列表,该列表称为ISR(即in-sync Replica)。如果一个Follower宕机,或者落后太多,Leader将把它从ISR中移除。这里所描述的“落后太多”指Follower复制的消息落后于Leader后的条数超过预定值(该值通过replica.lag.max.messages配置,其默认值是4000)或者Follower超过一定时间(该值通过replica.lag.time.max.ms来配置,其默认值是10000)未向Leader发送fetch请求。
解决方法
将下面几个参数适当增大:
replicas响应leader的最长等待时间,若是超过这个时间,就将replicas排除在管理之外
replica.lag.time.max.ms = 10000
如果relicas落后太多,将会认为此partition relicas已经失效。而一般情况下,因为网络延迟等原因,总会导致replicas中消息同步滞后。如果消息严重滞后,leader将认为此relicas网络延迟较大或者消息吞吐能力有限。在broker数量较少,或者网络不足的环境中,建议提高此值.
replica.lag.max.messages = 4000
leader中进行复制的线程数,增大这个数值会增加relipca的IO
num.replica.fetchers = 1
replicas每次获取数据的最大字节数
replica.fetch.max.bytes = 1024 * 1024
Kafka Topic ISR不全,个别Spark task处理时间长的更多相关文章
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(二十九):推送avro格式数据到topic,并使用spark structured streaming接收topic解析avro数据
推送avro格式数据到topic 源代码:https://github.com/Neuw84/structured-streaming-avro-demo/blob/master/src/main/j ...
- 用canal同步binlog到kafka,spark streaming消费kafka topic乱码问题
canal 1.1.1版本之后, 默认支持将canal server接收到的binlog数据直接投递到MQ, 目前默认支持的MQ系统有kafka和RocketMQ. 在投递的时候我们使用的是非压平的消 ...
- kafka broker Leader -1引起spark Streaming不能消费的故障解决方法
一.问题描述:Kafka生产集群中有一台机器cdh-003由于物理故障原因挂掉了,并且系统起不来了,使得线上的spark Streaming实时任务不能正常消费,重启实时任务都不行.查看kafka t ...
- kafka topic查看删除
1,查看kafka topic列表,使用--list参数 >bin/kafka-topics.sh --zookeeper 127.0.0.1:2181 --list __consumer_of ...
- 关于Flink slot 和kafka topic 分区关系的说明
今天又有小伙伴在群里问 slot 和 kafka topic 分区(以下topic,默认为 kafka 的 topic )的关系,大概回答了一下,这里整理一份 首先必须明确的是,Flink Task ...
- Kafka Topic 体系结构 - 复制 故障转移 并行处理
本文介绍了 Kafka Topic 的体系结构,并讨论了如何使用分区进行故障转移和并行处理. 1. Kafka Topic, Log, Partition Kafka Topic(主题) 是一个有名字 ...
- jmeter中执行kafka topic指令
前置条件 kafka版本:2.2.1 jmeter版本:5.3 插件:ApacheJMeter_ssh-1.2.0.jar 1.拷贝 ApacheJMeter_ssh-1.2.0.jar 到/lib/ ...
- Kafka Topic Partition Replica Assignment实现原理及资源隔离方案
本文共分为三个部分: Kafka Topic创建方式 Kafka Topic Partitions Assignment实现原理 Kafka资源隔离方案 1. Kafka Topic创建方式 ...
- Exception in thread "main" org.I0Itec.zkclient.exception.ZkAuthFailedException: Authentication failure is thrown while creating kafka topic
Exception in thread "main" org.I0Itec.zkclient.exception.ZkAuthFailedException: Authentica ...
随机推荐
- Node与express开发
1.初识Express Express 网站上是这样介绍 Express 的: "精简的.灵活的 Node.js Web 程序框架,为构建单页.多页及混合的 Web 程序提供了一系列健壮的功 ...
- VS2015快捷键
Shift+Alt+Enter: 切换全屏编辑 Ctrl+B,T / Ctrl+K,K: 切换书签开关Ctrl+B,N / Ctrl+K,N: 移动到下一书签Ctrl+B,P: 移动到上一书签Ctrl ...
- Mallet 使用说明
Mallet:自然语言处理工具包 发表于128 天前 ⁄ 技术, 科研 ⁄ 评论数 6 ⁄ 被围观 1006 Views+ MALLET是基于java的自然语言处理工具箱,包括分档得分类.句类.主题模 ...
- 端口限制情况下php+xdebug环境配置
PHP程序在开发的时候调试是比较方便的,大体情况下,输出,打log是可以解决几乎所有问题. 但是还不够,有些问题,用打log的形式定位问题是相当痛苦的事情,有些时候测试环境没配好的话,你可能需要做许多 ...
- php ob_start()、ob_end_flush和ob_end_clean()多级缓冲
ob_start() 和 ob_end_flush() 是一对很好的搭档,可以实现对输出的控制.当成一对出现理解起来就没什么问题,但是当他们两个各自出现次数增加时,就比较难理解了. <?php ...
- 安装 mbed os 开发环境yotta
feature: 采用Python编写, Pip 包管理 CMake, the build system that yotta usesa compiler, to actually compile ...
- Log4j 用法
一.Log4j基本使用方法 Log4j由三个重要的组件构成:日志信息的优先级,日志信息的输出目的地,日志信息的输出格式.日志信息的优先级从高到低有ERROR.WARN. INFO.DEBUG,分别用来 ...
- C/C++程序员常去网站
www.codeproject.comwww.codegru.comwww.chinaunix.netwww.csdn.netwww.vckbase.com http://www.google.com ...
- java基础之 超类Object
一.概述: Object类是所有Java类的祖先.每个类都使用 Object 作为超类.所有对象(包括数组)都实现这个类的方法.在不明确给出超类的情况下,Java会自动把Object作为要 ...
- Command Pattern
当(客户)对象访问(服务)请求服务时,最直接的方法就是方法调用.