
Distribution of Data Through OCAF Tree
Distribution of Data Through OCAF Tree
OCAF数据的分配
一、作者注 Annotation
本文档主要用于说明OCAF(Open CASCADE Application Framework)中数据模型的选择问题。另外,以一个例子来说明OCAF的标准属性的使用和创建OCAF新的属性。
作者假设读者已经熟悉OCAF的一些基础知识。
二、简介 Introduction
OCAF(Open CASCADE Application Framework)是为快速程序开发(Rapid Application Development)而提供的一些类。OCAF实现如下功能:撤销、重做、复制、剪切、粘贴、保存文档、打开文档等等。
OCAF基于标签-属性(Label-Attribute)模型。标签组成树。在OCAF文档中,属性用于保存用户的数据,且属性绑定在标签上。
本文档描述了数据保存在OCAF文档中应考虑的注意事项:
1. 是使用标准属性还是创建自定义的新的属性?
2. 如何优化数据的存储来提高时间和空间上效率,和程序的运行速度?
三、概述Description
当开始设计基于OCAF的程序时,对于数据的存储通常要面临这样的选择:是使用标准属性还是根据需要自己创建新的属性?在给出这个问题的答案之前,先简要回顾一下OCAF的标准属性:
所有基本数据类型都在OCAF中表示为标准属性:
u 整数Integer;
u 实数Double;
u 字符串String;
u 整数数组Array of integer values;
u 实数数组Array of double values;
u 字符串数组Array of string values;
u 拓朴形状Topological shapes;
除了拓朴形状属性外,其它属性都在Toolkit TKLCAF的Package TDataStd中:
u 整数属性:TDataStd_Integer;
u 实数属性:TDataStd_Real;
u 字符串属性:TDataStd_AsciiString、TDataStd_Expression;
u 整数数组:TDataStd_IntegerArray;
u 实数数组:TDataStd_RealArray;
u 字符串数组:TDataStd_ExtStringArray;
细心的读者可能发现没有Boolean类型,因为通常用Integer来代替了。
所以使用OCAF的标准属性可以用来定义任何模型。但是这样定义对内存的使用、程序运行速度、及使用的方便性上来说是否合适?还是要根据特定的模型具体分析。
OCAF只有一个限制:每种属性一个标签只能包含一个。即只能给一个标签定义一个整数属性,一个实数属性等。所以有必要考虑程序数据树的设计。例如:一个标签有几个实数值,是把这几个实数值分别存储到子标签中还是使用一个实数数组来存储,都是需要事先考虑周全。
考虑同一个模型在OCAF中不同的存储方法,并分析每种方法的优缺点。
四、不同方法的比较与分析Comparison and Analysis of Approaches
这里描述了定义模型的两种方式:一种是基于OCAF标准属性;另一种是创建新的属性。
A load is distributed through the shape。量度由坐标(x, y, z)来定义。Load通过由每点的局部坐标系投影到X-、Y-和Z-轴上来表示。一个由局部坐标系转换到世界坐标系的矩阵也可能需要,但这是可选的。
所以,每个点上有15个数值需要被存储。若这样的点有100000个,则在OCAF文档中需要存储1500000个数值。
第一种方式是使用OCAF的标准属性。使用标准属性也有几种不同的方式:
1. 使用实数数组属性来存储这1500000个数,并将这个实数数组绑定到一个标签;如下图1所示。
2. 将每组15个值用一个实数数组属性存储,并将每个实数数组绑定到每个标签上;如下图2所示。
3. 使用实数数组属性来存储每个点的(X、Y、Z)3个坐标值,并将其绑定到标签;局部坐标系到世界坐标系的投影轴的3个值也使用实数数组属性来存储,并将其绑定到子标签上;同样地,变换坐标系的9个值也用实数数组属性存储,并也将其绑定到子标签上;如下图3所示。
4. 当然,其它方法也是可行的。
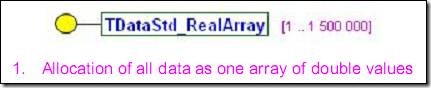
图1 使用一个数组属性来存储所有数据
第一种方法是把所有数据都用一个实数数组属性来存储。这种方法的优点是节省了初始内存,并且易于实现。但是数据的访问很不方便,还需要为取得相应数据来定个专门的类来处理。如果程序需要对这些值进行编辑,这就意味着整个数组在每次编辑时都需要备份,这会导致内存的使用快速增加。所以,这种方式可能只能用于数据不需要编辑的程序。
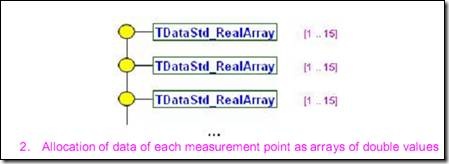
图2 为每个数据点使用一个数组属性及一个标签
考虑每个数据点作为一个标签的第二种方式。这种情况需要创建100000个标签,每个标签上绑定了一个包含15个实数的实数数组属性。如图2所示。
现在数据的编辑要安全些,且内存的使用也在考虑之中。每个数据点的编辑(任意值:point coordinate, load, and so on)的备份也只是一个小的实数数组。但是这种结构需要更多的内存空间,因为使用很多的标签和属性。
另外,数据的访问还是不方便,也需要一个类来处理数据的访问。
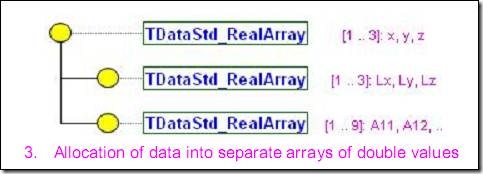
图3 存储数据到不同的数组属性中
第三种方式的数据存储如图3所示。在这种情况下引入了子标签,数据的访问变得容易了,不需要为此专门设计一个类来访问所需要的数据了。
这种方式一方面为属性分配更多的内存;另一方面,在数据编辑需要备份时节省了内存。所以,若程序中所有数据都可以修改,则这种方式会更好。
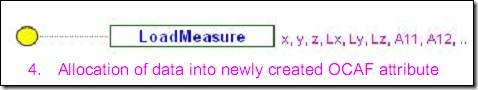
图4 使用自定义属性
在下结论之前,考虑使用自定义属性来表示这个模型的方式。
例如,可以将每组15个值作为一个自定义属性绑定到标签上。与使用标准属性的第三种方式相比,自定义属性的方法使用更少的内存,因为只使用了一个属性而不是三个属性。
使用标准属性的第二种方式还有些不足:当编辑数据时,每个点的所有数据都被备份,不管有些数据有没有被修改。
当有些不可编辑的数据,最好将之与可编辑的数据分开存储。数据编辑备份时将不会对不可编辑的数据进行备份,这样在编辑时内存就会有所减少了。
五、结论Conclusion
当确定选择使用哪种数据模型时,需要考虑程序响应时间、内存分配与内存在事务处理中的使用。大部分模型只使用OCAF的标准属性已经足够。其它需要特别处理的模型需要定义OCAF新属性。
Distribution of Data Through OCAF Tree的更多相关文章
- Data Structure Binary Tree: Lowest Common Ancestor in a Binary Tree
http://www.geeksforgeeks.org/lowest-common-ancestor-binary-tree-set-1/ #include <iostream> #in ...
- Data Structure Binary Tree: Print ancestors of a given binary tree node without recursion
http://www.geeksforgeeks.org/print-ancestors-of-a-given-binary-tree-node-without-recursion/ #include ...
- Data Structure Binary Tree: Convert a given Binary Tree to Doubly Linked List
http://www.geeksforgeeks.org/in-place-convert-a-given-binary-tree-to-doubly-linked-list/ #include &l ...
- Data Structure Binary Tree: Iterative Postorder Traversal
http://www.geeksforgeeks.org/iterative-postorder-traversal-using-stack/ #include <iostream> #i ...
- Data Structure Binary Tree: Largest Independent Set Problem
http://www.geeksforgeeks.org/largest-independent-set-problem/ #include <iostream> #include < ...
- Data Structure Binary Tree: Morris traversal for Preorder
http://www.geeksforgeeks.org/morris-traversal-for-preorder/ #include <iostream> #include <v ...
- Data Structure Binary Tree: Construct Full Binary Tree from given preorder and postorder traversals
http://www.geeksforgeeks.org/full-and-complete-binary-tree-from-given-preorder-and-postorder-travers ...
- Data Structure Binary Tree: Boundary Traversal of binary tree
http://www.geeksforgeeks.org/boundary-traversal-of-binary-tree/ #include <iostream> #include & ...
- Data Structure Binary Tree: Convert a given tree to its Sum Tree
http://www.geeksforgeeks.org/convert-a-given-tree-to-sum-tree/ #include <iostream> #include &l ...
随机推荐
- matlab linux 安装
1. 获取matlab的iso文件,并挂载到目录下2. sudo sh $(matlab_path)/matlab安装(破解,相关见说明)3. 加入系统路径,将$(matlab_install_pat ...
- 51NOD算法马拉松11 B君的竞技场
传送门 这题我在比赛的时候竟然没有想出来,真是-- 这道题我们可以想一想怎么搞定获胜的概率p. 我们发现再怎么这个p都是搞不了的.所以我们可以积一下分,然后就可以不用去管p了.我们要做的就是求出一个关 ...
- 特征处理(Feature Processing)
[本文链接:http://www.cnblogs.com/breezedeus/p/4109456.html,转载请注明出处] 我的博客主营地迁至github,欢迎朋友们有空去看看:http://br ...
- Minimum configuration for openldap to proxy multiple AD into a single search base
[root@localhost ~]# cd /etc/openldap[root@localhost openldap]# cat slapd.confloglevel 0x900include / ...
- C#学习之Stream
上节课老师主要讲了stream及其一些运用和实例,下面我们就来讨论讨论Stream. 我们知道,C#中常用的stream有文件流(FileSteam),内存流(MemoryStream),压缩流(GZ ...
- 织梦cms、帝国cms、PHPcms优缺点解析
php才是建站的主流,cms这类程序又是用的最多的,占据主流的cms主要就是织梦,帝国,phpcms这三种的,这三个程序都是开源程序.国内用户众多. 一.从美观性来说(以官方默认模版为准 ph ...
- 打印文本中的所有单词,并且打印每个单词出现的行号,非实义单词不考虑(TCPL,练习6-3)
建立一棵二叉树,每个接单存放单词以及指向一个链表的指针,以及指向左右节点的指针.链表内存放行号以及指向下一个链表节点的指针. 每录入一个单词,先寻找二叉树,再寻找它的链表,分别将单词和行号插入二叉树和 ...
- SqlServer2012 数据库的同步之SQL JOB + 建立链接服务器
文章参考百度过的文章,现在忘了具体哪篇,感谢其分享,这里根据自己的操作和遇到的问题整理一下. 需求:在两个不同的SQL SERVER 2012的服务器之间进行数据访问和更新.我们需 ...
- 让.NET xml序列化支持Nullable
.NET的序列化,关于契约类的生成我们都是通过xsd.exe,对于值类型的可空判断是通过声明同名+Specified的bool属性来判断,比如: public class Person { publi ...
- 在VS2015 RC打开CTP中创建的工程
VS2015终于出了RC了!小伙伴们快来安装试用吧,地址在这里,还有新的Windows 10开发工具哦,要不然是开发不了Universal Windows App的,安装前记得卸载CTP版本. 新的R ...