
Hive复制分区表和数据
1. 非分区表:
复制表结构: create table new_table as select * from exists_table where 1=0;
复制表结构和数据: create table new_table as select * from exists_table;
2. 分区表:
-- 创建一个分区表
drop table if exists kimbo_test;
create table kimbo_test
(
order_id int,
system_flag string
)
PARTITIONED BY(dt string )
ROW FORMAT DELIMITED FIELDS TERMINATED BY '\001' LINES TERMINATED BY '\n'
STORED AS TEXTFILE
;

-- 插入数据
insert overwrite table kimbo_test partition(dt=')
values (,,'B') ;

insert overwrite table kimbo_test partition(dt=')
values (,,'W') ;

create table test_par like kimbo_test;

-- 用 as select 复制一个新表
create table test_par2 as ;
-- 用 like 复制一个新表
create table test_par3 like kimbo_test;

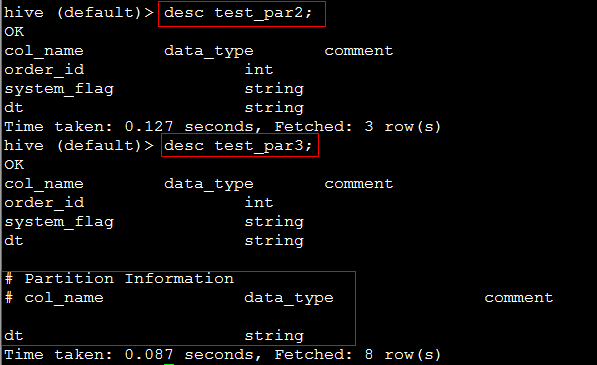
-- 注意差异: as select 复制的是一个非分区表, like 复制的是一个分区表。
表结构截图:
3. 将原表的数据复制到 新表(test_par3)
1. 创建新表: create table test_par3 like kimbo_test;
2. 将HDFS的数据文件复制一份到新表目录,hive cmd模式下: dfs -cp -f /user/hive/warehouse/kimbo_test/* /user/hive/warehouse/test_par3/
3. 修复分区元数据信息,hive cmd模式下: MSCK REPAIR TABLE test_par3;
结果查询:

参考博客:https://www.cnblogs.com/kimbo/p/7102571.html
Hive复制分区表和数据的更多相关文章
- Hive 复制分区表和数据
1. 非分区表: 复制表结构: create table new_table as select * from exists_table where 1=0; 复制表结构和数据: create tab ...
- 一起学Hive——总结复制Hive表结构和数据的方法
在使用Hive的过程中,复制表结构和数据是很常用的操作,本文介绍两种复制表结构和数据的方法. 1.复制非分区表表结构和数据 Hive集群中原本有一张bigdata17_old表,通过下面的SQL语句可 ...
- hive 修复元数据命令 & 如何快速复制一张hive的分区表
hive 元数据修复命令 msck repair table xxx; 也可以用于分区表的快速复制 例如你需要从线上往线下导一张分区表,但是网又没有连通,你需要如何操作呢? 1.复制建表语句 2.从线 ...
- hive(在大数据集合上的类SQL查询和表)学习
1.jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&characterEncoding=UTF-8&use ...
- hive加载json数据解决方案
hive官方并不支持json格式的数据加载,默认支持csv格式文件加载,如何在不依赖外部jar包的情况下实现json数据格式解析,本编博客着重介绍此问题解决方案 首先创建元数据表: create EX ...
- Hive数据导入——数据存储在Hadoop分布式文件系统中,往Hive表里面导入数据只是简单的将数据移动到表所在的目录中!
转自:http://blog.csdn.net/lifuxiangcaohui/article/details/40588929 Hive是基于Hadoop分布式文件系统的,它的数据存储在Hadoop ...
- hive建表与数据的导入导出
建表: create EXTERNAL table tabtext(IMSI string,MDN string,MEID string,NAI string,DestinationIP string ...
- 使用hive访问elasticsearch的数据
使用hive访问elasticsearch的数据 1.配置 将elasticsearch-hadoop-2.1.1.jar拷贝到hive/lib hive -hiveconf hive.aux.jar ...
- ORACLE+PYTHON实战:复制A表数据到B表
最近在学习python ,看到了pythod的oracle,不仅可以一次fetch多条,也可以一次insert多条,想写一个复制A表数据到B表的程序来看看实际效率能不能提高.写完发现,非常惊艳!效率提 ...
随机推荐
- Loadrunner回放脚本时报错Action.c(41): Error -27979: Requested form not found [MsgId: MERR-27979]
解决方法 打开录制选项配置对话框进行设置,在“Recording Options”的“Internet Protocol”选项里的“Recording”中选择“Recording Level”为“HT ...
- 【JMeter】【微信好文收藏】Jmeter接口测试实战-有趣的cookie
场景: 接口测试时常都需要登录,请求方式(post), 登录常用的方法有通过获取token, 获取session, 获取cookie, 等等. 这几种都有一个共同的特点, 有效期(expires). ...
- 原生js获取子元素、给元素增加div
//鼠标移入移出动画 解决页面闪屏问题 window.onload = function () { var el = document.createElement('div'); el.classNa ...
- centos who命令 查看当前登录系统用户信息
who 显示当前登录系统的用户,但w显示的更为详细 默认输出 [root@mysql ~]# who //用户名.登录终端.登录时间 root pts/ -- : (192.168.0.110) -a ...
- Pycharm常用配置
Pycharm常用配置 pycharm中的设置是可以导入和导出的,file>export settings 可以保存当前pycharm中的设置为jar文件,重装时可以直接import setti ...
- if __name__==__main__:的应用
1. if __name__==__main__:代码的作用 python的文件有两种使用的方法:(1)直接作为脚本执行:(2)import到其他的python脚本中被调用(模块重用)执行: 因此if ...
- 【PCA】周志华
一.书籍
- 阿里云ECS利用密钥对ssh登录服务器
https://blog.csdn.net/u012865381/article/details/78521087/ 1.在服务机上操作创建要远程登录的用户和密码 [root@izwz97s23bov ...
- extjs store快速创建的几种方式
viewModel中定义stores: { tickets: { model: 'Ticket', autoLoad: true, remoteFilter: true, filters: [{ pr ...
- python package
简要说一下,一个python模块就是一个python文件:一个包就是存放python模块的目录结构,并且包下边必须要有一个可以为空的__init__.py模块 //test.py from mypac ...