
还不懂 redis 持久化?看看这个
Redis 是一个内存数据库,为了保证数据不丢失,必须把数据保存到磁盘,这就叫做持久化。
Redis 有两种持久化方法: RDB 方式以及 AOF 方式
RDB 持久化
前言
RDB持久化把内存中的数据持久化到硬盘,生成RDB文件,也就是“快照”。通过RDB文件可以重新恢复内存中的数据。RDB文件是一个压缩过的文件,因此RDB持久化的体积比AOF小,因为存储的是数据,所以恢复很快,性能好,但是可能会丢失最后一次持久化的数据。
RDB持久化机制的两种方式
显示开启持久化
Save命令
SAVE命令会阻塞Redis服务器的主进程,直到RDB文件创建完毕。在服务器进程阻塞期间,服务器不能处理任何命令请求
BGSAVE命令
BGSAVE命令会fork一个子进程,由子进程负责创建RDB文件,父进程继续处理命令请求
- 子进程执行BGSAVE命令期间,SAVE、BGSAVE命令会被父进程拒绝。因为Redis不允许两个进程同时进行持久化
- BGSAVE和BGREWRITEAOF命令同样不能同时执行,性能考虑
自动持久化机制
通过配置文件redis.conf
# 多久持久化一次

# 900秒内有一个key改动 300秒内10个  60秒内10000个

save 900 1

save 300 10

save 60 10000
底层实现:
Redis 服务器的周期性操作函数 serverCron 默认每100ms执行一次,该函数用户对正在执行的服务器进行维护,它的其中一项工作就是检查save 选项所设置的持久化条件是否满足,满足的话执行 BGSAVE 命令
Redis 使用 saveparams 数组保存持久化条件
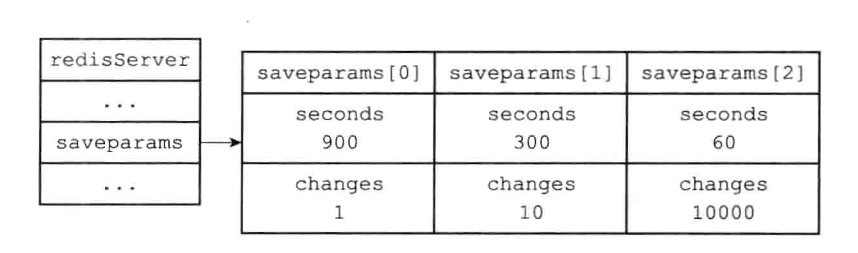
dirty 计数器 和 lastsave 记录上一次持久化到现在修改了几次和上一次执行SAVE或者BGSAVE的时间戳
RDB文件的结构
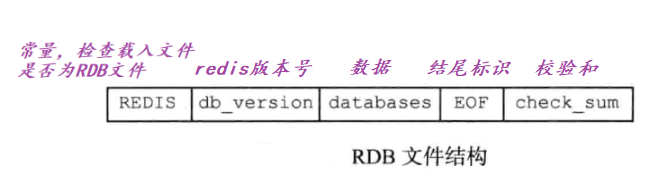
参考《REDIS设计与实现》P125
后续补充,先说一下目前总结,其实也就是databases的结构:
redis 有多个数据库,如果每个数据库都为空,那么databases也为空。如果不是的话,database的结构差不多是这样的:
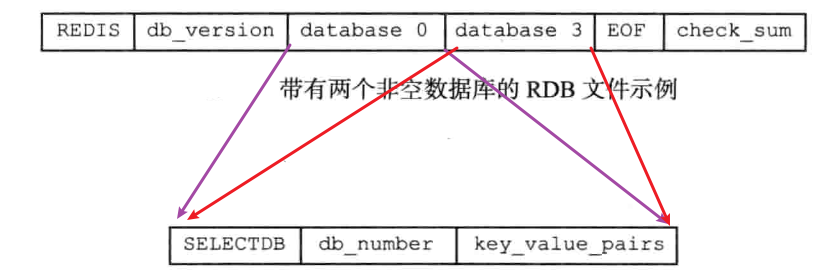
key_value_pairs 部分保存了该数据库中所有的键值对数据,如果键值对带有过期时间,过期时间也会和键值对保存在一起。会根据value的不同类型采用不同的结构存储
接下来看一个完整的 RDB 文件结构示例,包含0号数据库和3号数据库
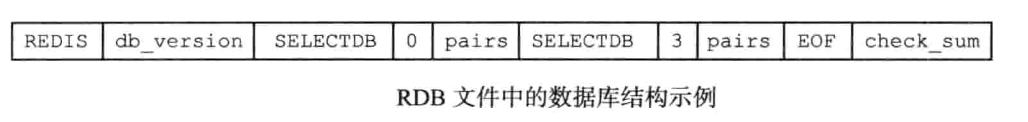
key_value_pairs 字段详解~(挖个坑)
分析RDB文件
使用od -c dump.rdb命令根据rdb文件的结构人工分析,或者使用工具 redis-dump-check 分析。分析 RDB 文件其实没有实际的意义,但可以帮助我们进一步理解 RDB 文件的结构。
AOF持久化
引言
AOF持久化与RDB持久化不同,RDB持久化把内存中的数据按照某种格式存储到硬盘中,而AOF持久化是把所有写命令记录到硬盘,恢复的时候需要重新执行所有写命令。
在这个AOF文件里面,除了用于指定数据库的 SELECT 命令是服务器自动添加的之外,其他都是我们之前通过客户端发送的命令。
AOF 持久化的实现机制
AOF 持久化的实现有三步:
- 命令追加:每执行完一个写命令后,会以协议格式将被执行的写命令追加到服务器内核的 aof_buf 缓冲区的末尾
- 命令写入:操作系统调用 write 函数,将aof_buf 缓冲区的数据排入队列,晚些时候一起写入磁盘
- 命令同步:操作系统调用 fsync 和 fdatasync 两个同步函数,强制让操作系统立即把队列中的数据写入磁盘
总的来说其实就是每执行完一次写命令(也叫做一个事件循环),redis 都会把这条命令格式化后写到缓冲区,再从缓冲区持久化到磁盘。但是你可能会有疑问,这不是两步吗,为什么 write 函数不能直接把缓冲区的数据同步到磁盘,这就涉及 Linux 内核关于文件 IO 的知识了,这里简单解释一下。
为了提高文件的写入效率,在现代操作系中,当用户调用 write函数,将一些数据写入到文件的时候,操作系统通常会将写入数据暂时保存在一个内存缓冲区(队列)里面, 等到队列的空间被填满、或者超过了指定的时限之后,才真正地将队列中的数据写入到磁盘里面。这种方式又叫做延迟写。
如何开启和配置 AOF 持久化
同样是配置 redis.conf 文件
# 是否开启aof持久化

appendonly no

# aof持久化文件名

appendfilename "appendonly.aof"

# aof持久化策略 默认是一秒持久化一次

# appendfsync always

appendfsync everysec

# appendfsync no
上述的持久化策略就是配置 命令同步 的时机。
- no:只有等队列满了数据才会持久化到磁盘。如果此时服务器宕机了,可能会丢失上次同步之后的所有命令数据。效率最高。
- always:每写入一条命令就要同步一次,安全性最高,最多丢失一条命令的数据。但是效率最低。
- everysec:每一秒钟执行同步一次,最多丢失一秒的数据。
如何载入AOF文件还原数据
也就是如何通过AOF文件还原数据库的过程
- 创建一个不带网络连接的伪客户端。因此redis命令只能在客户端的上下文执行
- 从AOF 文件中分析一条写命令
- 客户端执行命令,循环2 3 过程
AOF重写机制
引言
随着服务器运行时间的流逝,可能会频繁的对同一个 key 进行很多写操作,AOF 文件中的内容会越来越多,文件越来越大,如果不加以控制,会对服务器造成影响,还原数据的时间也加长。
比如现在有一个键值对为list类型,在服务器运行时间,你对这个key进行了十次写操作。AOF在持久化时就要保存十条命令,但是我们只保存一条命令也可以还原此key的状态。
重写机制就是这样实现的:Redis 服务器创建一个新的 AOF 文件替代现有的 AOF 文件,新旧两个文件保存的数据库状态相同,但是新的 AOF 文件不会包含浪费空间的冗余命令,只保存必须的命令,因此新的AOF 体积就要小得多。
触发方式
手动触发
使用
BGREWRITEAO命令,fork 子进程重写aof自动触发,配置redis.conf
# 重写aof文件的配置

auto-aof-rewrite-percentage 100

auto-aof-rewrite-min-size 64mb
实现机制
通过读取服务器当前数据库状态来实现的,不依赖旧的 AOF 文件。
如果服务器想要用最小的命令来记录 key 的状态,最简单高效的方法就是读取 key 的值,记录一条插入(add、push ....)的命令。一条就完事,不用在意以前的写命令是什么。
因为AOF重写会进行大量的写入操作,因此 Redis 使用单个子进程来处理命令请求实现AOF重写,缩小AOF文件体积。
为什么是进程不是线程呢?
- 子进程重写期间,服务器父进程可以继续处理命令请求
- 子进程有服务器进程的数据副本,不会导致线程安全问题
总结
Redis 持久化有RDB持久化和AOF持久化两种,RDB效率高但是可能会丢失大量数据,安全性较低,AOF效率低但是安全性高。
Redis 默认使用的持久化方式是RDB持久化
AOF 重写的目的是为了减小aof文件的体积
参考
还不懂 redis 持久化?看看这个的更多相关文章
- 看完这篇还不懂Redis的RDB持久化,你们来打我!
一.为什么需要持久化 redis里有10gb数据,突然停电或者意外宕机了,再启动的时候10gb都没了?!所以需要持久化,宕机后再通过持久化文件将数据恢复. 二.优缺点 1.rdb文件 rdb文件都是二 ...
- 还不懂Redis?看完这个故事就明白了!
我是Redis 你好,我是Redis,一个叫Antirez的男人把我带到了这个世界上. 说起我的诞生,跟关系数据库MySQL还挺有渊源的. 在我还没来到这个世界上的时候,MySQL过的很辛苦,互联网发 ...
- Redis持久化磁盘IO方式及其带来的问题 有Redis线上运维经验的人会发现Redis在物理内存使用比较多,但还没有超过实际物理内存总容量时就会发生不稳定甚至崩溃的问题,有人认为是基于快照方式持
转自:http://blog.csdn.net/kaosini/article/details/9176961 一.对Redis持久化的探讨与理解 redis是一个支持持久化的内存数据库,也就是 ...
- Redis学习——Redis持久化之AOF备份方式保存数据
新技术的出现一定是在老技术的基础之上,并且完善了老技术的某一些不足的地方,新技术和老技术就如同JAVA中的继承关系.子类(新技术)比父类(老技术)更加的强大! 在前面介绍了Redis学习--Redis ...
- Redis学习——Redis持久化之RDB备份方式保存数据
从这一个介绍里面知道,redis比memcache作为缓存数据库强大的地方,一个是支持的数据类型比较多,另一个就是redis持久化功能. 下面就介绍Redis的持久化之RDB! 一:什么是redis的 ...
- 跟我一起学Redis之Redis持久化必知必会
前言 Redis是出了名的速度快,那是因为在内存中进行数据存储和操作:如果仅仅是在内存中进行数据存储,那就会导致以下问题: 数据随进程退出而消失:当服务器断电或Redis Server进程退出时,内存 ...
- Redis 持久化方案
目录 持久化简介 什么是持久化? Redis 持久化方案 RDB RDB 简介 save 指令 操作与配置 工作原理 bgsave 指令 操作与配置 工作原理 bgsave 配置执行 相关配置 工作原 ...
- redis持久化RDB和AOF
Redis 持久化: 提供了多种不同级别的持久化方式:一种是RDB,另一种是AOF. RDB 持久化可以在指定的时间间隔内生成数据集的时间点快照(point-in-time snapshot). AO ...
- redis——持久化篇
众所周知,redis是内存数据库,它把数据存储在内存中,这样在加快读取速度的同时也对数据安全性产生了新的问题,即当redis所在服务器发生宕机后,redis数据库里的所有数据将会全部丢失. 为了解决这 ...
随机推荐
- lucent,solr,ES比较
|0什么是全文搜索 什么是全文搜索引擎? 百度百科中的定义:全文搜索引擎是目前广泛应用的主流搜索引擎.它的工作原理是计算机索引程序通过扫描文章中的每一个词,对每一个词建立一个索引,指明该词在文章中出现 ...
- mysql 统计新增每天数据
#创建基表 CREATE TABLE `table_sum` ( `id` int(11) NOT NULL AUTO_INCREMENT, `table_name` varchar(50) ...
- 有必要了解的大数据知识(一) Hadoop
前言 之前工作中,有接触到大数据的需求,虽然当时我们体系有专门的大数据部门,但是由于当时我们中台重构,整个体系的开发量巨大,共用一个大数据部门,人手已经忙不过来,没法办,为了赶时间,我自己负责的系统的 ...
- 周期串(JAVA语言)
package 第三章习题; /* * 如果一个字符可以由某个长度为k的字符串重复多次得到,则称该串以k为周期. * 例如:abcabcabcabc 以3为周期(注意:它也以6和12为周期) * ...
- 学《跟我一起写Makefile》笔记发博词
目录 笔记发博词 参考 笔记发博词 本系列笔记主要记录学了<跟我一起写Makefile>后的一些笔记 由于<跟我一起写Makefile>已经写得很详细了,所以我只是提取其中重要 ...
- Jaeger Client Go 链路追踪|入门详解
目录 从何说起 Jaeger 部署 Jaeger 从示例了解 Jaeger Client Go 了解 trace.span tracer 配置 Sampler 配置 Reporter 配置 分布式系统 ...
- Swagger3注解使用
这里只简单的说一下swagger的传值,返回值时注解的使用演示.相关注解及说明见其他文章 接收参数方式1 我们常规接收参数,可以使用一个类,类里面把属性作为接收的参数,使用注解对属性进行说明.但是这种 ...
- [Fundamental of Power Electronics]-PART I-1.引言-1.1 功率处理概论
1.1 功率处理概论 电力电子领域关注的是利用电子设备对电力进行处理[1–7].如图1.1所示,其中关键部件就是开关变换器.通常,开关变换器包含电源输入和控制输入端口以及电源输出端口.原始输入功率按控 ...
- 基于注解的springboot+mybatis的多数据源组件的实现
通常业务开发中,我们会使用到多个数据源,比如,部分数据存在mysql实例中,部分数据是在oracle数据库中,那这时候,项目基于springboot和mybatis,其实只需要配置两个数据源即可,只需 ...
- codeup 1918 简单计算器
题目描述:读入一个只包含 + ,-,×, / 的非负整数计算表达式,计算该表达式的值.输入格式:测试输入包含若干测试用例,每个测试用例占一行,每行不超过200个字符,整数和运草符之间用一个空格分隔.没 ...