
Python3数据驱动ddt
对于同一个方法执行大量数据的程序时,我们可以采用ddt数据驱动的方式,来对数据规范化整理及输出
一、需要使用python的ddt库,ddt,data,unpack方法
1、仅使用ddt和data,代码如下
import unittest

from ddt import ddt, data, unpack

test_data = (1, 2, 3)

@ddt      # 需要在要引用的类前面加上 @ddt声明

class TestAdd(unittest.TestCase):

    @data(test_data)       # 调用ddt的数据

    def test_add(self, a):

        print(a)
test_add函数那里的形参a可以随便定义,程序会自动去接收 @data里面的值
输出结果
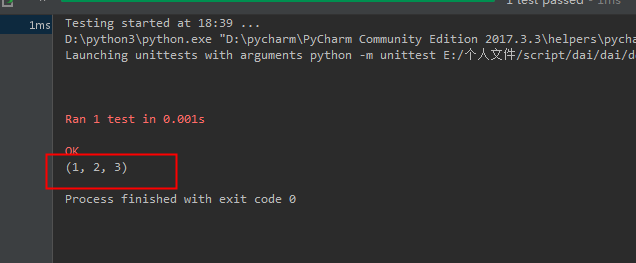
2、使用unpack功能,此方法主要是拆分数据类型,例如元组(1, 2, 3),在data下面加上 unpack后,会将数据类型拆分为
"""元组、列表数据驱动"""

import unittest

from ddt import ddt, data, unpack

test_data = ((1, 2, 3), (4, 5, 6), (7, 8, 9))

@ddt      # 需要在要引用的类前面加上 @ddt声明

class TestAdd(unittest.TestCase):

    @data(test_data)   # 调用ddt的数据

    @unpack

    def test_add(self, a, b, c):

        print('数据类型为', type(a), '数值为', a)

        print('数据类型为', type(b), '数值为', b)

        print('数据类型为', type(c), '数值为', c)
输出结果为:

会将test_data大元组拆分为,子类数值,并自动匹配数据类型。 例如将初始数据变为列表类型,并且列表里面的项未字符类型时
import unittest

from ddt import ddt, data, unpack

#test_data = ((1, 2, 3), (4, 5, 6), (7, 8, 9))

test_data = ['A', 'B', 'C']

@ddt      # 需要在要引用的类前面加上 @ddt声明

class TestAdd(unittest.TestCase):

    @data(test_data)   # 调用ddt的数据

    @unpack

    def test_add(self, a, b, c):

        print('数据类型为', type(a), '数值为', a)

        print('数据类型为', type(b), '数值为', b)

        print('数据类型为', type(c), '数值为', c)
结果如下:
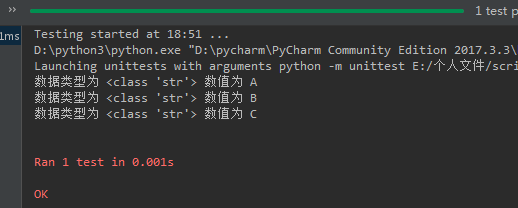
所以,ddt和data可以实现数据调用, unpack能对调用的大量数据进行拆分,得到最小等分的数据并进行使用。 注意,拆分之后的数据在函数test_data引用时,形参要和拆分的数量一致,即拆分了3个变量,那么我们调用函数的形参也必须是3个a,b,c (形参变量名不限,可以任意取,除了系统关键字)
二、对字典类型的数据进行数据驱动及拆分
字典是以键对值的形式来展示的,调用和拆分与列表、元组一样。 唯一不同点,在调用函数引用时,形参必须是字典的键值
"""字典类型数据驱动"""

import unittest

from ddt import ddt, data, unpack

test_data = {"tall": 180, "sex": "boy"}

@ddt

class TestAdd(unittest.TestCase):

    @data(test_data)

    @unpack

    def test_add(self, tall, sex):   # 此处的形参必须要是字典的键值

        print("身高是", tall, "性别是", sex)
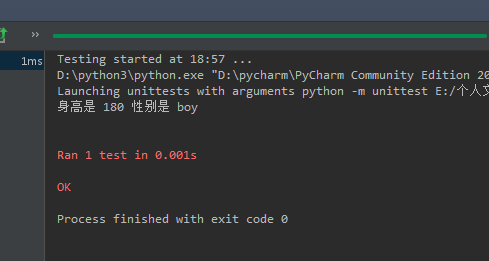
运行结果:
三、拓展使用
我们在进行数据驱动时,一般是从excel中读取数据,然后引用。 excel中的数据读取
from openpyxl import load_workbook

class ReadExcel:  # 读取Excel里面的内容

    def __init__(self, file_name, sheet_name):

        self.file_name = file_name

        self.sheet_name = sheet_name

    def get_title(self):     # 读取Excel里面的title数据

        wb = load_workbook(self.file_name)     # 打开Excel工作簿

        sheet1 = wb[self.sheet_name]

        title = []               # 定义一个空列表,将读取的title字段进行存储

        for i in range(1, sheet1.max_column+1):

            title.append(sheet1.cell(1, i).value)

        return title

    def do_excel(self):

        wb = load_workbook(self.file_name)

        sheet1 = wb[self.sheet_name]

        title = self.get_title()   # 调用title内容

        all_data = []

        for j in range(2, sheet1.max_row+1):      # 获取最大行数,加入循环

            row_data={}

            for i in range(3, sheet1.max_column+1):  # 获取最大列数,进行嵌套循环

                row_data[title[i-1]] = sheet1.cell(j, i).value  # 把拿到的数据进行字典的键对值匹配

            all_data.append(row_data)

        return all_data
然后ddt进行引用即可
Python3数据驱动ddt的更多相关文章
- python webdriver 测试框架-数据驱动DDT的例子
先在cmd环境 运行 pip install ddt 安装数据驱动ddt模块 脚本: #encoding=utf-8 from selenium import webdriver import un ...
- Python 数据驱动ddt 使用
准备工作: pip install ddt 知识点: 一,数据驱动和代码驱动: 数据驱动的意思是 根据你提供的数据来测试的 比如 ATP框架 需要excel里面的测试用例 代码驱动是必须得写代码 ...
- 数据驱动ddt
在设计用例的时候,有些用例操作过程是一样的,只是参数数据输入的不同,如果用例重复的去写操作过程会增加代码量,对于这种多组数据的测试用例,可以使用数据驱动设计模式,一组数据对应一个测试用例,用例自动加载 ...
- unittest使用数据驱动ddt
简介 ddt(data driven test)数据驱动测试:由外部数据集合来驱动测试用例,适用于测试方法不变,但需要大量变化的数据进行测试的情况,目的就是为了数据和测试步骤的分离 由于unittes ...
- Python数据驱动DDT的应用
在开始之前,我们先来明确一下什么是数据驱动,在百度百科中数据驱动的解释是:数据驱动测试,即黑盒测试(Black-box Testing),又称为功能测试,是把测试对象看作一个黑盒子.利用黑盒测试法进行 ...
- python接口自动化测试 - 数据驱动DDT模块的简单使用
DDT简单介绍 名称:Data-Driven Tests,数据驱动测试 作用:由外部数据集合来驱动测试用例的执行 核心的思想:数据和测试代码分离 应用场景:一组外部数据来执行相同的操作 优点:当测试数 ...
- unittest---unittest数据驱动(ddt)
在做测试的时候,有些地方无论是接口还是UI只是参数数据的输入不一样,操作过程是一样的.重复去写操作过程会增加代码量,我们可以通过参数化的方式解决这个问题,也叫做数据驱动,我们通过python做参数化的 ...
- python之数据驱动ddt操作(方法三)
import unittestfrom selenium import webdriverfrom selenium.webdriver.common.by import Byimport unitt ...
- python之数据驱动ddt操作(方法二)
import unittestfrom ddt import ddt,unpack,datafrom selenium import webdriverfrom selenium.webdriver. ...
随机推荐
- 快速理解类的访问控制(public,protected,private)
接触过面向对象编程的朋友们都知道类中的访问控制符无非有三个,public, protected, private. 理解他就先从期望他达到的效果先说吧 Public: 使成员对于整个程序内(类内类外) ...
- Hexo+NexT(二):Hexo站点配置详解
阅读本篇之前,假定读者已经有了Node.js的基础,如需要补充Node.js知识的,请自行百度. Hexo是在Node.js框架下的一个项目,利用Node.js提供的强大功能,完成从Markdown到 ...
- 多线程与高并发(三)synchronized关键字
上一篇中学习了线程安全相关的知识,知道了线程安全问题主要来自JMM的设计,集中在主内存和线程的工作内存而导致的内存可见性问题,及重排序导致的问题.上一篇也提到共享数据会出现可见性和竞争现象,如果多线程 ...
- php7中异常
php7中新增异常错误处理 在PHP7之前的版本,对于一些错误异常是没有办法捕获的. php7中新增throwable接口,可以用来捕获一些错误 Exception,Error这实现了Throwabl ...
- Python基础(八) 模块的引入与定义
模块定义 什么是模块:一个py文件就是一个模块 模块分为三类: 内置模块,(标准库):.python解释器自带的,time,os,sys,等等.200多种. 自定义模块:自己写的模块 第三方库(模块) ...
- Java:Web Service初入门
前言 Web Service技术在我第一次接触,又没有实际使用时完全不理解这是什么.以为是一种类似Spring,Shiro的编程框架.后来渐渐理解,WS(即Web Service缩写)是一种通用的接口 ...
- 机器学习读书笔记(七)支持向量机之线性SVM
一.SVM SVM的英文全称是Support Vector Machines,我们叫它支持向量机.支持向量机是我们用于分类的一种算法. 1 示例: 先用一个例子,来了解一下SVM 桌子上放了两种颜色的 ...
- CodeForces 696A:Lorenzo Von Matterhorn(map的用法)
http://codeforces.com/contest/697/problem/C C. Lorenzo Von Matterhorn time limit per test 1 second m ...
- [转]sublime text3在指定浏览器上本地服务器(localhost)运行文件(php)
昨天在使用sublime text3时,发现能在本地服务器上运行php文件,于是百度了一下有关知识, 终于成功了,今天总结一下. 首先要让sublime text3 出现侧边栏sidebar,不会的可 ...
- java 学习之路第一节
一.安装mysql驱动:http://mvnrepository.com/search?q=mysql-conn 二.看数据库中有什么表安装:navicat for MySQL 文件类写数据库查询: ...