
python爬取旅游数据+matplotlib简单可视化
题目如下:
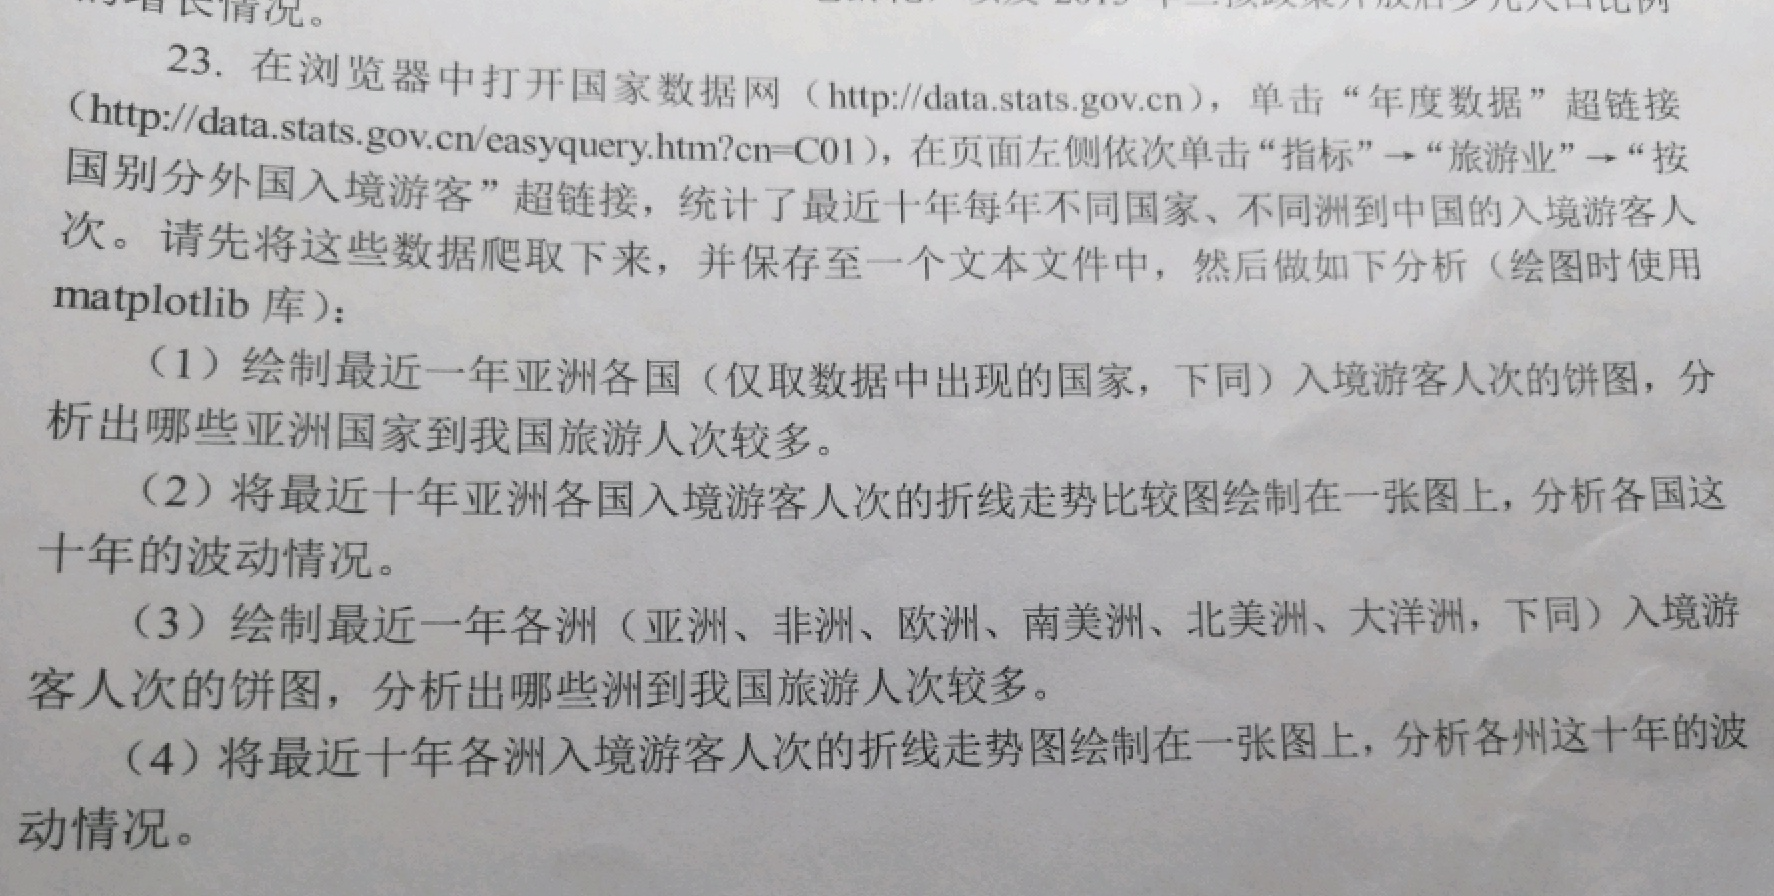
共由6个函数组成:
第一个函数爬取数据并转为DataFrame;
第二个函数爬取数据后存入Excel中,对于解题来说是多余的,仅当练手以及方便核对数据;
后面四个函数分别对应题目中的四个matplotlib图,为了看起来简洁,所有耦合较高。
下面对每个函数详细介绍
0、包导入
#!/usr/bin/env python3

# -*- coding:utf-8 -*-

import requests

import json

import openpyxl

import pandas

import matplotlib.pyplot as plt

import re
1、爬取数据并转为DataFrame
在url1中可以查到数据,由于网站是异步加载,要抓包得到url2,得到json数据。
用.text方法读取,并使用json.loads()函数转为python对象。
对数据获取和重组要结合url2的数据结构,分层拆开打印 后就可以轻松看到数据获取和重组的部分了。
最后一步pandas.DataFrame(df_dict, index=years[1:], columns=names)获取到的DataFrame列名为地区,行索引为年份,
在使用.stack().unstack(level=0)将其行列互转。
def get_data_to_df():

    """

    获取国家数据网上的旅游行业数据并转为dataframe返回

    :return: dataframe

    """

    url = "http://data.stats.gov.cn/easyquery.htm?cn=C01"  # 数据查询地址

    # json数据地址

    url2 = "http://data.stats.gov.cn/easyquery.htm?m=QueryData&dbcode=hgnd&rowcode=zb&colcode=sj&wds=%5B%5D&dfwds=%5B%7B%22wdcode%22%3A%22zb%22%2C%22valuecode%22%3A%22A0K05%22%7D%5D&k1=1571666678154&h=1"

    headers = {

        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit'

                      '/537.36 (KHTML, like Gecko) Chrome/67.0.3396.62 Safari/537.36'}

    html = requests.get(url2, headers=headers).text

    data = json.loads(html, encoding='utf-8')

    names = [i["name"] for i in data["returndata"]["wdnodes"][0]["nodes"]]

    years = [i["name"] for i in data["returndata"]["wdnodes"][1]["nodes"]]

    years.insert(0, "指标")

    df_dict = {}

    for num in range(len(names)):

        sub_data = [i["data"]["strdata"] for i in data["returndata"]["datanodes"][num * 10:num * 10 + 10]]

        sub_data.insert(0, names[num])

        df_dict[sub_data[0]] = sub_data[1:]

        # print(sub_data)

    df = pandas.DataFrame(df_dict, index=years[1:], columns=names).stack().unstack(level=0)

    return df
2、爬取数据并存入Excel
url解析部分同上。
为了简便,对excel写入数据使用append方法,所以年份作为数据的第一行,要在最前面加上一个列名,存入A1单元格。
def get_data_to_excel():

    """

    获取国家数据网上的旅游行业数据并存到data.xlsx中

    :return: .xlsx文件

    """

    # json数据地址

    url2 = "http://data.stats.gov.cn/easyquery.htm?m=QueryData&dbcode=hgnd&rowcode=zb&colcode=sj&wds=%5B%5D&dfwds=%5B%7B%22wdcode%22%3A%22zb%22%2C%22valuecode%22%3A%22A0K05%22%7D%5D&k1=1571666678154&h=1"

    headers = {

        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit'

                      '/537.36 (KHTML, like Gecko) Chrome/67.0.3396.62 Safari/537.36'}

    html = requests.get(url2, headers=headers).text

    data = json.loads(html, encoding='utf-8')

    names = [i["name"] for i in data["returndata"]["wdnodes"][0]["nodes"]]

    years = [i["name"] for i in data["returndata"]["wdnodes"][1]["nodes"]]

    years.insert(0, "指标")

    workbook = openpyxl.Workbook()

    worksheet = workbook.active

    worksheet.append(years)

    for num in range(len(names)):

        sub_data = [i["data"]["strdata"] for i in data["returndata"]["datanodes"][num * 10:num * 10 + 10]]

        sub_data.insert(0, names[num])

        worksheet.append(sub_data)

        # print(sub_data)

    workbook.save("data.xlsx")
因为下面4个图都是matplotlib的,所以直接在这里进行中文和负号乱码问题的处理
plt.rcParams['font.sans-serif'] = ['Arial Unicode MS']       # 配置语言

plt.rcParams['axes.unicode_minus'] = False    # 解决负号乱码
3、matplotlib饼图
调用get_data_to_df()得到DataFrame,然后取出2018年的一列数据,再转为dict方便数据获取。
因为DataFrame中的行索引是url上的原始数据 如“朝鲜入境游客”,而要输出的图例只是国家名,所有对countries 加上 “入境游客”来匹配DataFrame中的对应人次。
def asian_countries_pie():

    countries = ["朝鲜", "印度", "印度尼西亚", "日本", "马来西亚", "蒙古", "菲律宾", "新加坡", "韩国", "泰国"]

    df = dict(get_data_to_df()["2018年"])

    data = [df[i + "入境游客"] for i in countries]

    plt.pie(data, labels=countries)

    plt.title('2018年亚洲各国入境人次占比', fontsize=18)

    plt.show()

# asian_countries_pie()  # 图1

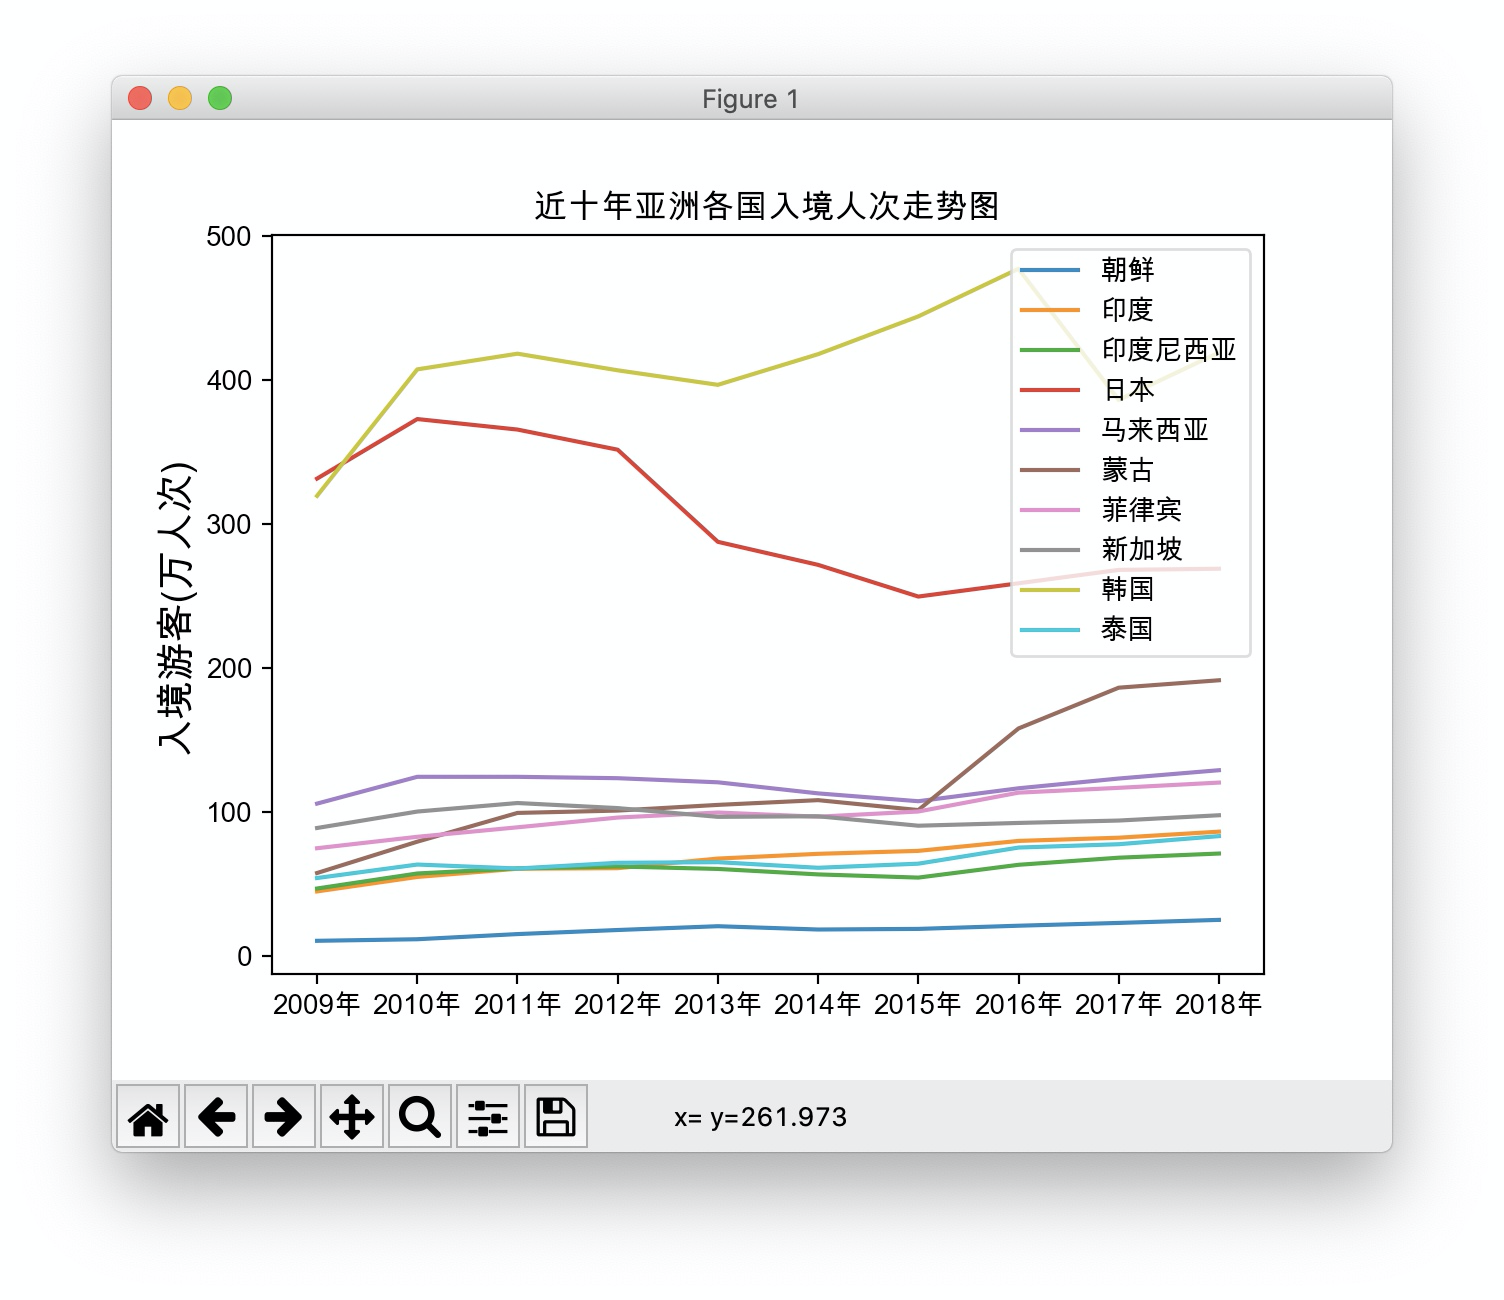
4、折线图
获取DataFrame的列名后,转为list,并反序排列,得到2009-2018正序的年份列表。
从DataFrame中获取对应的国家的10年数据,后均反序排列处理,数据要转为float才能传入matplotlib的plot中。
def asian_countries_line():

    countries = ["朝鲜", "印度", "印度尼西亚", "日本", "马来西亚", "蒙古", "菲律宾", "新加坡", "韩国", "泰国"]

    df = get_data_to_df()

    years = df.columns.values.tolist()[::-1]

    data1 = [float(i) for i in dict(df.loc[countries[0] + "入境游客"]).values()][::-1]

    data2 = [float(i) for i in dict(df.loc[countries[1] + "入境游客"]).values()][::-1]

    data3 = [float(i) for i in dict(df.loc[countries[2] + "入境游客"]).values()][::-1]

    data4 = [float(i) for i in dict(df.loc[countries[3] + "入境游客"]).values()][::-1]

    data5 = [float(i) for i in dict(df.loc[countries[4] + "入境游客"]).values()][::-1]

    data6 = [float(i) for i in dict(df.loc[countries[5] + "入境游客"]).values()][::-1]

    data7 = [float(i) for i in dict(df.loc[countries[6] + "入境游客"]).values()][::-1]

    data8 = [float(i) for i in dict(df.loc[countries[7] + "入境游客"]).values()][::-1]

    data9 = [float(i) for i in dict(df.loc[countries[8] + "入境游客"]).values()][::-1]

    data10 = [float(i) for i in dict(df.loc[countries[9] + "入境游客"]).values()][::-1]

    plt.plot(years, data1, label=countries[0])

    plt.plot(years, data2, label=countries[1])

    plt.plot(years, data3, label=countries[2])

    plt.plot(years, data4, label=countries[3])

    plt.plot(years, data5, label=countries[4])

    plt.plot(years, data6, label=countries[5])

    plt.plot(years, data7, label=countries[6])

    plt.plot(years, data8, label=countries[7])

    plt.plot(years, data9, label=countries[8])

    plt.plot(years, data10, label=countries[9])

    plt.title("近十年亚洲各国入境人次走势图")

    plt.ylabel('入境游客(万人次)', fontsize=14)  # y轴名称,字号

    plt.legend(loc='upper right')    # 这里为显示图例,并配置图例位置为右上角

    plt.show()

# asian_countries_line()  # 图2
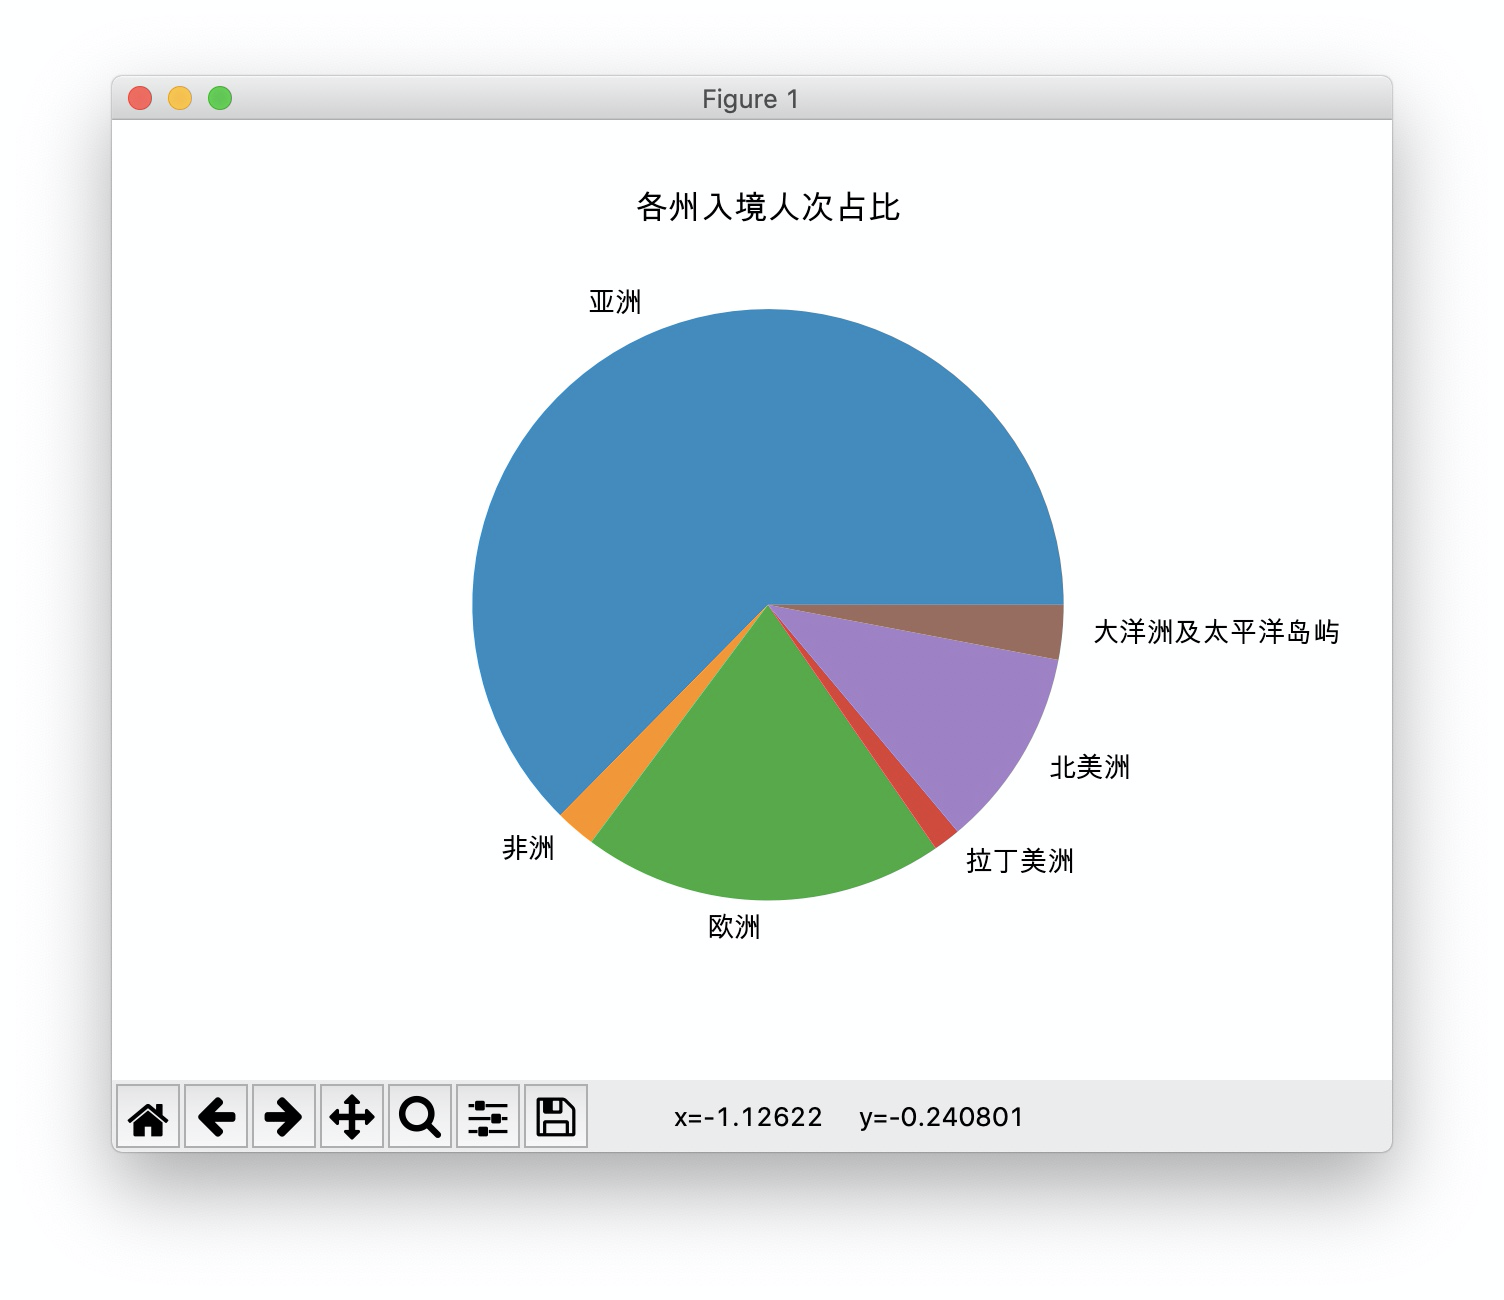
5、又是饼图
获取行索引,regions
在行索引中找到名字里带“洲”的,取得去掉后面“入境游客”四个字符的名称即洲名。
在DataFrame 2018年 一整列数据中 取得洲游客数据。
def continents_pie():

    df = get_data_to_df()

    regions = df.index.tolist()

    continents = [i[:-4] for i in regions if re.search("洲", i)]

    data = [v for k, v in df["2018年"].to_dict().items() if (k[:-4] in continents)]

    plt.pie(data, labels=continents)

    plt.title("各州入境人次占比")

    plt.show()

# continents_pie()  # 图3
6、又是折线图
获取洲名称列表同上。
本次要取各大洲的一整行数据,用到DataFrame.loc[行索引] 方法。
def continents_line():

    df = get_data_to_df()

    years = df.columns.tolist()[::-1]

    regions = df.index.tolist()

    continents = [i[:-4] for i in regions if re.search("洲", i)]

    Asia = [float(i) for i in df.loc[continents[0] + "入境游客"].to_dict().values()][::-1]

    Africa = [float(i) for i in df.loc[continents[1] + "入境游客"].to_dict().values()][::-1]

    Europe = [float(i) for i in df.loc[continents[2] + "入境游客"].to_dict().values()][::-1]

    Latin = [float(i) for i in df.loc[continents[3] + "入境游客"].to_dict().values()][::-1]

    America = [float(i) for i in df.loc[continents[4] + "入境游客"].to_dict().values()][::-1]

    Oceania = [float(i) for i in df.loc[continents[5] + "入境游客"].to_dict().values()][::-1]

    plt.plot(years, Asia, label=continents[0])

    plt.plot(years, Africa, label=continents[1])

    plt.plot(years, Europe, label=continents[2])

    plt.plot(years, Latin, label=continents[3])

    plt.plot(years, America, label=continents[4])

    plt.plot(years, Oceania, label=continents[4])

    plt.title("近十年各洲入境人次走势图")

    plt.legend(loc="upper right")

    plt.show()

continents_line()   # 图4

python爬取旅游数据+matplotlib简单可视化的更多相关文章
- 如何使用Python爬取基金数据,并可视化显示
本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理 以下文章来源于Will的大食堂,作者打饭大叔 前言 美国疫情越来越严峻,大选也进入 ...
- 利用Python爬取疫情数据并使用可视化工具展示
import requests, json from pyecharts.charts import Map, Page, Pie, Bar from pyecharts import options ...
- 毕设之Python爬取天气数据及可视化分析
写在前面的一些P话:(https://jq.qq.com/?_wv=1027&k=RFkfeU8j) 天气预报我们每天都会关注,我们可以根据未来的天气增减衣物.安排出行,每天的气温.风速风向. ...
- python爬取拉勾网数据并进行数据可视化
爬取拉勾网关于python职位相关的数据信息,并将爬取的数据已csv各式存入文件,然后对csv文件相关字段的数据进行清洗,并对数据可视化展示,包括柱状图展示.直方图展示.词云展示等并根据可视化的数据做 ...
- 用Python爬取股票数据,绘制K线和均线并用机器学习预测股价(来自我出的书)
最近我出了一本书,<基于股票大数据分析的Python入门实战 视频教学版>,京东链接:https://item.jd.com/69241653952.html,在其中用股票范例讲述Pyth ...
- python爬取网站数据
开学前接了一个任务,内容是从网上爬取特定属性的数据.正好之前学了python,练练手. 编码问题 因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这个机会算是彻底搞清楚了. 问题要从文字的编码讲 ...
- Python爬取房产数据,在地图上展现!
小伙伴,我又来了,这次我们写的是用python爬虫爬取乌鲁木齐的房产数据并展示在地图上,地图工具我用的是 BDP个人版-免费在线数据分析软件,数据可视化软件 ,这个可以导入csv或者excel数据. ...
- python爬取网站数据保存使用的方法
这篇文章主要介绍了使用Python从网上爬取特定属性数据保存的方法,其中解决了编码问题和如何使用正则匹配数据的方法,详情看下文 编码问题因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这 ...
- Python爬取股票信息,并实现可视化数据
前言 截止2019年年底我国股票投资者数量为15975.24万户, 如此多的股民热衷于炒股,首先抛开炒股技术不说, 那么多股票数据是不是非常难找, 找到之后是不是看着密密麻麻的数据是不是头都大了? 今 ...
随机推荐
- JS实现数组去重的方法
1.使用ES6的Set进行去重 <!DOCTYPE html> <html> <head> <meta charset="UTF-8"&g ...
- scrapy和scrapy-redis的区别
scrapy是一个python爬虫框架,爬取的效率极高,具有高度的定制性,但是不支持分布式.而scrapy-redis是一套基于redis库,运行在scrapy框架之上的组件,可以让scapy支持分布 ...
- 【面试题】Java常见面试题
集合与数组? 数组:(可以存储基本数据类型)是用来存储对象的一种容器,但是数组的长度固定,不适合在对象数量未知的情况下使用 集合:(只能存储对象,对象类型可以不一样)集合的长度可变,可在多数情况下使用 ...
- Python学习笔记整理总结【网络编程】【线程/进程/协程/IO多路模型/select/poll/epoll/selector】
一.socket(单链接) 1.socket:应用层与TCP/IP协议族通信的中间软件抽象层,它是一组接口.在设计模式中,Socket其实就是一个门面模式,它把复杂的TCP/IP协议族隐藏在Socke ...
- 使用tomcat7发布war项目启动org_apache_tomcat_websocket报错
在使用tomcat7发布项目时(项目是用springboot 2.1.4.RELEASE版本开发的) 换成tomcat8就可以正常发布了,网上说tomcat7不支持servlet3.1,升级到spri ...
- Idea 配置Jrebel热部署
虽说Idea自带热更新功能,但是一旦mapper更改,则不能及时更新,影响开发效率. 接下来,我们来配置Jrebel热更新,简单方便实用. 第一步:进入插件下载页面. 第二步:安装jrebel插件. ...
- 【爬虫小程序:爬取斗鱼所有房间信息】Xpath(线程池版)
# 本程序亲测有效,用于理解爬虫相关的基础知识,不足之处希望大家批评指正 from queue import Queue import requests from lxml import etree ...
- 07-简单认识margin
margin 外边距,表示边框到最近盒子的距离. 对于左右两边 <!DOCTYPE html> <html lang="en"> <head> ...
- 数据库系统概论——SQL
[toc] 一.SQL查询语言概览 视图 从一个或几个基本表导出的表 数据库中只存放视图的定义而不存放视图对应的数据 视图是一个虚表 用户可以在视图上再定义视图 基本表 本身独立存在的表 SQL中一个 ...
- MongoDB 学习笔记之 索引
索引: db.media.createIndex({"Tracklist": 1}) 1表示升序 -1表示降序 我们要着重看一下对数组创建索引的情况. 构建一个集合:db.medi ...