
python爬取豆瓣视频信息代码
这里是爬取豆瓣视频信息,用pyquery库(jquery的python库)。
一:代码
from urllib.request import quote

from pyquery import PyQuery as pq

import requests

import pandas as pd

def get_text_page(movie_name):

	'''

	函数功能:获得指定电影名的源代码

	参数:电影名

	返回值:电影名结果的源代码

	'''

	url = 'https://www.douban.com/search?q=' + movie_name

	headers = {

		'Host' : 'www.douban.com',

		'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.90 Safari/537.36',

	}

	r = requests.get(url,headers = headers,timeout=5)

	return r.text

def get_last_url(this_text):

	'''

	函数功能:根据指定的源代码得到最终的网页地址

	参数:搜索结果源代码

	返回值:最终的网页地址

	'''

	doc = pq(this_text)

	lis = doc('.title a').items()

	k = 0

	this_str = ''

	for i in lis:

		# print('豆瓣搜索结果为:{0}'.format(i.text()))

		# print('地址为:{0}'.format(i.attr.href))

		# print('\n')

		if k == 0:

			this_str = i.attr.href

		k += 1

	return this_str

def the_last_page(this_url):

	'''

	函数功能:获得最终电影网页的源代码

	参数:最终的地址

	返回值:最终电影网页的源代码

	'''

	headers = {

		'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.90 Safari/537.36',

	}

	r = requests.get(this_url,headers = headers,timeout=20)

	return r.text

def the_last_text(this_text,movie_name):

	'''

	函数功能:获得每一项的数据

	参数:爬取页面的源代码

	返回值:返回空

	'''

	doc = pq(this_text)

	# 获取标题

	title = doc('#content h1').text()

	# 获取海报

	photo = doc('.nbgnbg img')

	photo_url = photo.attr.src

	r = requests.get(photo_url)

	with open('{m}.jpg'.format(m = movie_name),'wb') as f:

		f.write(r.content)

	# 电影信息

	message = doc('#info').text()

	# 豆瓣评分

	grade = doc('#interest_sectl').text()

	# 剧情

	things = doc('.related-info').text()

	with open('{0}.txt'.format(movie_name),'w+') as f:

		try:

			f.writelines([title,'\n','\n\n',message,'\n\n',grade,'\n\n',things])

		except:

			f.writelines([title,'\n','\n\n',message,'\n\n',grade])

	# 演员

	# 演员名

	name = []

	person_name  = doc('.info').items()

	for i in person_name:

		name.append(i.text())

	# 演员图片地址

	person_photo = doc('#celebrities')

	j = 0

	for i in person_photo .find('.avatar').items():

		m = i.attr('style')

		person_download_url = m[m.find('(') + 1:m.find(')')]

		# 下载演员地址

		r = requests.get(person_download_url)

		try:

			with open('{name}.jpg'.format(name = name[j]),'wb') as f:

				f.write(r.content)

		except:

			continue

		j += 1

def lookUrl(this_text,my_str):

	'''

	函数功能:获得观看链接

	参数:爬取页面的源代码

	返回值:返回空

	'''

	doc = pq(this_text)

	all_url = doc('.bs li a').items()

	movie_f   = []

	movie_url = []

	for i in all_url:

		movie_f.append(i.text())

		movie_url.append(i.attr.href)

	dataframe = pd.DataFrame({'观看平台':movie_f,'观看地址':movie_url})

	dataframe.to_csv("{movie_name}的观看地址.csv".format(movie_name = my_str),index=False,encoding = 'utf_8_sig',sep=',')

def main():

	name = input('')

	my_str = name

	movie_name = quote(my_str)

	page_text = get_text_page(movie_name)	# 得指定电影名的源代码

	last_url = get_last_url(page_text)		# 根据指定的源代码得到最终的网页地址

	page_text2 = the_last_page(last_url)	# 获得最终电影网页的源代码

	the_last_text(page_text2,my_str)		# 获得每一项的数据

	lookUrl(page_text2,my_str)				# 得到并处理观看链接

main()
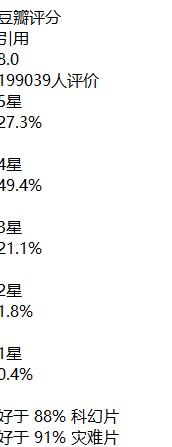
二:结果如下(部分例子)
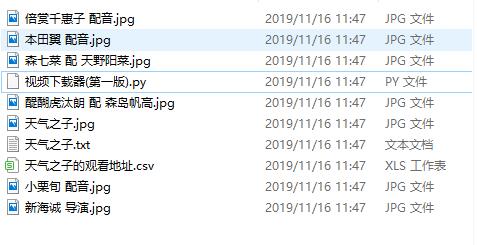
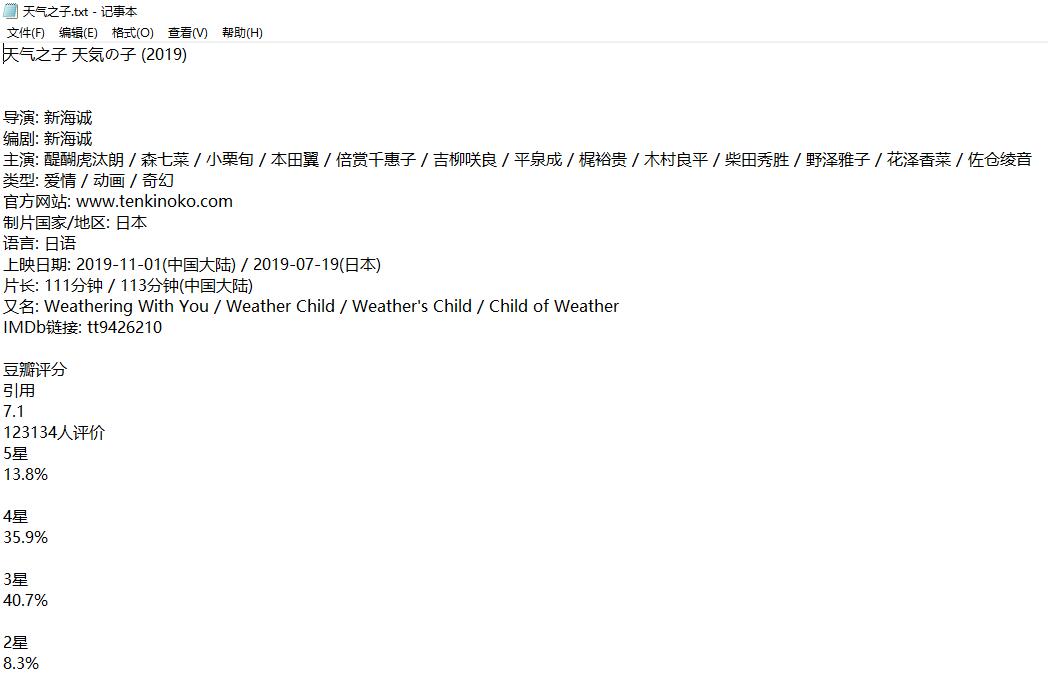
1.输入天气之子

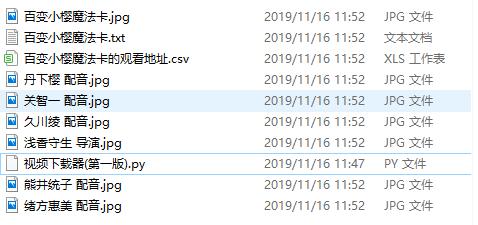
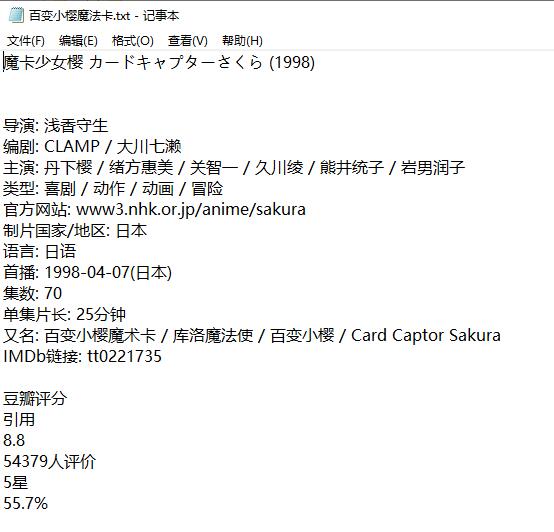
2.输入百变小樱魔法卡
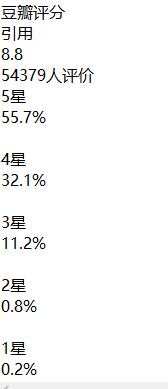
必须是已经上映的电影才有观看地址
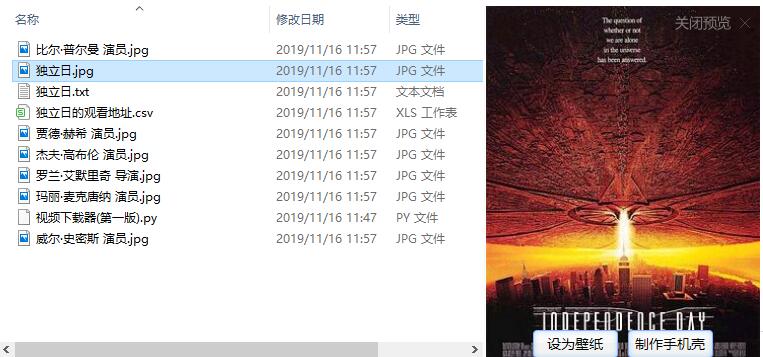
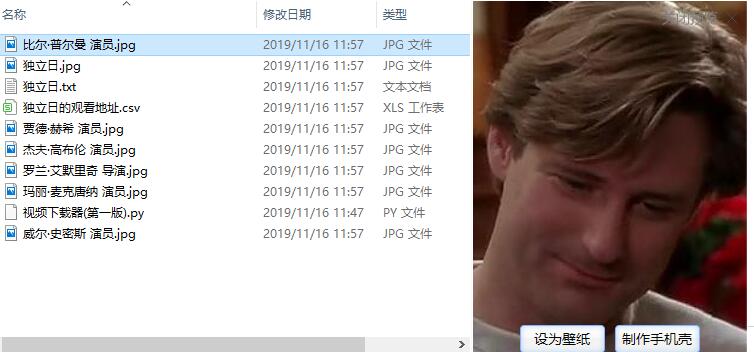
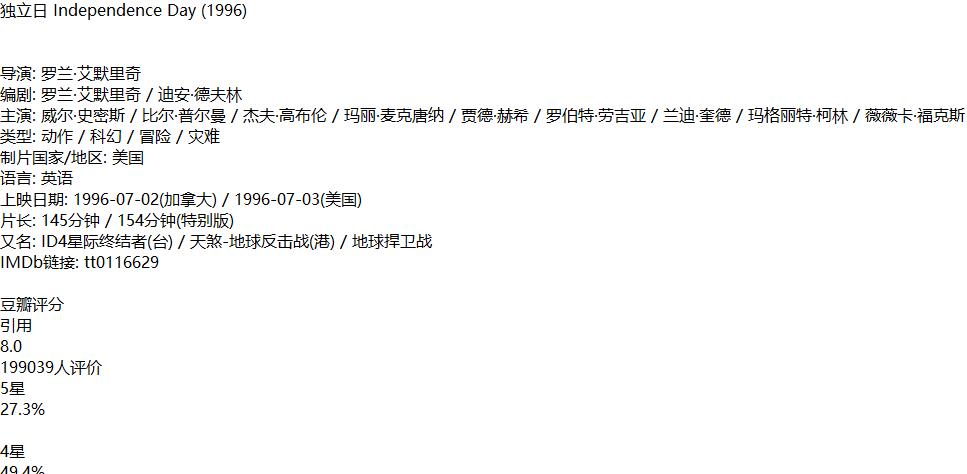
3.独立日

python爬取豆瓣视频信息代码的更多相关文章
- python 爬取豆瓣书籍信息
继爬取 猫眼电影TOP100榜单 之后,再来爬一下豆瓣的书籍信息(主要是书的信息,评分及占比,评论并未爬取).原创,转载请联系我. 需求:爬取豆瓣某类型标签下的所有书籍的详细信息及评分 语言:pyth ...
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
- python 爬取bilibili 视频信息
抓包时发现子菜单请求数据时一般需要rid,但的确存在一些如游戏->游戏赛事不使用rid,对于这种未进行处理,此外rid一般在主菜单的响应中,但有的如番剧这种,rid在子菜单的url中,此外返回的 ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- python爬取网页的通用代码框架
python爬取网页的通用代码框架: def getHTMLText(url):#参数code缺省值为‘utf-8’(编码方式) try: r=requests.get(url,timeout=30) ...
- Python爬取豆瓣《复仇者联盟3》评论并生成乖萌的格鲁特
代码地址如下:http://www.demodashi.com/demo/13257.html 1. 需求说明 本项目基于Python爬虫,爬取豆瓣电影上关于复仇者联盟3的所有影评,并保存至本地文件. ...
- Python爬取豆瓣电影top
Python爬取豆瓣电影top250 下面以四种方法去解析数据,前面三种以插件库来解析,第四种以正则表达式去解析. xpath pyquery beaufifulsoup re 爬取信息:名称 评分 ...
- Python爬取豆瓣指定书籍的短评
Python爬取豆瓣指定书籍的短评 #!/usr/bin/python # coding=utf-8 import re import sys import time import random im ...
- 零基础爬虫----python爬取豆瓣电影top250的信息(转)
今天利用xpath写了一个小爬虫,比较适合一些爬虫新手来学习.话不多说,开始今天的正题,我会利用一个案例来介绍下xpath如何对网页进行解析的,以及如何对信息进行提取的. python环境:pytho ...
随机推荐
- 合格的施工图是如何绘制的?必须要get这四点,大多数人都不知道
对于工程设计师来说加班通宵赶图改图是常有的事情,如何绘制一套合格的施工图?这是很多工程设计师都会问的问题. 绘制一套合格的施工图,你需要注意以下四点: 一.明确施工图的作用和目的 1. 工程设计的细化 ...
- 高强度学习训练第九天总结:5道剑指offer的题目
实在不想看JVM了.刷几道剑指Offer的题,今天就水一水吧,脑子迷糊. 1.二维数组中的查找 在一个二维数组中(每个一维数组的长度相同),每一行都按照从左到右递增的顺序排序,每一列都按照从上到下递增 ...
- JavaScript之找LHS查询和RHS查询
LHS和RHS,当变量出现在赋值操作的左侧时进行LHS 查询,出现在右侧时进行RHS 查询. LHS 查询是试图找到变量的容器本身,从而可以对其赋值. RHS 理解成retrieve his sour ...
- [转]Outlook API
本文转自:https://www.cnblogs.com/yl153/p/6711519.html 1.Outlook简介 若要从Outlook 外控制Outlook对象,必须在编写代码的工程中建立对 ...
- linux 添加用户并设置主目录,shell 并赋予权限 (以 fedora 和 ubuntu 为例)
环境 centos 7.6 添加用户: [root@localhost ~]# useradd -d /home/yaoxu -m -s /bin/bash yaoxu 更改用户密码: passwd ...
- luoguP4343自动刷题机(二分标准题)
https://www.luogu.org/problem/P4343 参考博客:https://www.luogu.org/blog/ofnoname/solution-p4343 这真是一语点醒梦 ...
- 在安装完jdk以后,发现javac不能执行
安装和配置环境变量都按着流程在,但在最后的检验时,发现Java Java -version 都能运行,唯独Javac 报“不能识别命令”错误信息,下面列出我遇到一个尴尬问题 在path变量里
- Centos的启动流程学习
Centos 6 的启动流程: POST ---> Boot sequence(BOIS) ---> Boot loader (MBR) ---> kernel(ramdiskfs ...
- leetcode 树类问题
208. Implement Trie (Prefix Tree) 子节点个数对应的是数组
- arXiv网站
arXiv 原先是由物理学家保罗·金斯巴格在1991年建立的网站, 我们会将预稿上传到arvix作为预收录,因此这就是个可以证明论文原创性(上传时间戳)的文档收录网站.